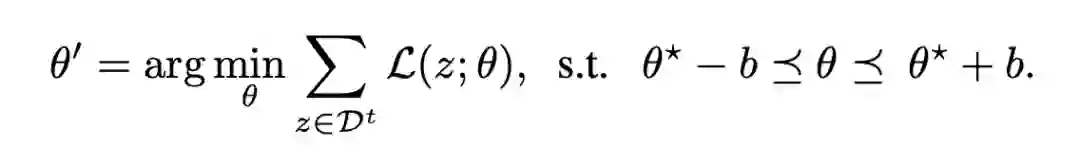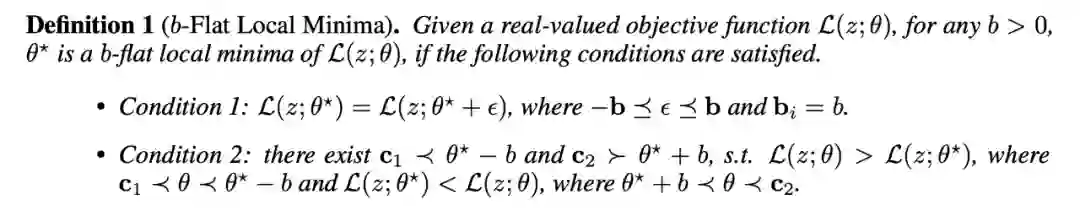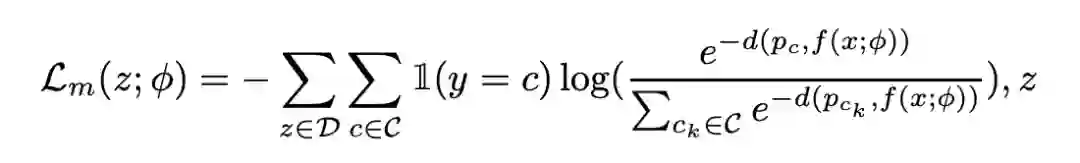NeurIPS 2021 | 通过寻找平坦最小值,克服小样本增量学习中的灾难性遗忘
2022 年 1 月 25 日 PaperWeekly


©作者 | FlyingBug

单位 | 哈尔滨工业大学(深圳)

研究方向 | 小样本学习


写在篇首


本文分享的这篇论文是 NeurIPS 2021的一篇 Few-Shot 增量学习 (FSCIL) 文章,这篇文章通过固定 backbone 和 prototype 得到一个简单的 baseline,发现这个 baseline 已经可以打败当前 IL 和 IFSL 的很多 SOTA 方法,基于此通过借鉴 robust optimize 的方法,提出了在 base training 训练时通过 flat local minima 来对后面的 session 进行 fine-tune novel classes,解决灾难性遗忘问题。


论文标题:
Overcoming Catastrophic Forgetting in Incremental Few-Shot Learning by Finding Flat Minima

收录会议:

NeurIPS 2021

论文链接:

https://arxiv.org/pdf/2111.01549.pdf

代码链接:

https://github.com/moukamisama/F2M


Motivation

不同于现有方法在学习新任务时尝试克服灾难性遗忘问题,这篇文章提出在训练 base classes 时就提出策略来解决这个问题。作者提出找到 base training function 的 flat local minima,最小值附近 loss 小,作者认为 base classes 分离地更好(直觉上,flat local minima 会比 sharp 的泛化效果更好,参阅下图 [2])。

1.2 Contribution

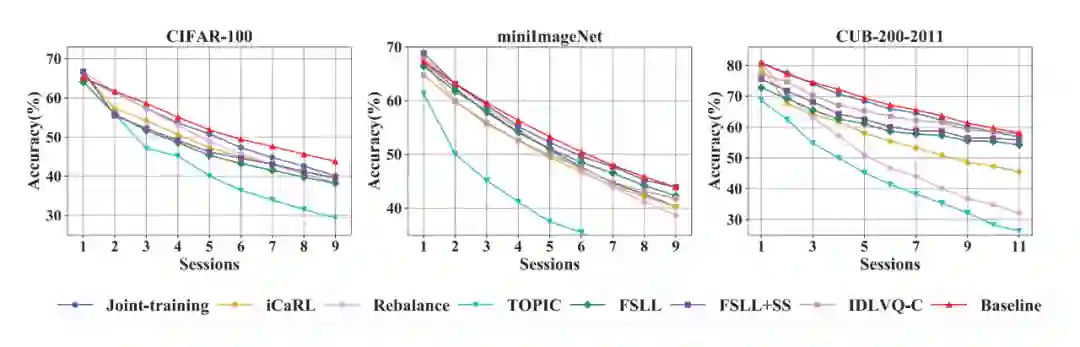
作者发现一个简单的 baseline model,只要在 base classes 上训练,不在 new tasks 上进行适应,就超过了现有的 SOTA 方法,说明灾难性遗忘问题非常严重。作者提出在 primitive stage 来解决灾难性遗忘问题,通过在 base classes 上训练时找到 flat minima region 并在该 region 内学习新任务,模型能够更好地克服遗忘问题。

1.3 A Simple Baseline 

作者提出了一个简单的 baseline,模型只在 base classes 上进行训练,在后续的 session 上直接进行推理。
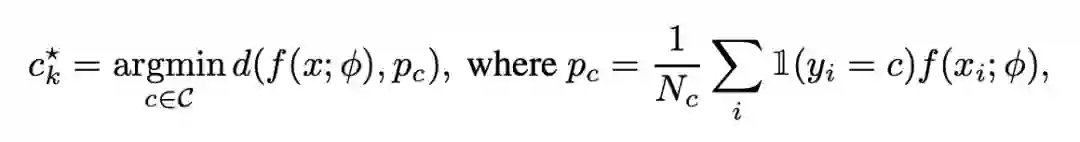
Training(t=1)
在session 1上对特征提取器进行训练,并使用一个全连接层作为分类器,使用 CE Loss 作为损失函数,从session 2 ( ) 开始将特征提取器固定住,不使用 novel classes 进行任何 fine-tune 操作。
Inference(test)
使用均值方式获得每个类的 prototype,然后通过欧氏距离 采用最近邻方式进行分类。分类器的公式如下:


其中 表示类别 的 prototype, 表示类别 的训练图片数量。同时作者将 中所有类的 prototypes 保存下来用于后续的 evaluation。
作者表示通过这种保存 old prototype 的方式就打败了现有的 SOTA 方法,证明了灾难性遗忘非常严重。

1.4 Method

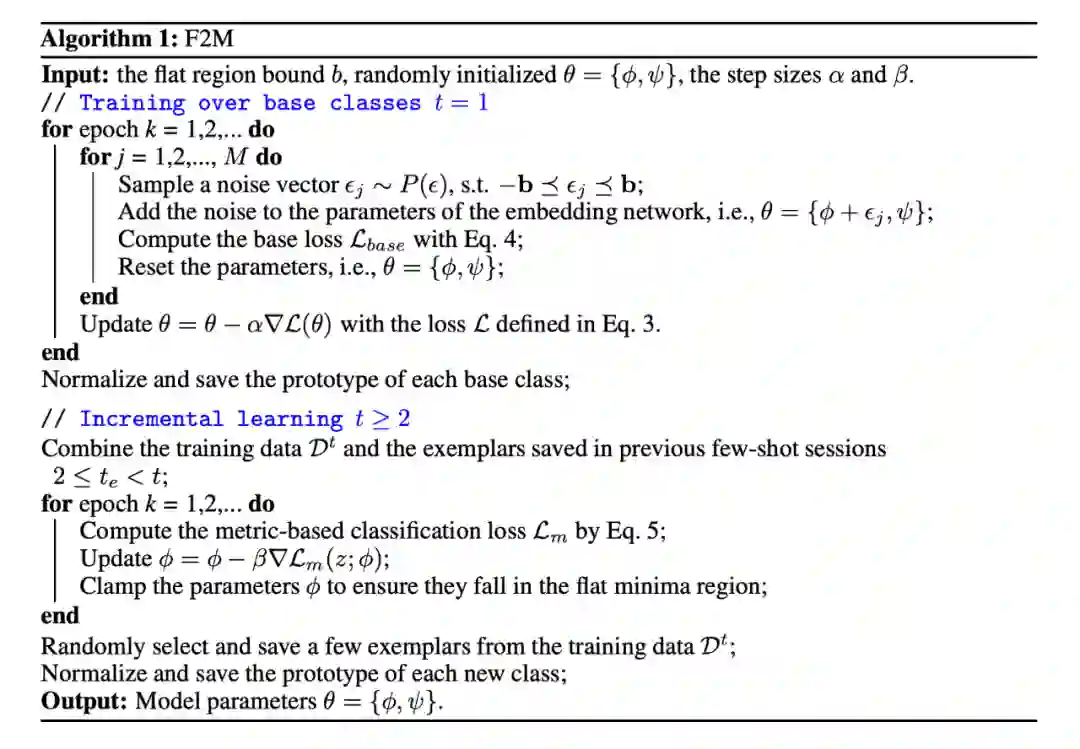
核心想法就是在 base training 的过程中找到函数的 flat local minima ,并在后续的 few-shot session 中在 flat region 进行 fine-tune,这样可以最大限度地保证在 novel classes 上进行 fine-tune 时避免遗忘知识。在后续增量 few-shot sessions ( ) 中,在这个 flat region 进行 fine-tune 模型参数来学习 new classes。

1.4.1 寻找Base Training的flat local minima

为了找到 base training function 的近似 flat local minima,作者提出添加一些随机噪声到模型参数,噪声可以被多次添加以获得相似但不同的 loss function,直觉上,flat local minima 附近的参数向量有小的函数值。
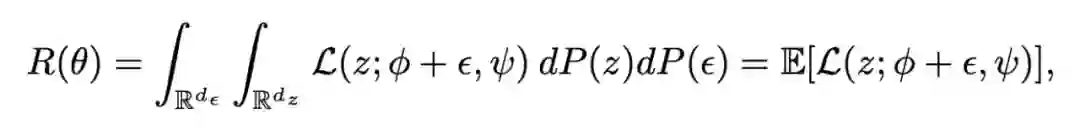
假设模型的参数 , 表示特征提取网络的参数, 表示分类器的参数。 表示一个有类标训练样本,损失函数 。我们的目标就是最小化期望损失函数。


 是数据分布 是噪声分布, 和 是相互独立的。

因此最小化期望损失是不可能的,所以这里我们最小化他的近似,empirical loss:
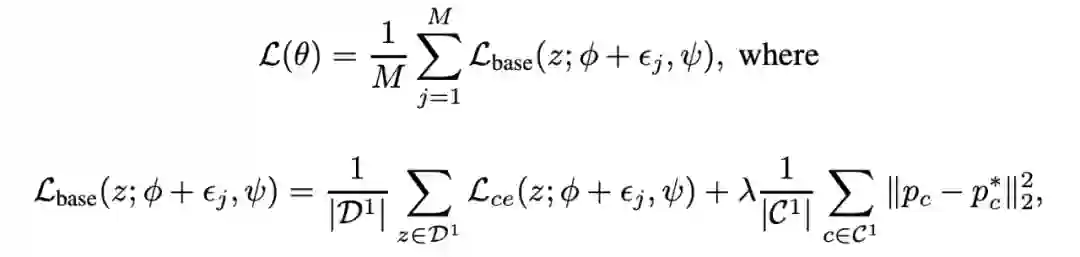

 是 , 是采样次数。这个 loss 的前半部分是为了找到 flat region,它的特征提取网络参数 可以很好地区分 base classes。第二部分是通过 MSE Loss 的设计为了让 prototype 尽量保持不变, 避免模型遗忘过去的知识。

1.4.2 在Flat Region内进行IFSL 

作者认为虽然 flat region 很小,但对于 few-shot 的少量样本来说,足够对模型进行迭代更新。


通过欧氏距离使用基于度量的分类算法来 fine-tune 模型参数。

1.4.3 收敛性分析 

我们的目标是找到一个 flat region 使模型效果较好。然后,通过最小化期望损失(噪声 和数据 的联合分布)。为了近似这个期望损失,我们在每次迭代中多次从 采样,并使用随机梯度下降 (SGD) 优化目标函数。后面是相关的理论证明,感兴趣的可以自行阅读分析。


参考文献

[1] Shi G, Chen J, Zhang W, et al. Overcoming Catastrophic Forgetting in Incremental Few-Shot Learning by Finding Flat Minima[J]. Advances in Neural Information Processing Systems, 2021, 34. 

[2] He H, Huang G, Yuan Y. Asymmetric valleys: Beyond sharp and flat local minima[J]. arXiv preprint arXiv:1902.00744, 2019.


更多阅读


#投 稿 通 道#

 让你的文字被更多人看到 


如何才能让更多的优质内容以更短路径到达读者群体,缩短读者寻找优质内容的成本呢?答案就是:你不认识的人。


总有一些你不认识的人,知道你想知道的东西。PaperWeekly 或许可以成为一座桥梁,促使不同背景、不同方向的学者和学术灵感相互碰撞,迸发出更多的可能性。 


PaperWeekly 鼓励高校实验室或个人,在我们的平台上分享各类优质内容,可以是最新论文解读,也可以是学术热点剖析、科研心得或竞赛经验讲解等。我们的目的只有一个,让知识真正流动起来。


📝 稿件基本要求:

• 文章确系个人原创作品,未曾在公开渠道发表,如为其他平台已发表或待发表的文章,请明确标注 

• 稿件建议以 markdown 格式撰写,文中配图以附件形式发送,要求图片清晰,无版权问题

• PaperWeekly 尊重原作者署名权,并将为每篇被采纳的原创首发稿件,提供业内具有竞争力稿酬,具体依据文章阅读量和文章质量阶梯制结算


📬 投稿通道:

• 投稿邮箱:[email protected] 

• 来稿请备注即时联系方式(微信),以便我们在稿件选用的第一时间联系作者

• 您也可以直接添加小编微信(pwbot02)快速投稿,备注:姓名-投稿

△长按添加PaperWeekly小编


🔍


现在,在「知乎」也能找到我们了

进入知乎首页搜索「PaperWeekly」

点击「关注」订阅我们的专栏吧


·

登录查看更多
2

相关内容

WWW2022 | 迷途知返:分布迁移下的图神经网络自训练方法
专知会员服务
17+阅读 · 2022年2月19日
NeurIPS 2021 | 寻MixTraining: 一种全新的物体检测训练范式
专知会员服务
12+阅读 · 2021年12月9日
专知会员服务
23+阅读 · 2021年9月30日
专知会员服务
19+阅读 · 2021年8月15日
【NeurIPS 2020】基于因果干预的小样本学习
专知会员服务
70+阅读 · 2020年10月6日
专知会员服务
51+阅读 · 2020年7月16日
【ICML 2020 】小样本学习即领域迁移
专知会员服务
78+阅读 · 2020年6月26日
专知会员服务
112+阅读 · 2020年6月26日
【CVPR2020】用多样性最大化克服单样本NAS中的多模型遗忘
2202年了,“小样本”还值得卷吗?
夕小瑶的卖萌屋
1+阅读 · 2022年1月11日
【CVPR 2020 Oral】小样本类增量学习
专知
20+阅读 · 2020年6月26日
国家自然科学基金
0+阅读 · 2015年12月31日
国家自然科学基金
2+阅读 · 2015年12月31日
国家自然科学基金
12+阅读 · 2015年12月31日
国家自然科学基金
0+阅读 · 2014年12月31日
国家自然科学基金
1+阅读 · 2013年12月31日
国家自然科学基金
5+阅读 · 2013年12月31日
国家自然科学基金
0+阅读 · 2013年12月31日
国家自然科学基金
0+阅读 · 2012年12月31日
Arxiv
13+阅读 · 2022年1月20日
Attentive Graph Neural Networks for Few-Shot Learning
Arxiv
40+阅读 · 2020年7月14日
Arxiv
15+阅读 · 2019年11月26日
Few-shot Learning: A Survey
Arxiv
364+阅读 · 2019年4月10日
Learning Embedding Adaptation for Few-Shot Learning
Arxiv
17+阅读 · 2018年12月10日
VIP会员
最新内容
《衡量语言模型中的作战规划能力》
专知会员服务
9+阅读 · 10月20日
Maven智能系统:帕兰提尔军事人工智能平台详解
专知会员服务
9+阅读 · 10月20日
《测试自动化框架在敏捷软件开发中的角色》
专知会员服务
7+阅读 · 10月20日
俄罗斯如何拦截乌克兰无人机与巡航导弹
专知会员服务
11+阅读 · 10月15日
《武器-目标分配问题:精确与近似求解算法》
专知会员服务
15+阅读 · 10月15日
现代电磁战:集成式系统簇时代如何实现频谱优势
综述|谁来改进机器人?迈向物理递归自我改进
专知会员服务
11+阅读 · 10月14日
软件定义无人机蜂群给防空带来全新压力
专知会员服务
10+阅读 · 10月13日
相关VIP内容
WWW2022 | 迷途知返:分布迁移下的图神经网络自训练方法
专知会员服务
17+阅读 · 2022年2月19日
NeurIPS 2021 | 寻MixTraining: 一种全新的物体检测训练范式
专知会员服务
12+阅读 · 2021年12月9日
专知会员服务
23+阅读 · 2021年9月30日
专知会员服务
19+阅读 · 2021年8月15日
【NeurIPS 2020】基于因果干预的小样本学习
专知会员服务
70+阅读 · 2020年10月6日
专知会员服务
51+阅读 · 2020年7月16日
【ICML 2020 】小样本学习即领域迁移
专知会员服务
78+阅读 · 2020年6月26日
专知会员服务
112+阅读 · 2020年6月26日
【CVPR2020】用多样性最大化克服单样本NAS中的多模型遗忘
相关基金
国家自然科学基金
0+阅读 · 2015年12月31日
国家自然科学基金
2+阅读 · 2015年12月31日
国家自然科学基金
12+阅读 · 2015年12月31日
国家自然科学基金
0+阅读 · 2014年12月31日
国家自然科学基金
1+阅读 · 2013年12月31日
国家自然科学基金
5+阅读 · 2013年12月31日
国家自然科学基金
0+阅读 · 2013年12月31日
国家自然科学基金
0+阅读 · 2012年12月31日
相关论文
Arxiv
13+阅读 · 2022年1月20日
Attentive Graph Neural Networks for Few-Shot Learning
Arxiv
40+阅读 · 2020年7月14日
Arxiv
15+阅读 · 2019年11月26日
Few-shot Learning: A Survey
Arxiv
364+阅读 · 2019年4月10日
Learning Embedding Adaptation for Few-Shot Learning
Arxiv
17+阅读 · 2018年12月10日
Top
微信扫码咨询专知VIP会员