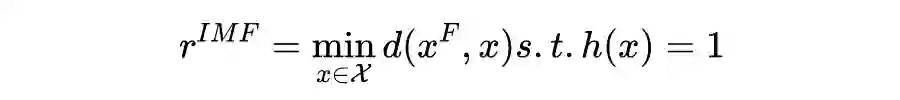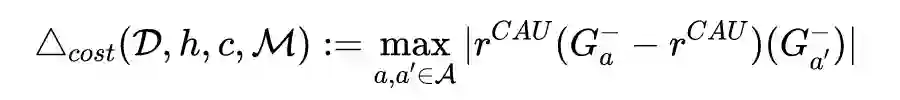
如何将因果干预用于提升模型公平性?

2021 年 10 月 22 日 PaperWeekly


©PaperWeekly 原创 · 作者 | 张一帆

学校 | 中科院自动化所博士生

研究方向 | 计算机视觉

近期因果推理相关研究荣获诺贝尔经济学奖,本文通过三篇文章简单介绍一下 Causal Algorithmic Recourse 这个任务以及近期的进展。首先我们来介绍一下问题的背景,令 代表可观测特征, 代表受保护属性,可以简单理解为多个 domain, 是 domain label。一个二分类器 预测数据标签 。我们能观察到的只有数据集 。


Algorithmic fairness

Algorithmic fairness 作为一个更大众也是被研究更多的任务,发现和纠正自动化决策系统潜在的歧视性行为。给定一个数据集,该数据集包含来多个群体(例如,根据年龄、性别或种族定义)的个人,以及经过训练以进行决策的二元分类器(例如,这些人是否被批准使用信用卡)。

一个直观的例子是,如果我们的训练数据存在一些年龄的歧视。日常生活中老年人可能更小概率被批准使用,所以我们的数据隐含着这种先验,因此最后分类器可能也会被个体的年龄所误导。但是真实情况是,我们并不希望分类器被这些保护属性,而是希望它尽可能公平(fairness),即只根据财政状况本身进行分类。
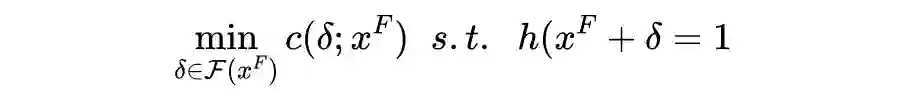
大多数实现算法公平的方法都试图根据一些预先定义的(统计或因果)标准量化不公平的程度,然后通过改变分类器来纠正它。这种预测公平性的概念通常认为数据集是固定的,因此个体是不可改变的。


Algorithmic Recourse
Algorithmic Recourse 与 fairness 的目的相同,都是为了更加公平,但是手段不同。Recourse 顾名思义,是为那些被决策系统不利对待的人提供建议,以克服他们的不利处境,是通过修改数据来改变 unfairness 的手段。对于给定的分类器和错误分类的个体,Algorithmic Recourse 的目的是识别个体可以执行哪些改变来翻转决策。与 Algorithmic fairness 相反,recourse 认为分类器是固定的,但是个人本身可以采取行动。一句话,recourse 指的是通过改变变量的值来影响模型预测结果的能力,公式化为:

这里的 是一组可行的变化向量, 是定义在这一组行为上的花费函数,这二者都取决于单个样本本身。这样独立的对变量进行操作是有一定问题的,我们称这个假设为 independently-manipulable features(IMF),只有当被操作变量对其他变量没有的影响时,这种操作才是合理的。但是我们知道,特征之间往往是有一定的因果关系的,如何刻画这种关系呢?下文给出了答案。

论文标题:

Algorithmic Recourse: from Counterfactual Explanations to Interventions

论文链接:

https://arxiv.org/abs/2002.06278

这篇文章提出了 causal recourse,主要的改进在于:

1. 提出将 recourse 的问题在 SCM(结构化因果模型)的框架下进行处理;

2. 在传统的 recourse 中,我们关注的是距离 最近的那个正例样本,而在 causal recourse 中,我们关注最小干预。
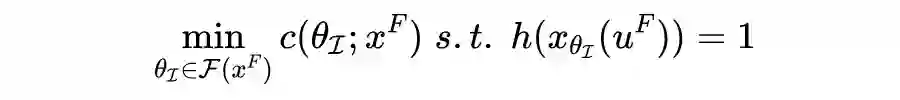
将优化问题重写为:

被称之为 的“counterfactual twin”,即我们做干预 之后得到的变量。
这里简单介绍一下变量含义以及因果图的基础定义。一个 SCM 就是一个 DAG(有向无环图),可观测变量记为 ,这些变量是由一系列结构方程生成的 , 是 的父节点,即对 有直接因果关系的因子, 可以看作是影响 的噪声因子(称为外生变量),不可观测。
引入 SCM 的一个重要目的是研究干预,即将因果图中的某个节点置为定值,观察其他节点的变化(与上述 IMF 不同,IMF 影响单个因子其余因子不变)。我们记作 ,简记为 。那么干预的过程是怎样的呢,首先我们把选中的 给一个固定值,然后使用这些新值重新计算出 SCM 中的状态,也就是说比起传统的 recourse 而言,这里只是多了一步通过 SCM 中的因果关系更新其他状态的值而已。


Equalizing Recourse across Groups

论文标题:

Equalizing Recourse across Groups

论文链接:

https://arxiv.org/abs/1909.03166

基础的 recourse 测量的是单个样本,本文给出了一个 group 级别的 recourse 度量。

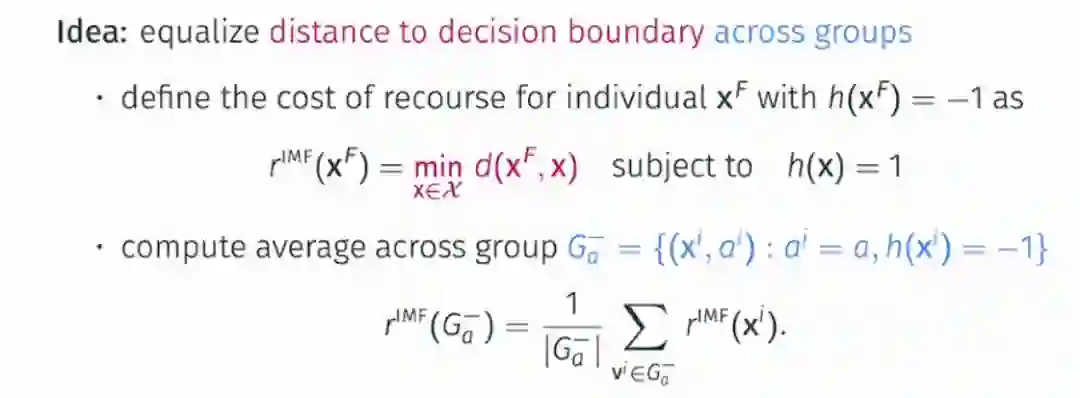
方法思路很简单,对每一个负样本即 ,我们定义一个关于他的 recourse cost 为:

即与 距离最近的的正样本的距离。那么对一个 group,我们就能计算所有负样本的 IMF 距离然后计算平均作为这个 group 的。
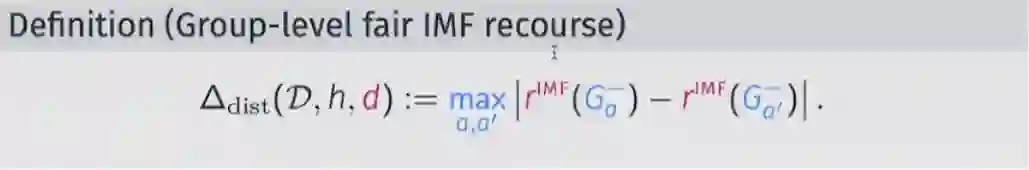
那么对整个数据集而言,IMF recourse 定义为任意两个数据集 IMF 距离的最大差值。

本文主张将不同域平均 recourse 成本相等,并在训练分类器时将此作为约束。


ICML 2021

论文标题:

On the Fairness of Causal Algorithmic Recourse

论文链接:

https://arxiv.org/abs/2010.06529

Equalizing recourse 这样的 formulation 忽略了 recourse 从根本上是一个因果问题,因为在现实世界中个人为了改变自己的处境而采取的行动可能会产生下游效应。IMF 由于没有对特征之间的因果关系进行推理,这种基于距离的方法 (i) 不能准确反映真实的(差异)recourse cost,并且 (ii) 仅限于经典的以预测为中心的方法,即改变分类器(将 group recourse cost 作为训练约束)来处理 discriminatory recourse。

本文与 IMF 最直观的差异在于,考虑了多个变量之间的相互影响即所谓的因果关系。
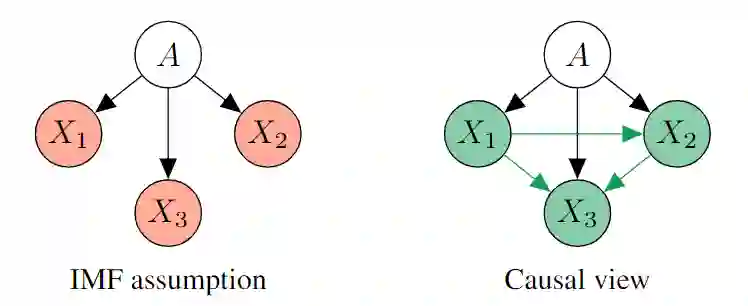
本文首先也给出了一个样本上的 recourse 花费:causal(CAU)recourse,将 IMF 的最小距离转化为因果图里的最小干预。

类似的我们可以计算每个域中的平均 recourse 距离,然后定义距离最大的两个组之间的平均距离为 Group-level fair causal recourse。正式定义为如下形式:
我们称对于 的 recourse。到此为止,我们已经见到了多种定义,但是都是 group-level 的。但是很多研究表明,fairness 更多的是针对个体的一个概念。一个直观的理解,如果现在是在执行贷款资格审查的问题,保护属性(域)可能是性别,年龄等,那么我们单纯的评测域的平均 recourse cost 意义不大,对于一个被不公正地给出不利预测的人来说,发现同一组的其他成员受到了更有利的待遇,并没有多少安慰。
所以对 Individually fair causal recourse,我们正式定义为:

这里需要理解的就是 ,这是样本 的“counterfactual twin”,即将 的域(保护)信息进行改变。

文章举出了一些例子,验证了前面定义的所有 group-level 的 fairness 都不是 individual fairness 的充分条件。

到了这里,我们已经定义完了 metric,那么如何在算法中进行优化呢?

Constrained optimisation. 一个简单的思路即在 loss 中加入相应的正则项然后潜移默化的训练分类器,这也正是前面基于 IMF 假设的方法所做的。这样我们可以通过一个权因子控制准确率和 fairness 之间的 tradeoff。然而,这样的优化问题涉及到对特征空间 的组合优化,因此,causal recourse 的公平性是否可以轻易地作为一个可微的约束条件尚不清楚。
Restricting the classifier inputs. 注意到我们现在是在 SCM 中提出的这一系列定义,因此有没有不同于传统方法的策略呢?答案是肯定的。借助于因果图形式的定性知识,我们对输入分类器的特征进行限制。强迫输入特征集仅包含受保护属性(域相关属性)的非后代,这里可能稍微有点难以理解,在 SCM 中, 即 是 的后代,那么 就对 有因果作用。
如果我们仅利用 的非后代,那么这种分类方法显然不会依赖于受保护属性,以此我们也能满足individual fairness。但是这种方法有一个致命的问题,由于受保护的属性通常代表社会人口特征(如年龄、性别、种族等),它们经常作为因果图的根节点出现,并对许多其他特征产生下游影响。因此,强制分类器只考虑非 的后代作为输入,会导致精度下降,这在实践中可能是一种限制。
Abduction / representation learning. 上一段我们说明了使用 的非后代特征可以实现 individual fairness,那么我们不妨更进一步,外生变量也就是前面我们介绍的噪声变量 ,他们显然不是 的后代,而且每个 都会有 与其相关。那么我们能够使用 来进行分类呢,这是有可能的。但是 是不可观测的,所以我们通常得使用一些特殊的工具从可观测数据中对其进行预测。

实验部分,causality 的文章基本上都会有生成数据的实验。作者准备了两种数据集

  1. Independently-manipulable features(IMF):特征之间相互独立。

  2. Causally-dependent features(CAU):特征之间相互依赖并且依赖于 ,SCM 模型如下 ,当 是线性函数时称为 ,非线性时称为 。
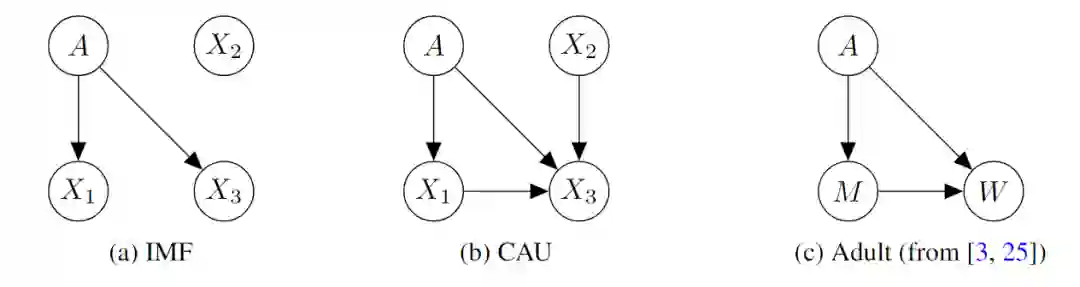
他们相应的因果图如下:

然后是不同的 baseline:

  1. LR/SVM(X,A):使用所有特征进行训练;
  2. LR/SVM(X):只使用非保护的特征进行训练;
  3. FairSVM(X,A):前文的 Equalizing recourse,平衡不同保护群体到决策边界的平均距离;
  4. LR/SVM(X ):只使用 的非后代特征进行训练;
  5. LR/SVM(X , ):使用 的非后代特征与外生变量一起进行训练。
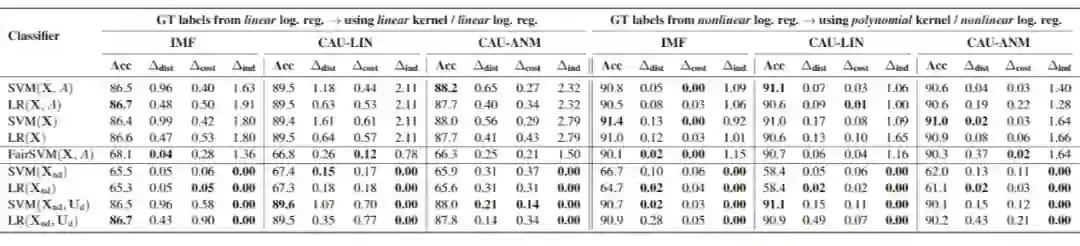
metric 有四个,首当其冲的是准确率, 即 Equalizing recourse 一文中提出的 metric, , 是本文提出的 group-level 与 individual-level 的 metric。

如上表所示,LR/SVM(X,A)与 LR/SVM(X)通常具有较高的精确度,但是在 fairness metrics 上表现不佳,而单纯的不使用保护属性 不一定有利于 fairness。这也是可以理解的,毕竟我们现在 transfer learning 都是借助域标签来提泛化性能的,没有域标签根本无从下手。FairSVM 以 作为训练的约束,因此在这个 metric 上表现得很好,特别是在两个 IMF 的数据集上。
同时有了额外约束的 FairSVM 有时候也会比 baseline 在 casual fairness 上表现得稍微好一些。最重要的,如果我们直接依赖 特征,那么可以非常好满足 individual causal fairness,但是性能会有很大的下降,正如前文分析的这般。当我们引入 时,情况得到了极大的改善,既保证了准确性,又完美的满足了 individual causal fairness 的限制。
需要注意的是,这里的实验使用的是真实的 ,正常情况下这是无法观测的,需要我们人为预测,所以这里的 LR/SVM(X , )可以理解为算法的 upper bound。

除了合成数据,作者还在 Adult 数据集上进行了实验,数据集的具体介绍可以参照原文,这是一个专门用于 Causal 的数据集,提供了各个属性的名称以及相应的因果关系。

总结一下,recourse fairness 是一个非常有趣的话题,可以用来分析我们的数据对敏感或者说受保护属性的敏感程度,这个方向目前发展不久,目前虽然有一些 metric 来衡量数据集和模型 fairness 的程度,但是还不清楚如何在不改变 classifier 的情况下缓解 unfairness。而且可以看到,最后这篇文章实际上很依赖潜在的结构化因果模型,而在实际场景中因果模型的 inference 本身就是一个非常难得问题,recourse fairness 还有很长的路需要走。

特别鸣谢

感谢 TCCI 天桥脑科学研究院对于 PaperWeekly 的支持。TCCI 关注大脑探知、大脑功能和大脑健康。


更多阅读


#投 稿 通 道#

 让你的文字被更多人看到 


如何才能让更多的优质内容以更短路径到达读者群体,缩短读者寻找优质内容的成本呢?答案就是:你不认识的人。


总有一些你不认识的人,知道你想知道的东西。PaperWeekly 或许可以成为一座桥梁,促使不同背景、不同方向的学者和学术灵感相互碰撞,迸发出更多的可能性。 


PaperWeekly 鼓励高校实验室或个人,在我们的平台上分享各类优质内容,可以是最新论文解读,也可以是学术热点剖析、科研心得或竞赛经验讲解等。我们的目的只有一个,让知识真正流动起来。


📝 稿件基本要求:

• 文章确系个人原创作品,未曾在公开渠道发表,如为其他平台已发表或待发表的文章,请明确标注 

• 稿件建议以 markdown 格式撰写,文中配图以附件形式发送,要求图片清晰,无版权问题

• PaperWeekly 尊重原作者署名权,并将为每篇被采纳的原创首发稿件,提供业内具有竞争力稿酬,具体依据文章阅读量和文章质量阶梯制结算


📬 投稿通道:

• 投稿邮箱:[email protected] 

• 来稿请备注即时联系方式(微信),以便我们在稿件选用的第一时间联系作者

• 您也可以直接添加小编微信(pwbot02)快速投稿,备注:姓名-投稿

△长按添加PaperWeekly小编


🔍


现在,在「知乎」也能找到我们了

进入知乎首页搜索「PaperWeekly」

点击「关注」订阅我们的专栏吧


·

登录查看更多
0

相关内容

分类是数据挖掘的一种非常重要的方法。分类的概念是在已有数据的基础上学会一个分类函数或构造出一个分类模型(即我们通常所说的分类器(Classifier))。该函数或模型能够把数据库中的数据纪录映射到给定类别中的某一个,从而可以应用于数据预测。总之,分类器是数据挖掘中对样本进行分类的方法的统称,包含决策树、逻辑回归、朴素贝叶斯、神经网络等算法。
专知会员服务
33+阅读 · 2021年10月4日
专知会员服务
20+阅读 · 2021年8月30日
专知会员服务
17+阅读 · 2021年7月13日
【ICML2021】来自观察的跨域模仿
专知会员服务
18+阅读 · 2021年5月25日
专知会员服务
17+阅读 · 2021年4月27日
谷歌NIPS'21 | 如何让图神经网络更稳健?
图与推荐
1+阅读 · 2022年3月22日
如何衡量目标检测模型的优劣
极市平台
1+阅读 · 2021年10月17日
KDD'21 | 如何评估GNN的解释性模型?
图与推荐
1+阅读 · 2021年9月30日
PFLD:简单高效的实用人脸关键点检测算法
PaperWeekly
20+阅读 · 2019年4月17日
使用LSTM模型预测股价基于Keras
量化投资与机器学习
35+阅读 · 2018年11月17日
详解常见的损失函数
七月在线实验室
20+阅读 · 2018年7月12日
一文读懂贝叶斯分类算法(附学习资源)
大数据文摘
12+阅读 · 2017年12月14日
国家自然科学基金
3+阅读 · 2015年12月31日
国家自然科学基金
6+阅读 · 2014年12月31日
国家自然科学基金
5+阅读 · 2013年12月31日
国家自然科学基金
4+阅读 · 2013年12月31日
国家自然科学基金
0+阅读 · 2013年12月31日
国家自然科学基金
0+阅读 · 2012年12月31日
国家自然科学基金
3+阅读 · 2012年12月31日
国家自然科学基金
0+阅读 · 2008年12月31日
One-Class Model for Fabric Defect Detection
Arxiv
0+阅读 · 2022年4月20日
Arxiv
12+阅读 · 2021年6月29日
VIP会员
最新内容
《衡量语言模型中的作战规划能力》
专知会员服务
9+阅读 · 10月20日
Maven智能系统:帕兰提尔军事人工智能平台详解
专知会员服务
9+阅读 · 10月20日
《测试自动化框架在敏捷软件开发中的角色》
专知会员服务
7+阅读 · 10月20日
俄罗斯如何拦截乌克兰无人机与巡航导弹
专知会员服务
11+阅读 · 10月15日
《武器-目标分配问题:精确与近似求解算法》
专知会员服务
15+阅读 · 10月15日
现代电磁战:集成式系统簇时代如何实现频谱优势
综述|谁来改进机器人?迈向物理递归自我改进
专知会员服务
11+阅读 · 10月14日
软件定义无人机蜂群给防空带来全新压力
专知会员服务
10+阅读 · 10月13日
相关资讯
谷歌NIPS'21 | 如何让图神经网络更稳健?
图与推荐
1+阅读 · 2022年3月22日
如何衡量目标检测模型的优劣
极市平台
1+阅读 · 2021年10月17日
KDD'21 | 如何评估GNN的解释性模型?
图与推荐
1+阅读 · 2021年9月30日
PFLD:简单高效的实用人脸关键点检测算法
PaperWeekly
20+阅读 · 2019年4月17日
使用LSTM模型预测股价基于Keras
量化投资与机器学习
35+阅读 · 2018年11月17日
详解常见的损失函数
七月在线实验室
20+阅读 · 2018年7月12日
一文读懂贝叶斯分类算法(附学习资源)
大数据文摘
12+阅读 · 2017年12月14日
相关基金
国家自然科学基金
3+阅读 · 2015年12月31日
国家自然科学基金
6+阅读 · 2014年12月31日
国家自然科学基金
5+阅读 · 2013年12月31日
国家自然科学基金
4+阅读 · 2013年12月31日
国家自然科学基金
0+阅读 · 2013年12月31日
国家自然科学基金
0+阅读 · 2012年12月31日
国家自然科学基金
3+阅读 · 2012年12月31日
国家自然科学基金
0+阅读 · 2008年12月31日
Top
微信扫码咨询专知VIP会员