发布可伸缩超网SCARLET,小米AutoML团队NAS三部曲杀青

2019 年 8 月 20 日 PaperWeekly


作者丨江渚碧

学校丨武汉大学

研究方向丨智能计算


昨天,小米 AutoML 团队(初祥祥、张勃、李吉祥、李庆源、许瑞军等)发布最新成果 SCARLET,超过了 Google Brain 首席科学家 Quoc Le 和 Tan Mingxing 共同完成的 EfficientNet 同量级模型 (ICML 2019)。

SCARLET 论文探究了 One-shot 路线自动化神经网络搜索中没有被深入考察的可伸缩性问题,首次提出并证明线性等价变换可以使超网具备可伸缩功能。

论文发布的 SCARLET 系列模型超过当前大火的 EfficientNet,并且相比 EfficientNet 的纯强化路线相比用了更少的计算资源,更短的搜索时间。SCARLET 模型在 ImageNet 1k 分类任务中达到 76.9% 的 top-1 精度,目前是近 400 M FLOPs 量级的 SOTA。

至此,小米 AutoML 团队在短短两月间写就 FairNAS、MoGA、SCARLET 三部曲,依次超过 Google 顶级团队的 MnasNet、MobileNetV3、EfficientNet。


模型地址:

https://github.com/xiaomi-automl/SCARLET-NAS


One-shot路线之优劣


虽然 one-shot 由于权重共享,一次超网训练,评估子网时可以多次收益,足够快也足够有效。但相比 Google Brain 的 RL 路线(NASNet、MnasNet 等)或其他路线,one-shot 的灵活性大打折扣。其中一点就是不能自由伸缩。

一般地讲,更深的网络有更好的表征能力。但事实是,稍浅的网络能力也不是很弱,有时还反而更好。这就好比在矮个子有时也比高个子力量大,高度(深度)不是评判一个人力量的唯一标准。考虑到我们部署时的限制,我们不仅要小个子,还要发掘优秀的小个子。在太空任务中,矮个子杨利伟反而成了优势。 

之前的 one-shot 方法比如 ProxylessNAS 曾引入了跳接 (skip connection)来给超网带来伸缩性,但由于没有展示中间结果,以及并没有展开理论探讨,跳接在什么程度上影响了超网训练和最后的模型搜索均难以评估。

引入恒等变换


恒等变换(Identity mapping,ID)即跳接,在当前层的可选择运算模块(Choice block)中加入这个操作,可以从上一层直接越过连到当前层的下一层,从而实现层数的压缩,听上去很靠谱,但当引入 ID 后 one-shot 超网训练如何呢?


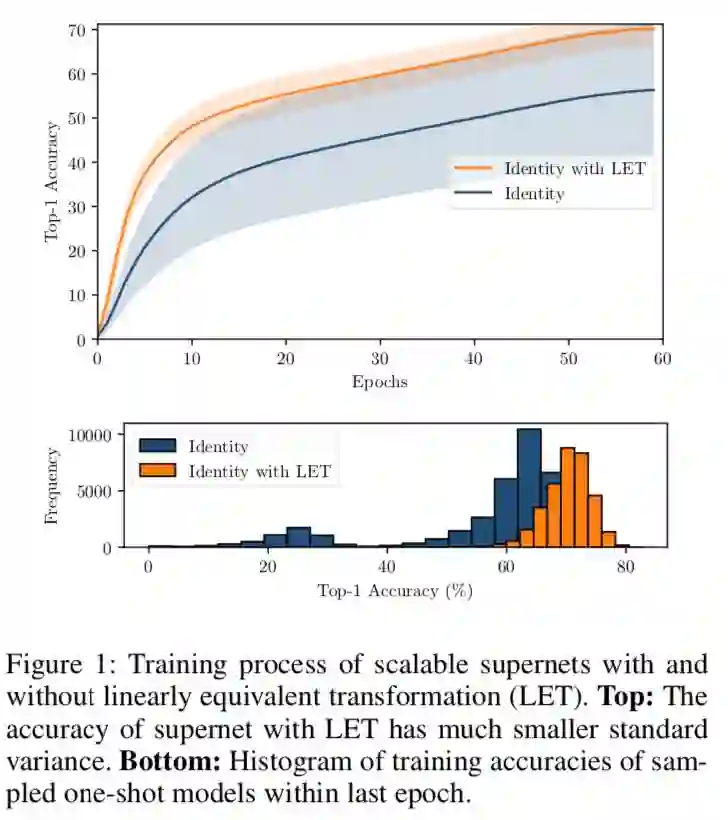
根据 SCARLET 做的实验看,单单加上 ID 就直接导致了超网训练的大幅波动,在选择了 ID 的那条路径,模型能力迅速下降,严重影响了整个超网的参数更新。


增加线性等价变换
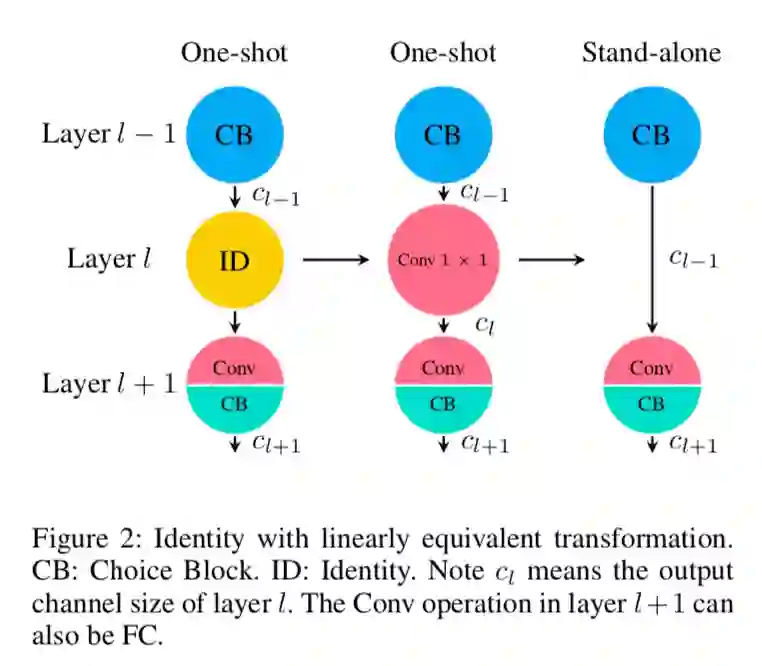

恒等变换能帮我们实现层数的压缩,但又是个捣乱分子。怎么解决呢?SCARLET 提出给这个捣乱分子进行一些教育改良,由于之前的 ID 并没有学习功能,只完成连接,那最常见的学习单元就是带参数的卷积层。但问题来了,加了卷积层的路径和原有路径有什么不同呢?我们最后采样的模型,能否取掉这个卷积层来完成层间的跳接,实现我们期待的压缩呢? 


▲   Fig 2.  线性等价变换示意图

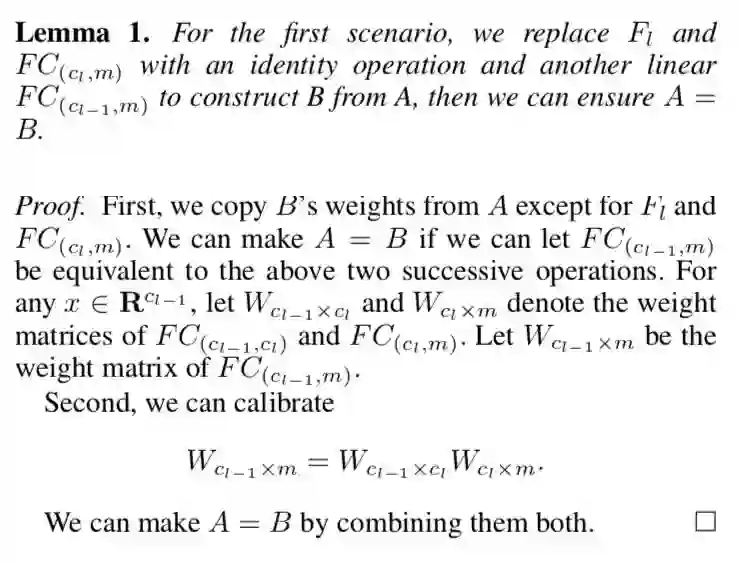
幸运地是,加了线性的卷积层(即不含激活单元)的采样模型在表征能力上是和原有网络是等价的。SCARLET 对此进行了分情形的严格证明。在下一层运算单元是 FC 或 Conv 的情况下,给捣乱分子 ID 配备了学习单元 Conv 以后,表征能力并没有改变。这样的改良文中称作线性等价变换(Linearly Equivalent Transformation, LET)。

所以超网训练过程要开启 LET 来补足别的 block 都在学习,ID 不学习的弱点,而训练结束后,去掉 LET 完成瘦身,本文叫做 SCARLET,扼要概括了本次的方法创新(SCAlable supeRnet with Linearly Equivalent Transformation)。

▲ Fig 3.  情形一,线性等价变换前后表征能力等价的证明


加入了 LET 之后,超网训练就平和了许多。训练过程的模型采样来看,没有开 LET 前主要分布在两个区域,而开启之后,都集中在得分比较高的这个区间。

▲   Fig 4.  引入 LET 前后超网训练对比


与当前最好模型对比


从表中看出,SCARLET 这次打的是 EfficientNet 同量级模型 B0,SCARLET-A、B 均用了明显更少的 FLOPs,大幅超过或齐平 B0。而 SCARLET-C 又是超过了自己三部曲第一部中提出的 SOTA 模型 FairNAS-A。
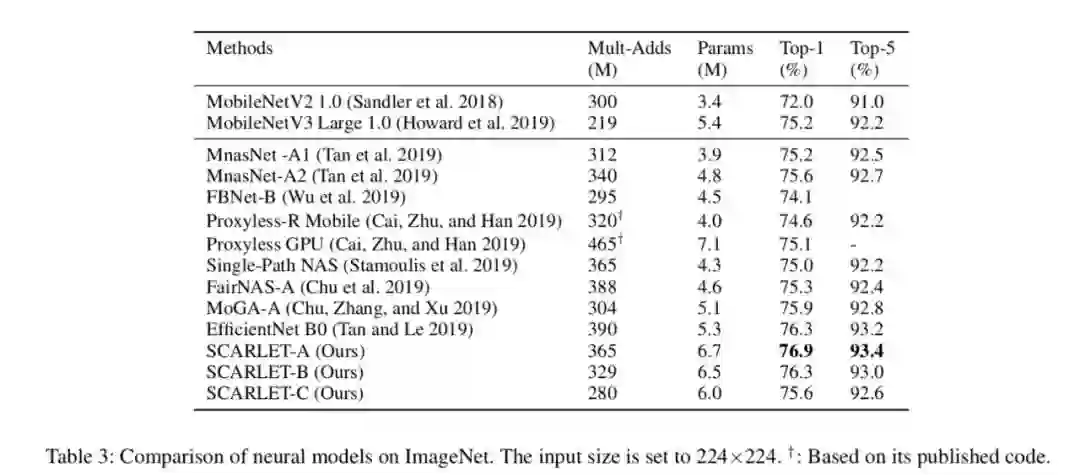

▲ Fig 5. 当前 SOTA 模型在 ImageNet 数据集上的对比


模型结构分析
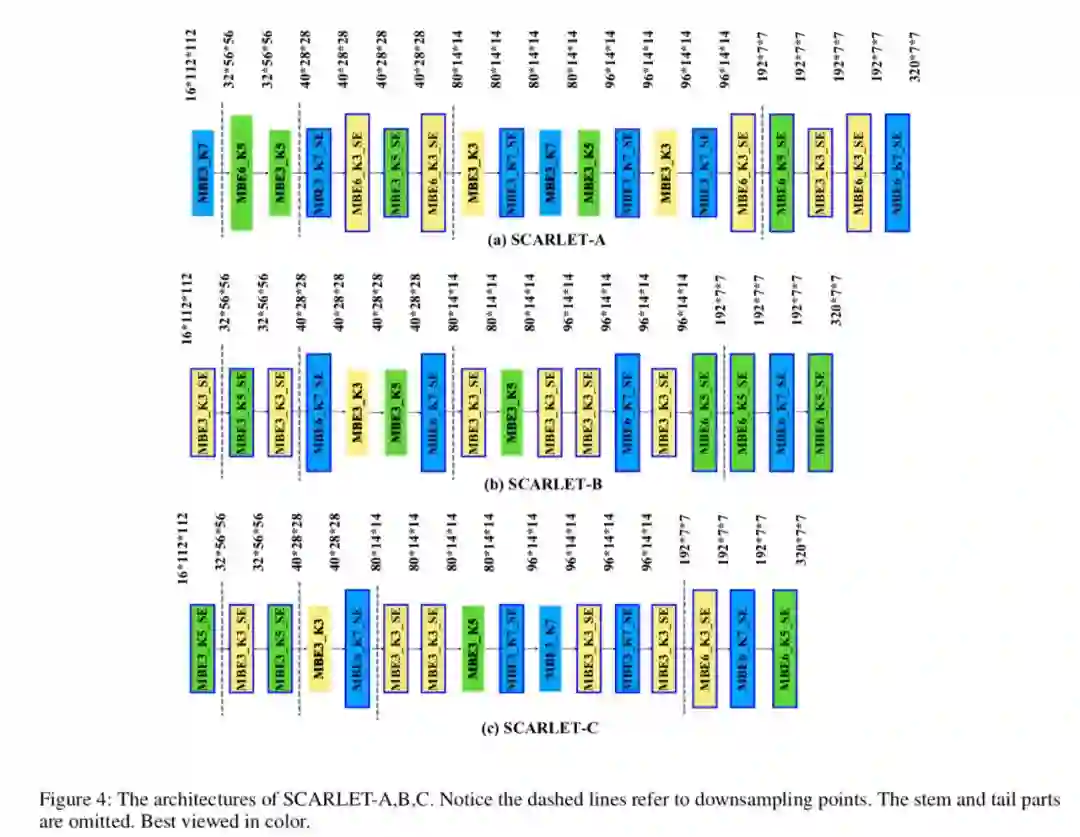

▲ Fig 6. SCARLET A,B,C 模型


与以往发布的 FairNAS 和 MoGA 模型不同,这次系列模型中有了更浅的层级,这也呼应了本次方法的要点,就是要找出浅一点但也很不错的模型,展示了超网的可伸缩性。 


参考文献


Chu et al., FairNAS: Rethinking Evaluation Fairness of Weight Sharing Neural Architecture Search 

https://arxiv.org/abs/1907.01845 

Chu et al., MoGA: Searching Beyond MobileNetV3 

https://arxiv.org/abs/1908.01314 

Chu et al., ScarletNAS: Bridging the Gap Between Scalability and Fairness in Neural Architecture Search 

https://arxiv.org/abs/1908.06022 

Zoph et al. Learning Transferable Architectures for Scalable Image Recognition 

https://arxiv.org/pdf/1707.07012 

Cai et al: ProxylessNAS: Direct Neural Architecture Search on Target Task and Hardware 

https://arxiv.org/abs/1812.00332 

Tan et al., MnasNet: Platform-Aware Neural Architecture Search for Mobile 

https://arxiv.org/abs/1807.11626


点击以下标题查看更多往期内容: 


#投 稿 通 道#

 让你的论文被更多人看到 


如何才能让更多的优质内容以更短路径到达读者群体,缩短读者寻找优质内容的成本呢?答案就是:你不认识的人。


总有一些你不认识的人,知道你想知道的东西。PaperWeekly 或许可以成为一座桥梁,促使不同背景、不同方向的学者和学术灵感相互碰撞,迸发出更多的可能性。 


PaperWeekly 鼓励高校实验室或个人,在我们的平台上分享各类优质内容,可以是最新论文解读,也可以是学习心得或技术干货。我们的目的只有一个,让知识真正流动起来。


📝 来稿标准:

• 稿件确系个人原创作品,来稿需注明作者个人信息(姓名+学校/工作单位+学历/职位+研究方向) 

• 如果文章并非首发,请在投稿时提醒并附上所有已发布链接 

• PaperWeekly 默认每篇文章都是首发,均会添加“原创”标志


📬 投稿邮箱:

• 投稿邮箱:[email protected] 

• 所有文章配图,请单独在附件中发送 

• 请留下即时联系方式(微信或手机),以便我们在编辑发布时和作者沟通


🔍


现在,在「知乎」也能找到我们了

进入知乎首页搜索「PaperWeekly」

点击「关注」订阅我们的专栏吧


关于PaperWeekly


PaperWeekly 是一个推荐、解读、讨论、报道人工智能前沿论文成果的学术平台。如果你研究或从事 AI 领域,欢迎在公众号后台点击「交流群」,小助手将把你带入 PaperWeekly 的交流群里。

▽ 点击 | 阅读原文 | 下载论文 & 源码

登录查看更多
0

相关内容

【Google】利用AUTOML实现加速感知神经网络设计
专知会员服务
30+阅读 · 2020年3月5日
深度解读:小米AI实验室AutoML团队最新成果FairNAS
PaperWeekly
32+阅读 · 2019年7月11日
雷军强推:小米造最强超分辨率算法,现已开源
机器之心
7+阅读 · 2019年2月20日
干货 | 让算法解放算法工程师——NAS 综述
AI科技评论
4+阅读 · 2018年9月12日
干货 | AutoML 和神经架构搜索初探
AI科技评论
3+阅读 · 2018年8月1日
AutoML 和神经架构搜索初探
雷锋网
5+阅读 · 2018年8月1日
TResNet: High Performance GPU-Dedicated Architecture
Arxiv
8+阅读 · 2020年3月30日
Deflecting Adversarial Attacks
Arxiv
8+阅读 · 2020年2月18日
AutoML: A Survey of the State-of-the-Art
Arxiv
75+阅读 · 2019年8月14日
One-Shot Federated Learning
Arxiv
9+阅读 · 2019年3月5日
Arxiv
3+阅读 · 2018年6月24日
VIP会员
最新内容
《衡量语言模型中的作战规划能力》
专知会员服务
4+阅读 · 10月20日
Maven智能系统:帕兰提尔军事人工智能平台详解
专知会员服务
6+阅读 · 10月20日
《测试自动化框架在敏捷软件开发中的角色》
专知会员服务
4+阅读 · 10月20日
俄罗斯如何拦截乌克兰无人机与巡航导弹
专知会员服务
10+阅读 · 10月15日
《武器-目标分配问题:精确与近似求解算法》
专知会员服务
14+阅读 · 10月15日
现代电磁战:集成式系统簇时代如何实现频谱优势
综述|谁来改进机器人?迈向物理递归自我改进
专知会员服务
11+阅读 · 10月14日
软件定义无人机蜂群给防空带来全新压力
专知会员服务
10+阅读 · 10月13日
相关资讯
相关论文
TResNet: High Performance GPU-Dedicated Architecture
Arxiv
8+阅读 · 2020年3月30日
Deflecting Adversarial Attacks
Arxiv
8+阅读 · 2020年2月18日
AutoML: A Survey of the State-of-the-Art
Arxiv
75+阅读 · 2019年8月14日
One-Shot Federated Learning
Arxiv
9+阅读 · 2019年3月5日
Arxiv
3+阅读 · 2018年6月24日
Top
微信扫码咨询专知VIP会员