
当一个大型、不完整且部分矛盾的文档集合不存在唯一正确答案时,语言模型能在多大程度上将其转化为一份计划?提出了基于任务分析的Mission Analysis (MA)-Bench——这是军事作战规划的第一步,参谋人员在提出任何解决方案之前,先阅读完整态势并阐述问题。该基准包含10个由专家构建的场景,每个场景配有一组10至12份合成文档,以及1257条由专家编写的通过/未通过评估项,每条评估项均包含其来源、问题类型和重要性等级信息。一位推理模型裁判在未见文档的情况下根据评分标准对每份简报进行评分;其评分如同第五位持证规划师,使四人评审小组的一致性保持不变(Fleiss κ 从0.42变为0.41),而来自另一家供应商的裁判则复现了模型的排名(Spearman相关系数0.94)。在20个前沿和开源权重模型中,表现最佳的模型正确回答了62%的评分项目。模型在文档中陈述的事实方面表现最强(58%),在必须推断的判断方面最弱(33%),且60%的失败源于遗漏而非错误。MA-Bench对裁定结果而非文字表述进行评分。我们公开发布了文档包、评分标准、提示词、评分器以及每份附带逐项裁决的评分简报。
主要贡献在于评估方法和数据集,而对20个模型的评估则展示了它们所衡量的内容:
• 针对开放式、高风险且具有异质性证据且无唯一参考答案的规划任务,提出了一种作战规划评估的表述方法。
• MA-Bench,包含10个经专家验证的场景、长篇多文档规划文档包以及1257条由专家撰写的原子化评估项,并采用一种结构化的评估方法,将提取、综合与推断相分离,同时对遗漏和有害行为进行显式评分。
• 对20个前沿和开源权重模型进行的实证评估,使用一位其评分标准经持证规划师校验的裁判,分析总体性能、能力分解、失效模式及评估可靠性。
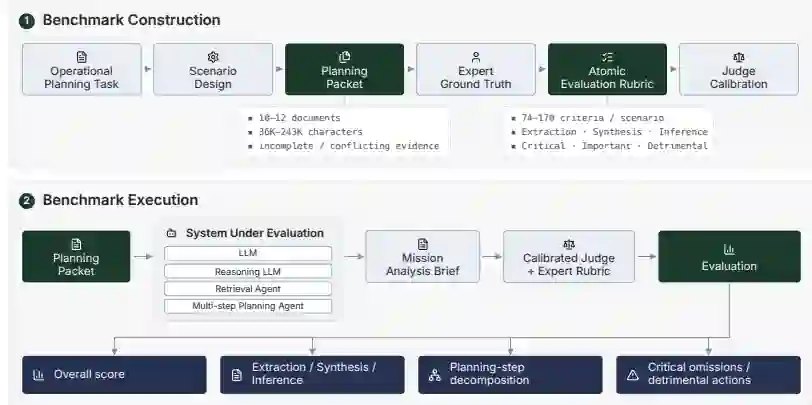
图2. MA-Bench构建与评估流程。上图:基准构建,从作战规划任务设计到场景构建、规划文档包、专家真实答案、原子化评分标准及裁判校准。下图:基准执行,向被评估系统提供规划文档包,使用校准后的裁判和专家评分标准对生成的任务分析简报进行评分,并按总分、推理层次、规划步骤及关键或有害错误对性能进行分解。
 原文下载



相关内容

 微信扫码咨询专知VIP会员