七夕,用AI算算你的撩妹战斗力,还可领取大礼包

2020 年 8 月 25 日 机器之心

「用姓名测试爱情,80% 准确率!」


「 俗话说,名如其人,缘分就是人生的后半生。」


「心动不如行动,来一个属于自己的名字配对缘分测试吧!」


这些话你一定已经在很多微信号、电视节目,甚至奇奇怪怪的小网站上都看到过。

你一定也很好奇,名字缘分测试背后到底是不是有科学依据支撑。

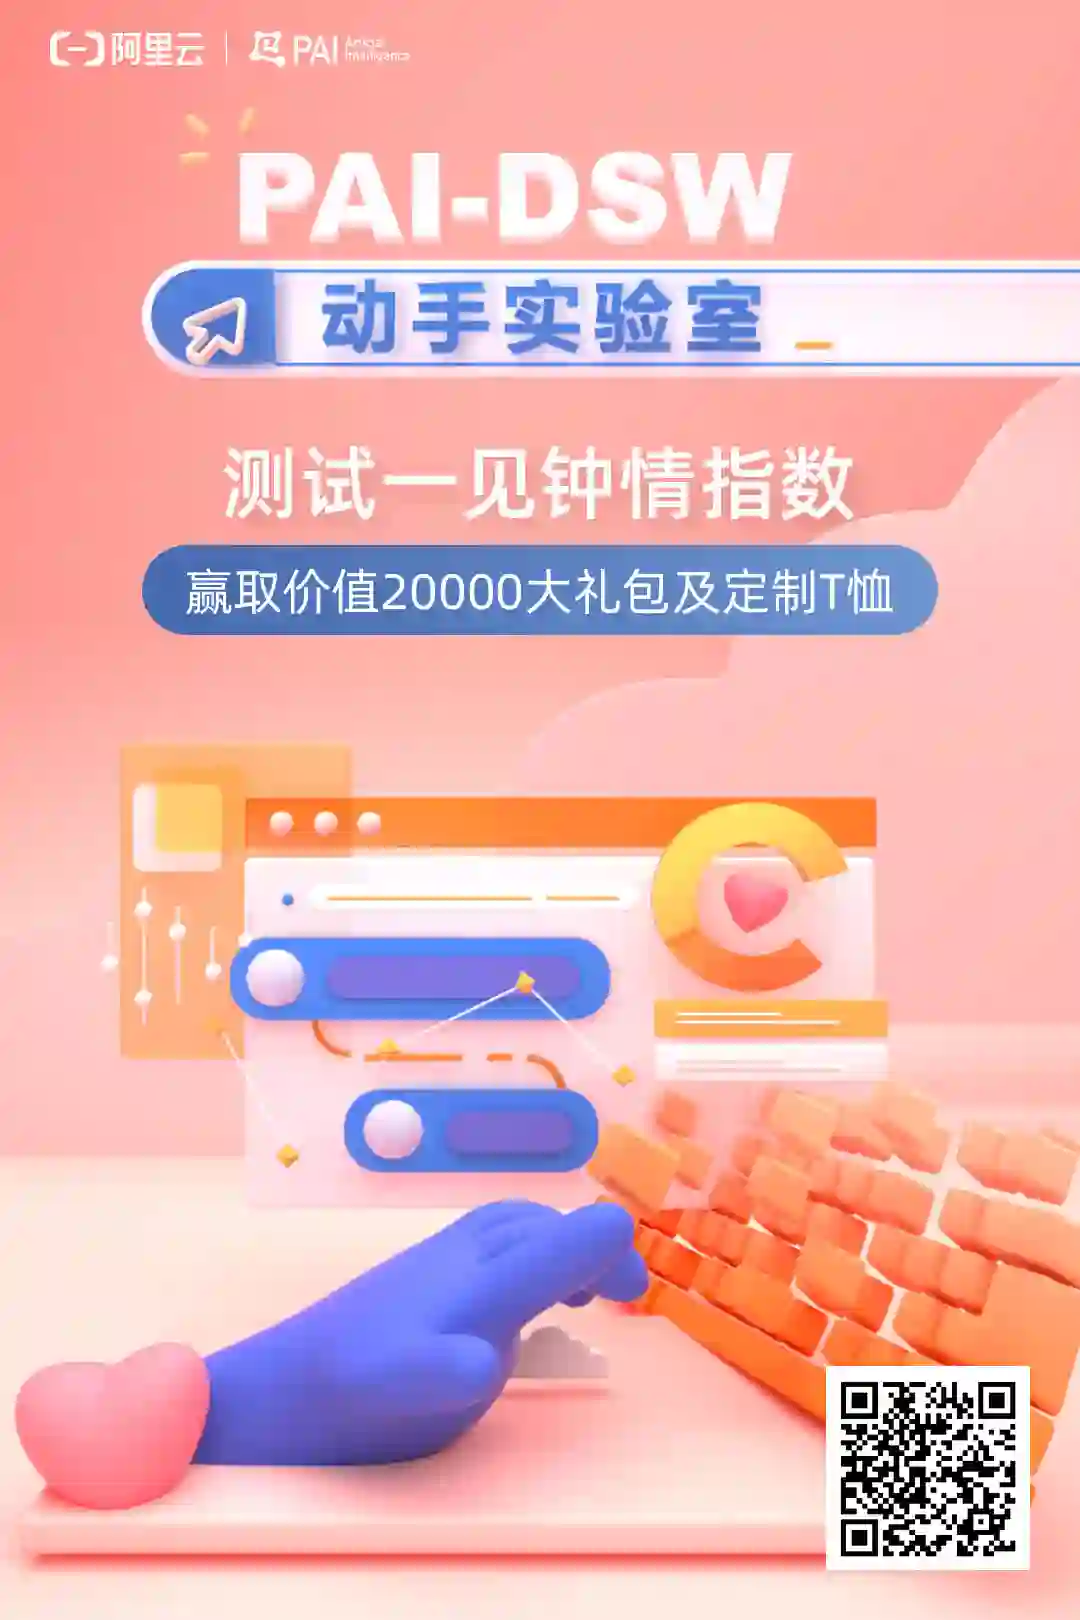
今天,机器之心将为单身读者朋友们介绍一下阿里云的 PAI-DSW 的动手实验室,测试你的一见钟情指数。虽然 不能直接帮你测试你和某个特定的人直接的缘分, 但是借助哥伦比亚大学多年研究相亲找对象的心血,通过几个简单的特征就可以评估你的相亲战斗力指数 。

扫描下图中的二维码,就可以进入测试页面[1]。


只是正式开始实验之前, 我们需要寻找一个简单好用方便上手的工具,这里我推荐一波阿里云的 PAI-DSW 探索者版,它对于个人开发者是免费的,还有免费 GPU 资源可以使用,实验的数据更会免费保存 30 天 。点击这里[2] 只要登陆就可直接使用。

今天,我们就会通过这个工具来探索人性的奥秘,走进两性关系的神秘空间,嘿嘿嘿。

整个实验的数据来自哥伦比亚大学的公开数据[3] 。这个实验中,参与者被要求参加多轮与异性进行的快速相亲,每轮相亲持续 4 分钟,在 4 分钟结束后,参与者双方会被询问是否愿意与他们的对象再见面。只有当双方都回答了 「是」的时候,这次相亲才算是配对成功。

同时,参与者也会被要求通过以量化的方式从外观吸引力、真诚度、智商、风趣程度、事业心和兴趣爱好这六个方向来评估他们的相亲对象。

这个数据集也包含了很多参加快速相亲的参与者的其他相关信息,比如地理位置、喜好、对于理想对象的偏好、收入水平、职业以及教育背景等等。关于整个数据集的具体特征描述可以参考这个文件[4] 。

本次我们实验的目的主要是为了找出,当一个人在参加快速相亲时,到底会有多高的几率能够遇到自己心动的人并成功牵手。

在我们建模分析探索人性的秘密之前,让我们先读入数据,来看看我们的数据集长什么样。

import pandas as pd
df = pd.read_csv('Speed Dating Data.csv', encoding='gbk')
print(df.shape)

通过观察,我们不难发现,在这短短的两年中,这个实验的小酒馆经历了 8000 多场快速相亲的实验。由此我们可以非常轻易的推断出,小酒馆的老板应该赚的盆满钵满(大雾)

然后从数据的宽度来看,我们会发现一共有接近 200 个特征。关于每个特征的具体描述大家可以参考这篇文档[5] 。然后我们再观察数据的完整度,看看是否有缺失数据。

percent_missing = df.isnull().sum() * 100 / len(df)
missing_value_df = pd.DataFrame({
    'column_name': df.columns,
    'percent_missing': percent_missing
})
missing_value_df.sort_values(by='percent_missing')

通过以上代码,我们不难发现,其实还有很多的特征是缺失的。这一点在我们后面做分析和建模的时候,都需要关注到。因为一旦一个特征缺失的数据较多,就会导致分析误差变大或者模型过拟合 / 精度下降。看完数据的完整程度,我们就可以继续往下探索了。

然后第一个问题就来了,在这 8000 多场的快速相亲中,到底有多少场相亲成功为参加的双方找到了合适的伴侣的?带着这个问题,我们就可以开始我们的第一个探索性数据分析。

# 多少人通过Speed Dating找到了对象
plt.subplots(figsize=(3,3), dpi=110,)
# 构造数据
size_of_groups=df.match.value_counts().values

single_percentage = round(size_of_groups[0]/sum(size_of_groups) * 100,2) 
matched_percentage = round(size_of_groups[1]/sum(size_of_groups)* 100,2) 
names = [
    'Single:' + str(single_percentage) + '%',
    'Matched' + str(matched_percentage) + '%']

# 创建饼图
plt.pie(
    size_of_groups, 
    labels=names, 
    labeldistance=1.2, 
    colors=Pastel1_3.hex_colors
)
plt.show()
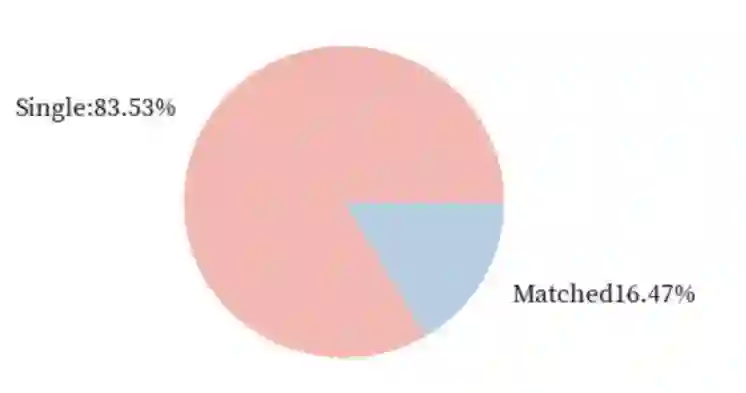

从上边的饼图我们可以发现,真正通过快速相亲找到对象的比率仅有 16.47%。

然后我们就迎来了我们的第二个问题,这个比率和参加的人的性别是否有关呢?这里我们也通过 Pandas 自带的 filter 的方式

df[df.gender == 0]

来筛选数据集中的性别。通过阅读数据集的文档,我们知道 0 代表的是女生,1 代表的是男生。然后同理,我们执行类似的代码。

# 多少女生通过Speed Dating找到了对象
plt.subplots(figsize=(3,3), dpi=110,)
# 构造数据
size_of_groups=df[df.gender == 0].match.value_counts().values # 男生只需要吧0替换成1即可

single_percentage = round(size_of_groups[0]/sum(size_of_groups) * 100,2) 
matched_percentage = round(size_of_groups[1]/sum(size_of_groups)* 100,2) 
names = [
    'Single:' + str(single_percentage) + '%',
    'Matched' + str(matched_percentage) + '%']

# 创建饼图
plt.pie(
    size_of_groups, 
    labels=names, 
    labeldistance=1.2, 
    colors=Pastel1_3.hex_colors
)
plt.show()
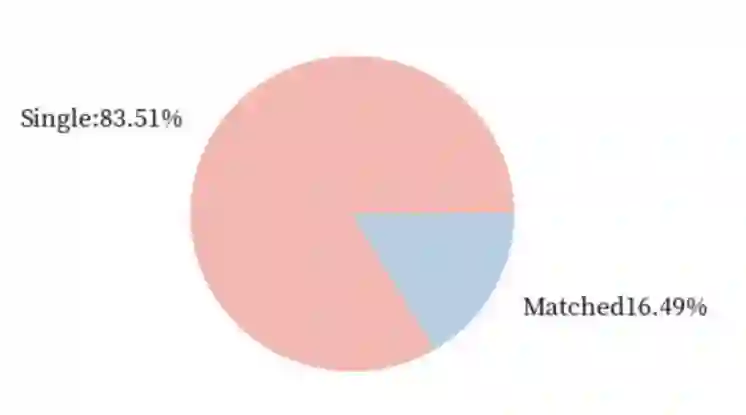
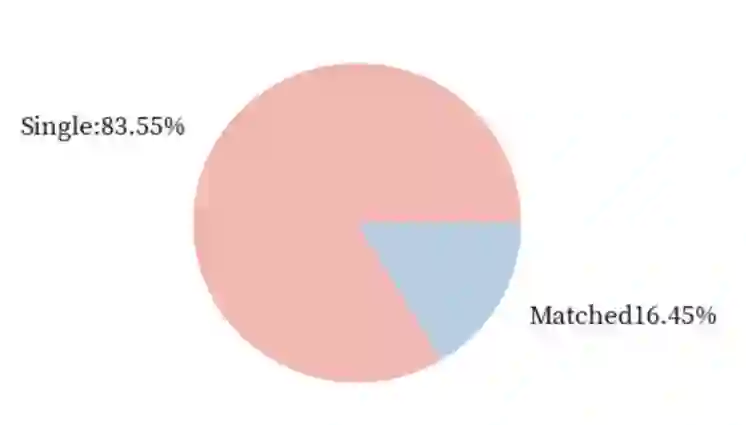
来找出女生和男生分别在快速相亲中找到对象的几率的 。

女生的几率:


男生的几率:


不难发现,在快速相亲中,女生相比于男生还是稍微占据一些优势的。女生成功匹配的几率比男生成功匹配的几率超出了 0.04。

然后第二个问题来了:是什么样的人在参加快速相亲这样的活动呢? 真的都是大龄青年(年龄大于 30)嘛?这个时候我们就可以通过对参加人群的年龄分布来做一个统计分析。

# 年龄分布
age = df[np.isfinite(df['age'])]['age']
plt.hist(age,bins=35)
plt.xlabel('Age')
plt.ylabel('Frequency')
plt.show()
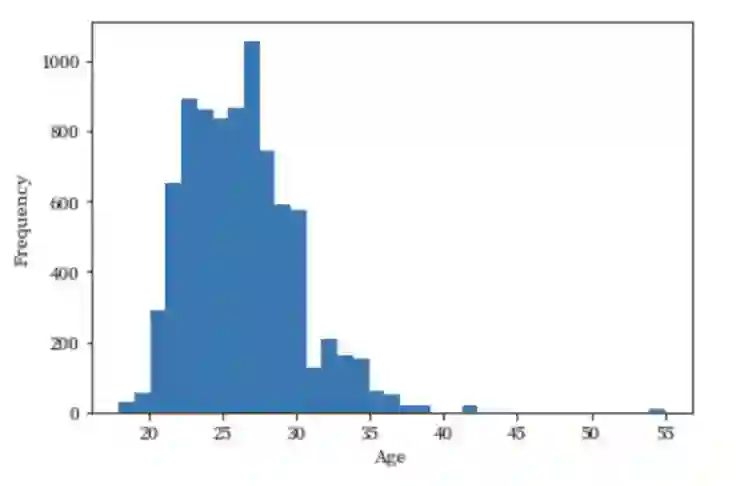

不难发现,参加快速相亲的人群主要是 22~28 岁的群体。这点与我们的预期有些不太符合,因为主流人群并不是大龄青年。接下来的问题就是,年龄是否会影响相亲的成功率呢?和性别相比,哪个对于成功率的影响更大?这两个问题在本文就先埋下一个伏笔,不一一探索了,希望阅读文章的你能够自己探索。

但是这里可以给出一个非常好用的探索相关性的方式叫做数据相关性分析。通过阅读数据集的描述,我已经为大家选择好了一些合适的特征去进行相关性分析。这里合适的定义是指:1. 数据为数字类型,而不是字符串等无法量化的值。2. 数据的缺失比率较低。

date_df = df[[
    'iid', 'gender', 'pid', 'match', 'int_corr', 'samerace', 'age_o',
       'race_o', 'pf_o_att', 'pf_o_sin', 'pf_o_int', 'pf_o_fun', 'pf_o_amb',
       'pf_o_sha', 'dec_o', 'attr_o', 'sinc_o', 'intel_o', 'fun_o', 'like_o',
       'prob_o', 'met_o', 'age', 'race', 'imprace', 'imprelig', 'goal', 'date',
       'go_out', 'career_c', 'sports', 'tvsports', 'exercise', 'dining',
       'museums', 'art', 'hiking', 'gaming', 'clubbing', 'reading', 'tv',
       'theater', 'movies', 'concerts', 'music', 'shopping', 'yoga', 'attr1_1',
       'sinc1_1', 'intel1_1', 'fun1_1', 'amb1_1', 'attr3_1', 'sinc3_1',
       'fun3_1', 'intel3_1', 'dec', 'attr', 'sinc', 'intel', 'fun', 'like',
       'prob', 'met'
]]

# heatmap
plt.subplots(figsize=(20,15))
ax = plt.axes()
ax.set_title("Correlation Heatmap")
corr = date_df.corr()
sns.heatmap(corr, 
            xticklabels=corr.columns.values,
            yticklabels=corr.columns.values)
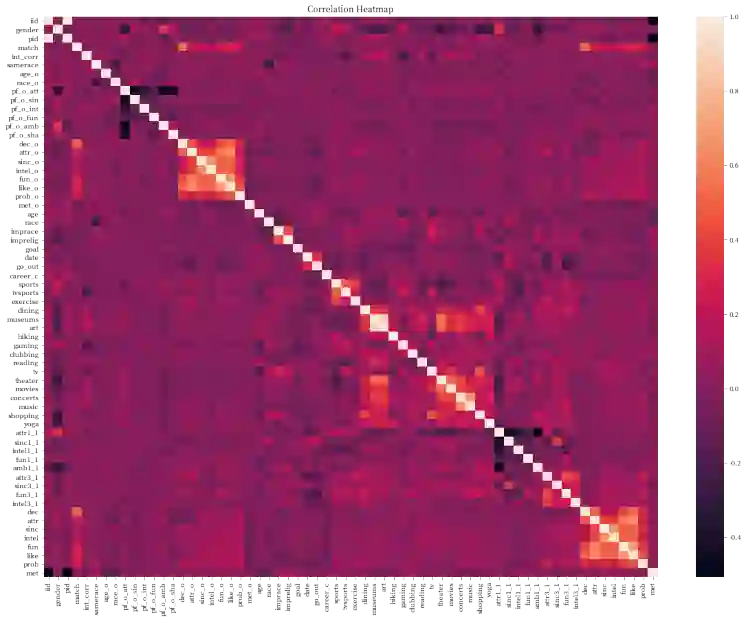

通过上面这张图这张相关性分析的热力图,我们可以先关注一些特别亮的和特别暗的点。比如我们可以发现,在 pf_o_att 这个表示相亲对象给出的外观吸引力这个特征上,和其他相亲对象给出的评分基本都是严重负相关的,除了 pf_o_fun 这一特征。由此我们可以推断出两个点:

  1. 大家会认为外观更加吸引人的人在智商,事业心,真诚度上表现会相对较差。换句话说,可能就是颜值越高越浪

  2. 幽默风趣的人更容易让人觉得外观上有吸引力, 比如下面这位幽默风趣的男士(大雾):


然后我们再看看我们最关注的特征 match,和这一个特征相关性比较高的特征是哪几个呢?不难发现,其实就是'attr_o','sinc_o','intel_o','fun_o','amb_o','shar_o'这几个特征,分别是相亲对方给出的关于外观,真诚度,智商,风趣程度,事业线以及兴趣爱好的打分。接下来我们就可以根据这个来进行建模了。首先我们将我们的特征和结果列都放到一个 Dataframe 中,然后再去除含有空值的纪录。最后我们再分为 X 和 Y 用来做训练。当然分为 X,y 之后,由于我们在最开始就发现只有 16.47% 的参与场次中成功匹配了,所以我们的数据有严重的不均衡,这里我们可以用 SVMSMOTE[6] 来增加一下我们的数据量避免模型出现过度拟合。

# preparing the data
clean_df = df[['attr_o','sinc_o','intel_o','fun_o','amb_o','shar_o','match']]
clean_df.dropna(inplace=True)
X=clean_df[['attr_o','sinc_o','intel_o','fun_o','amb_o','shar_o',]]
y=clean_df['match']

oversample = imblearn.over_sampling.SVMSMOTE()
X, y = oversample.fit_resample(X, y)

# 做训练集和测试集分割
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=0, stratify=y)

数据准备好之后,我们就可以进行模型的构建和训练了。通过以下代码,我们可以构建一个简单的逻辑回归的模型,并在测试集上来测试。

# logistic regression classification model
model = LogisticRegression(C=1, random_state=0)
lrc = model.fit(X_train, y_train)
predict_train_lrc = lrc.predict(X_train)
predict_test_lrc = lrc.predict(X_test)
print('Training Accuracy:', metrics.accuracy_score(y_train, predict_train_lrc))
print('Validation Accuracy:', metrics.accuracy_score(y_test, predict_test_lrc))
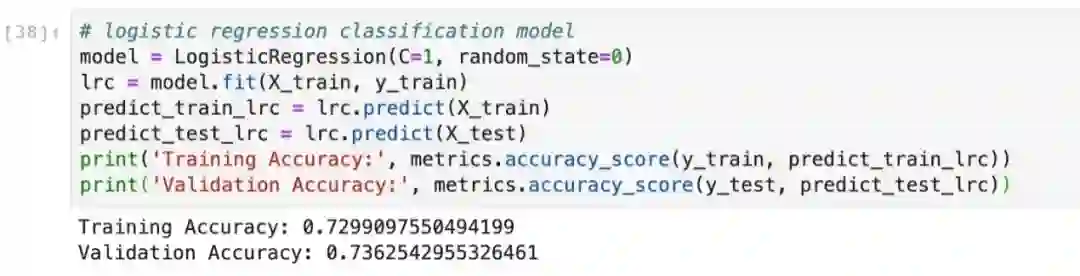

我们可以看到结果为 0.83 左右,这样我们就完成了一个预测在快速相亲中是否能够成功配对的机器学习模型。

针对这个模型,数据科学老司机我还专门制作了一个小游戏页面 ,来测试你的相亲战斗力指数。快来体验吧!

点击阅读原文链接进入 PAI-DSW 动手实验室,开始测试你的「一见钟情指数」!


参考文献:

[1]、https://tianchi.aliyun.com/specials/promotion/dsw-hol?referFrom=jiqizhixin/

[2]、https://dsw-dev.data.aliyun.com/#/

[3]、https://faculty.chicagobooth.edu/emir.kamenica/documents/genderDifferences.pdf

[4]、https://pai-public-data.oss-cn-beijing.aliyuncs.com/speed_dating/Speed%20Dating%20Data%20Key.doc

[5]、https://pai-public-data.oss-cn-beijing.aliyuncs.com/speed_dating/Speed%20Dating%20Data%20Key.doc

[6]、https://imbalanced-learn.readthedocs.io/en/stable/generated/imblearn.over_sampling.SVMSMOTE.html

登录查看更多

0

相关内容

哥伦比亚大学(ColumbiaUniversity),位于美国纽约市曼哈顿,1754年成立,属于私立的常春藤盟校。由三个本科生院和十三个研究生院构成。现有教授三千多人,学生两万余人,校友25万人遍布世界150多个国家。学校每年经费预算约20亿美元,图书馆藏书870万册。
流畅的Python 中英文版 PDF 高清电子书
专知会员服务
84+阅读 · 2020年8月2日
清华大学《人工智能》书籍教学课件开放下载
专知会员服务
148+阅读 · 2020年7月27日
【资源】100+本免费数据科学书
专知会员服务
110+阅读 · 2020年3月17日
【经典书】Python数据数据分析第二版,541页pdf
专知会员服务
200+阅读 · 2020年3月12日
 第八届中国科技大学《计算机图形学》暑期课程课件
专知会员服务
62+阅读 · 2020年3月4日
【2020新书】数据科学:十大Python项目,247页pdf
专知会员服务
216+阅读 · 2020年2月21日
分析 | 抖音背后的计算机视觉技术
计算机视觉life
9+阅读 · 2019年5月31日
Kaggle实战,10 分钟开启机器学习之路
机器学习算法与Python学习
4+阅读 · 2019年5月17日
【实战分享】电影推荐系统项目实战应用
七月在线实验室
35+阅读 · 2019年3月7日
那个要让程序员财务自由的李奥,招人了!
交易门
3+阅读 · 2018年7月13日
薪水你自己填-番外篇
待字闺中
4+阅读 · 2018年6月13日
周末深夜,学妹说她想做Python数据分析师
机器学习算法与Python学习
4+阅读 · 2018年6月7日
Arxiv
8+阅读 · 2019年3月21日
Conditional BERT Contextual Augmentation
Arxiv
8+阅读 · 2018年12月17日
Attend More Times for Image Captioning
Arxiv
6+阅读 · 2018年12月8日
Arxiv
3+阅读 · 2018年10月18日
Arxiv
7+阅读 · 2018年1月24日
Arxiv
4+阅读 · 2015年8月25日
VIP会员
最新内容
《衡量语言模型中的作战规划能力》
专知会员服务
1+阅读 · 今天14:34
Maven智能系统:帕兰提尔军事人工智能平台详解
专知会员服务
2+阅读 · 今天14:21
《测试自动化框架在敏捷软件开发中的角色》
专知会员服务
1+阅读 · 今天14:09
俄罗斯如何拦截乌克兰无人机与巡航导弹
专知会员服务
9+阅读 · 10月15日
《武器-目标分配问题:精确与近似求解算法》
专知会员服务
14+阅读 · 10月15日
综述|谁来改进机器人?迈向物理递归自我改进
专知会员服务
11+阅读 · 10月14日
软件定义无人机蜂群给防空带来全新压力
专知会员服务
10+阅读 · 10月13日
相关VIP内容
流畅的Python 中英文版 PDF 高清电子书
专知会员服务
84+阅读 · 2020年8月2日
清华大学《人工智能》书籍教学课件开放下载
专知会员服务
148+阅读 · 2020年7月27日
【资源】100+本免费数据科学书
专知会员服务
110+阅读 · 2020年3月17日
【经典书】Python数据数据分析第二版,541页pdf
专知会员服务
200+阅读 · 2020年3月12日
 第八届中国科技大学《计算机图形学》暑期课程课件
专知会员服务
62+阅读 · 2020年3月4日
【2020新书】数据科学:十大Python项目,247页pdf
专知会员服务
216+阅读 · 2020年2月21日
相关资讯
分析 | 抖音背后的计算机视觉技术
计算机视觉life
9+阅读 · 2019年5月31日
Kaggle实战,10 分钟开启机器学习之路
机器学习算法与Python学习
4+阅读 · 2019年5月17日
【实战分享】电影推荐系统项目实战应用
七月在线实验室
35+阅读 · 2019年3月7日
那个要让程序员财务自由的李奥,招人了!
交易门
3+阅读 · 2018年7月13日
薪水你自己填-番外篇
待字闺中
4+阅读 · 2018年6月13日
周末深夜,学妹说她想做Python数据分析师
机器学习算法与Python学习
4+阅读 · 2018年6月7日
相关论文
Arxiv
8+阅读 · 2019年3月21日
Conditional BERT Contextual Augmentation
Arxiv
8+阅读 · 2018年12月17日
Attend More Times for Image Captioning
Arxiv
6+阅读 · 2018年12月8日
Arxiv
3+阅读 · 2018年10月18日
Arxiv
7+阅读 · 2018年1月24日
Arxiv
4+阅读 · 2015年8月25日
Top
微信扫码咨询专知VIP会员