
导读
能回答视频问题、生成流畅画面,是否意味着模型已经理解了世界?牛津大学、新加坡国立大学、南洋理工大学和加州大学默塞德分校研究者,在这篇102页综述中提出统一视角:视频只是潜在动态世界的局部、有损、有时间顺序的观测,真正需要检验的是模型如何表示并预测观测背后的状态。 文章用“读取、写入、共享、交互”连接视频理解、生成、统一模型与世界模型,覆盖任务、表示、架构、训练、应用和评估。关键判断是:视觉逼真、局部时间连贯、世界状态一致,以及决策有效,是不同层次的证据。 看起来合理的未来,不一定响应了正确的动作,更不一定能够指导可靠控制。 本文按照原论文九章及主要小节顺序整理;细分方法以中文段落归纳,重点保留第6—8章的统一建模、交互与未来挑战。原文为综述,没有新增统一性能实验,以下不把不同论文的结果混成一个排行榜。 论文信息
英文题目 Reading, Writing, Sharing, and Interacting with the World through Video 作者 Shengqiong Wu、Meng Luo、Bobo Li、Ziwei Liu、Shuicheng Yan、Ming-Hsuan Yang、Philip Torr、Hao Fei。前两位共同第一作者,Hao Fei为项目负责人及通讯作者。 版本 arXiv v1,2026年10月22日提交;102页、17幅图、19张表。arXiv页面未注明会议接收信息。 原文 https://arxiv.org/abs/2610.31668 全文 https://arxiv.org/pdf/2610.31668 项目 https://vid-gen.github.io/video-world-model-survey 资源库 https://github.com/vid-gen/awesome-video-world-model
1 Introduction|引言
视频记录实体、关系和动作随时间变化,也可结合音频、语言与工具反馈。研究从动作识别和时空编码器,发展到视频语言模型、大规模生成器、理解生成统一系统,以及动作条件预测和交互仿真。 它们共同涉及观测与世界的关系,却不能因使用相似视频数据就被认定具有同样能力。生成器可以依据描述合成片段,世界模型还应预测状态如何在条件、动作和反馈下演化。模型设计支持什么、训练数据监督了什么、评估真正证明什么,必须分开。
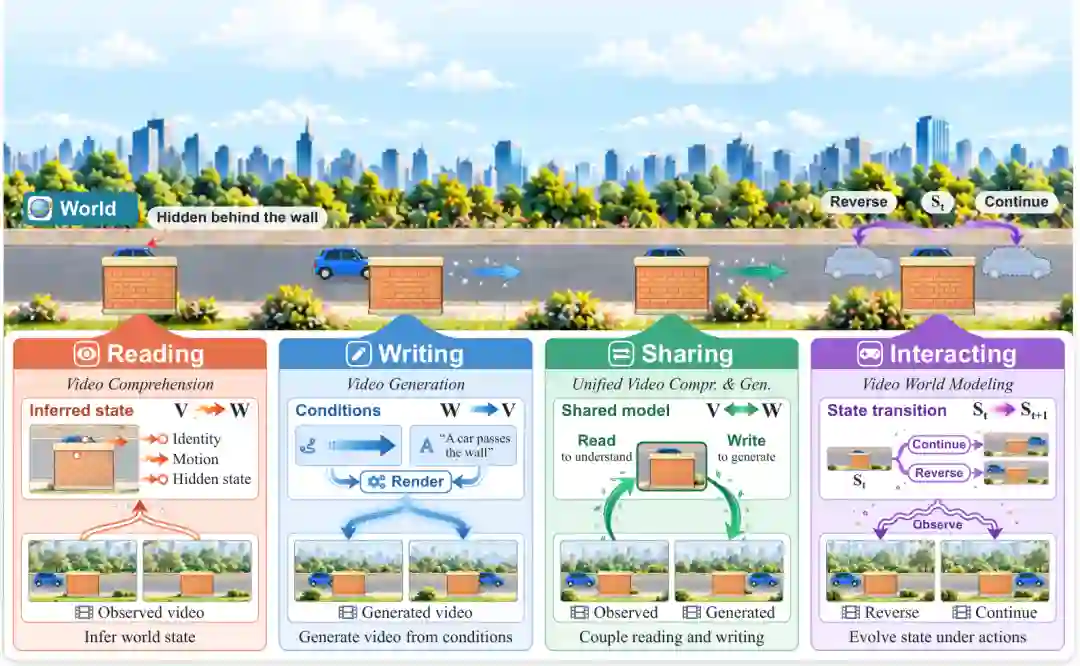
图1:通过视频读取、写入、共享与交互世界。遮挡后的车辆仍涉及身份和运动状态;四条路径分别侧重属性推断、条件生成、理解生成联系与动作驱动演化。来源:原论文首页总览,PDF第1页。
2 The World-Modeling Lens|世界建模视角
2.1 世界、视频与模型表示状态
潜在世界包含实体、属性、关系及动力学变量;视频由相机和感知过程产生,只显示其中一部分。不同真实状态可能对应相同画面,压缩、剪辑和分辨率又会损失信息。 模型从历史观测与动作构建的状态,不等于真实世界状态。它可能是显式几何、视频词元或隐特征,也可能并不完整。因而“有一个潜在向量”本身不是已经恢复物理状态的证据。
2.2 两种一致性
时间连贯性关注相邻画面的运动、外观和闪烁;世界一致性关注整段轨迹能否符合身份持续、空间关系、动力学及指定干预。 两者互不蕴含。物体离开画面后换了身份,回来仍可能很平滑;电影硬切镜头不平滑,却可以展示同一个一致世界。世界一致性的形式定义是评价目标,不是直接可计算的万能指标,需要遮挡、重访和干预等具体测试。
2.3 四种操作
读取从视频估计语义、空间、时间、物理或因果属性;写入从文本、图像、声音、轨迹等部分条件生成视频;共享在理解和生成之间连接参数、表示、接口或目标;交互则按动作与新观测更新预测状态。 这些不是互斥标签。交互系统也会读取历史和生成画面。共享还要区分“一个系统能做两种任务”“真正共享组件”与“同资源条件下产生功能协同”,不能混为一谈。
3 Preliminaries|预备知识
3.1 视频场景
短片、长视频、第一人称、多镜头、多模态和流式输入,对状态提出不同要求。离线模型可看完整片段,在线模型只能用当前及过去观测;驾驶和机器人还受动作频率、时延与安全约束。评估结论应注明观察条件。
3.2 视频大语言模型
典型系统用视频编码器提取帧或片段特征,经连接器进入语言模型,再通过对齐和指令学习回答问题。采样、压缩、时间编码和记忆决定长视频中哪些证据实际进入推理。 语言回答正确不保证依据视频:文本先验、单帧和静态外观都可能形成捷径,需要专门对照。
3.3 生成建模基础
扩散学习去噪,流匹配学习从噪声到数据的速度场;自回归按次序预测离散或连续单元,掩码模型根据可见上下文恢复被遮位置。生成过程的步数,与视频世界中的时间不是同一个变量。
3.4 视频世界模型的分类
原文采用两个独立轴:预测空间是可解码观测还是视频导出的潜在状态;转换接口是被动预测、预先固定动作的条件预测,还是接受新反馈和新动作的交互。由此形成六类,而不是把所有视频生成器一概称为交互世界模型。
4 Video Comprehension|视频理解:读取世界
4.1 任务、数据与评估
理解任务按世界属性分为五维。语义识别对象、动作与事件;空间处理位置、身份、几何和遮挡;时间处理顺序、持续、边界与远距离依赖;物理处理接触、稳定、容纳和动力学;因果解释动作效果及反事实。 Kinetics、Video-MME、VSI-Bench、TemporalBench、Physion和CLEVRER等各提供不同证据。不能用综合问答分数替代所有维度。文本单独输入、只看单帧、打乱帧序和限制上下文,可揭示是否真正依赖视频和时间。近似画面但答案相反的样本,可进一步排除外观捷径。
4.2 视频表示学习与编码
对比学习拉近匹配视频或文本,适合语义对齐;掩码学习恢复像素或特征;预测学习从上下文预测未来或缺失表示;生成学习通过重建、续写或描述保留信息。几类可以重叠,分类依据是主要监督目标。 重建能力、文本对齐与可恢复物理状态也不等价。丢弃纹理可能有利识别,却不利生成;只优化语言匹配也可能损失定量物理变量。
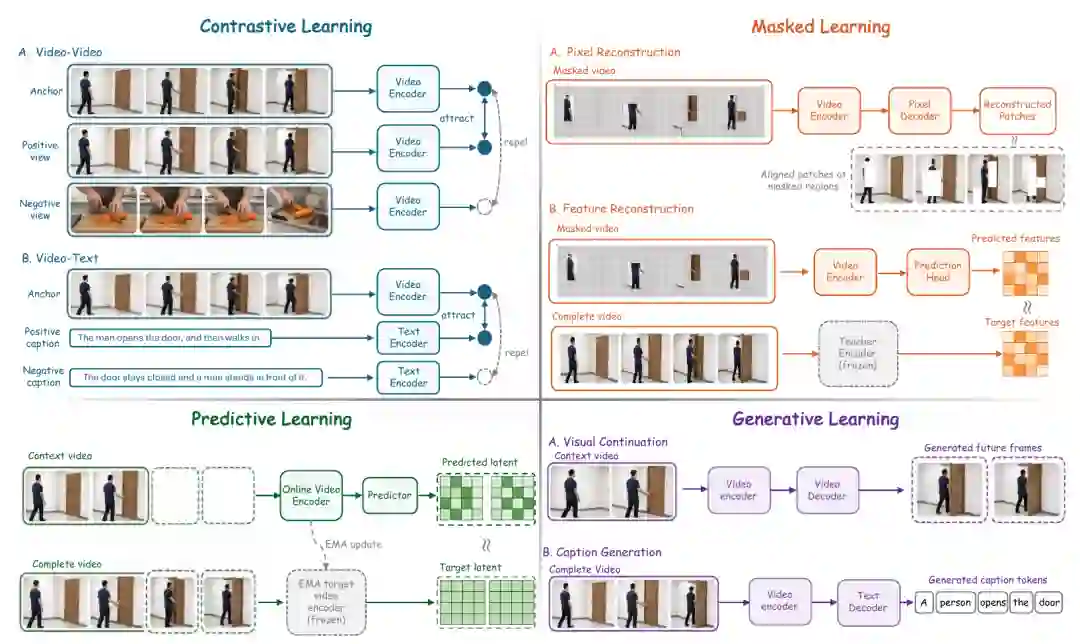
图2:对比、掩码、预测和生成学习。区别在于监督目标如何构造、哪些内容被隐藏,以及表示通过什么任务获得约束。来源:原论文图3,PDF第18页。
4.3 视频语言基础建模
架构要平衡视频编码、视觉词元压缩与语言推理。学习通常经历视觉语言对齐、指令训练和推理强化;测试时还可增加证据搜索、分段分析或推理预算。 更多计算只有在补足相关证据时才有价值,不能把语言推理链变长直接解释为世界知识更准确。长视频模型也应报告真正可用的历史,而不只是最大输入长度。
4.4 智能体式视频建模
视频智能体把观看转为迭代工作流:提出子问题、定位片段、调用检测、跟踪、语音识别或检索工具,再汇总证据。外部记忆有助于处理超长历史和反复查询。 代价是工具输出、检索和中间摘要可能传播错误。应保留时间戳与来源,评估证据命中、调用成本和最终判断,而不只看答案流畅度。
4.5 应用
具身与第一人称感知需要保持物体、目标和动作上下文;自动驾驶需要区分自车、相机与其他参与者运动;医疗、工业等领域还要求专业约束和漏检控制。迁移到决策任务时,应检查实际效用,而不是仅沿用通用问答指标。
5 Video Generation|视频生成:写入世界
5.1 任务、条件与评估
文本、图像、视频前缀、音频、相机、轨迹和布局规定不同条件,模型补全未指定部分。评估至少分开感知质量、条件遵循、时间连贯和世界一致性;物理约束与控制响应需要专门测试。 同样漂亮的两段视频,可能只有一段遵守动作;单片段质量也不能证明跨镜头、遮挡或重访后状态保持。
5.2 视频潜在表示学习
连续潜在空间降低像素生成成本,离散词元适合序列建模;混合或语义对齐表示试图兼顾理解与生成。压缩必须权衡重建细节、运动、长度和语义组织。 仅按重建误差挑选编码器可能错过下游生成需要的结构。语义表示太抽象会丢失外观,过度保留像素又增加序列成本。
5.3 生成式视频基础建模
扩散与流模型适合连续潜在空间,自回归与掩码预测提供不同顺序和并行方式。它们还可与语言模型规划、分镜和智能体反复评价组合:生成机制与系统工作流是两层选择,不应互斥分类。 自回归会累积自身前缀误差,分块生成需要维持跨块身份与运动,多步采样又面临交互延迟。比较时应注明分辨率、长度、采样步数和硬件。
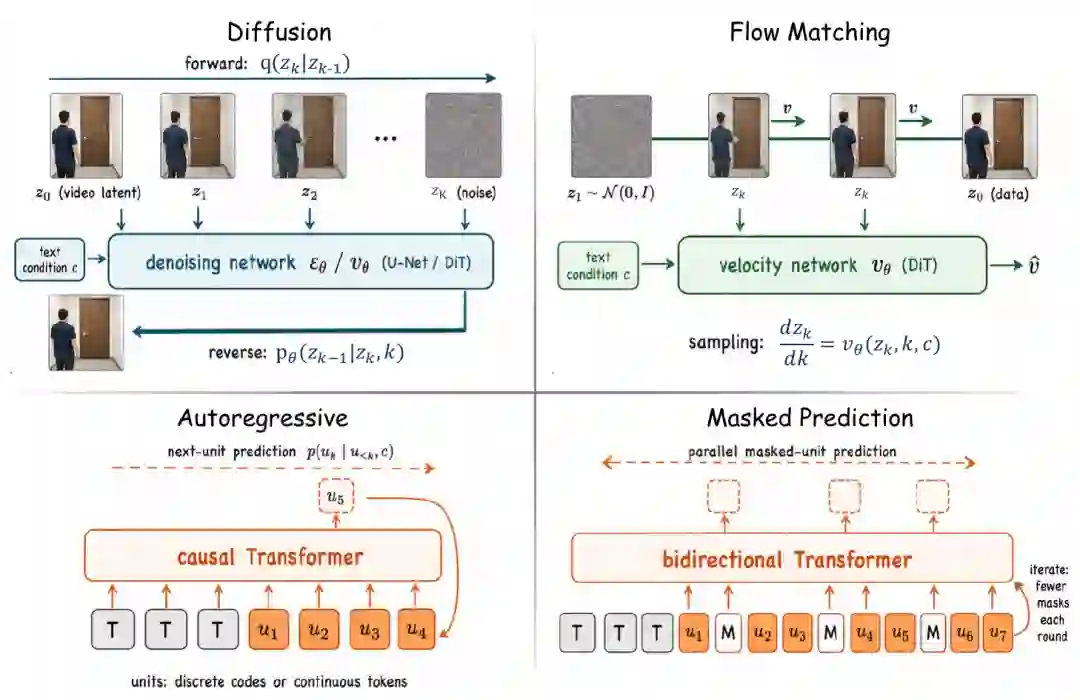
图3:扩散、流匹配、自回归和掩码预测。前两者学习连续生成路径,后两者按有序前缀或可见上下文预测单元。来源:原论文图5,PDF第32页。
5.4 控制策略
原文按干预位置区分注意力控制、适配器、潜在空间、拼接与上下文条件、引导以及调优。相机、姿态、对象身份和运动等信号可通过多条路线进入,同一系统也可组合使用。 有效控制应改变目标属性、保持无关属性,并让效果持续。调整一处运动却让背景或身份漂移,不能因画质高就算成功。控制组合还需检查相互干扰。
5.5 应用
应用包括创意制作、角色动画、具身视频计划与驾驶机器人合成数据。生成计划固定后不能自动响应新反馈,和可在线更新的仿真器不同。 合成数据应以真实感知或策略训练收益验证;具有视觉动作的片段,也不等于已经提供正确的机器人动作标签。生成器与逆动力学标注器可能共同放大错误。
6 Unified Video Models|统一视频模型:共享世界
6.1 统一架构
离散词元方案共享序列和自回归骨干,但量化与长序列成为瓶颈;连续方案共享潜在空间,通常保留不同输出头;模块化方案用语义桥连接理解与生成专家;智能体方案共享任务状态并编排感知、生成、编辑与评审工具。 Emu3、Show-o2、NExT-GPT、UniVideo等代表不同集成位置。模块化方便替换组件,却可能在桥接中丢失几何和运动;共享骨干也不自动消除理解所需不变性与生成所需细节之间的张力。
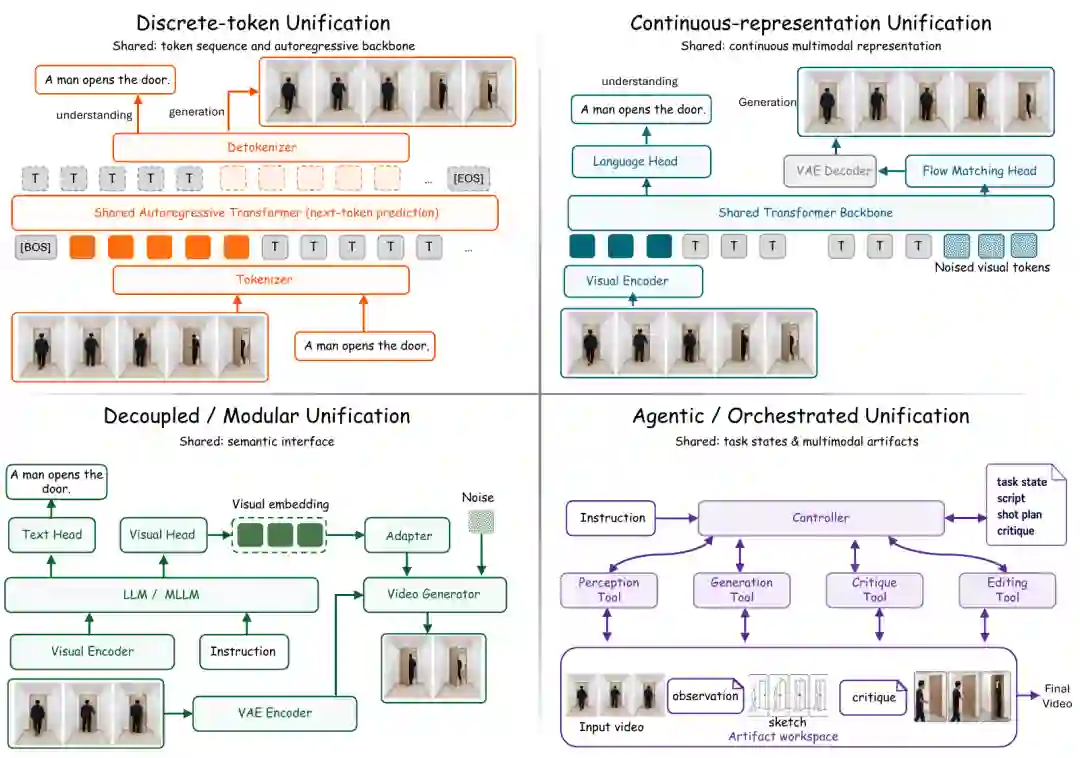
图4:离散词元、连续表示、解耦模块和智能体编排。共享的可以是骨干、表示、语义接口或任务状态;这些架构可以组合。来源:原论文图8,PDF第42页。
6.2 学习范式
独立学习连接分别训练的专家,便于作为集成基线;对偶学习利用双向重建或循环;共同学习联合优化共享组件;协同学习则要求一种方向确实帮助另一方向。 循环不是精确逆映射:同一描述允许多种视频,约束应保留任务相关身份、事件、视点与运动,同时容忍合理外观变化。联合训练改善两项分数,也可能只是多用数据和算力,需匹配资源和开关式对照确认跨方向信息贡献。
6.3 应用
指令编辑先理解原片再生成修改,生成式推理把预测中间状态交给后续分析,感知—生成—规划系统则把想象结果用于动作选择。 这些路径的中间产物应可检查,不能把答案直接藏在生成条件中,再据此宣称推理提升。工具链也要测试错误字幕、检索或评价如何影响最终输出。
6.4 评估
首先分别评估理解与生成,再评估交错、多轮和协同任务。能力覆盖只能证明“都能做”,共享参数只能证明“结构连接”,协同需要证明“连接带来收益”。 比较应固定任务、数据、模型容量、计算和观察预算,关闭目标传递路径做消融,并检查时间顺序、动作、身份和状态是否获得改善。图像领域协同结论不能直接替代视频时序证据。
7 Video World Models|视频世界模型:与世界交互
7.1 架构与训练范式
观测空间可直接预测未来帧或视频词元,潜在空间预测特征并按需规划;二者分别与被动、动作条件和在线交互结合。 被动模型学习动态先验但不识别指定动作效果;动作条件模型接收预测前固定的控制序列;交互模型在展开期间接收新动作和反馈。潜在预测不必解码出漂亮视频,若能保留决策相关状态也可有价值。反之,能生成动作条件视频,不代表已形成闭环控制。
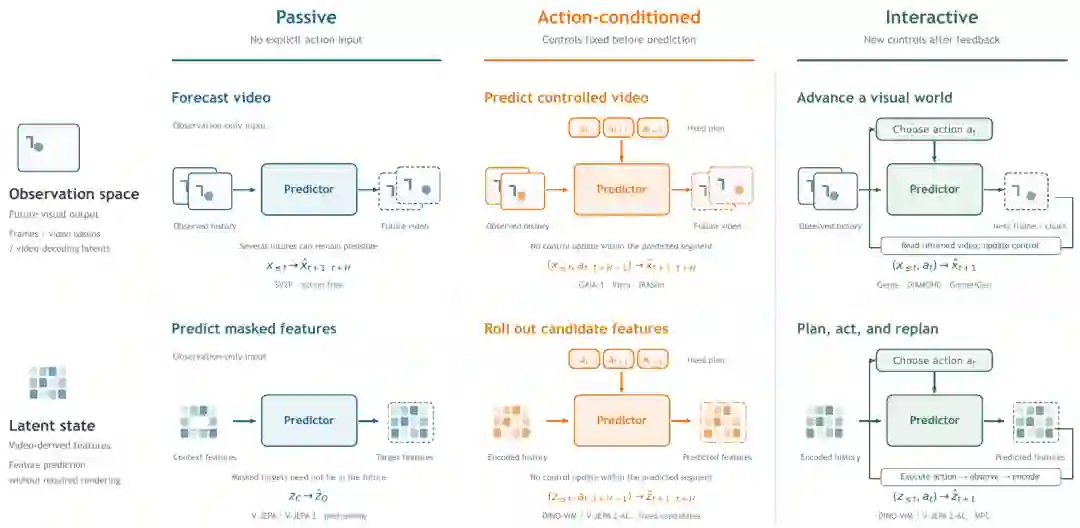
图5:视频世界模型的二乘三分类。纵轴区分观测和潜在状态,横轴区分被动、固定动作条件和交互,分别回答预测什么、控制何时进入。来源:原论文图10,PDF第50页。
7.2 核心技术挑战
动作控制应区分主体动作、相机与背景运动;长期记忆应保持遮挡身份和离屏变化,而非重复旧帧;实时响应需要满足控制预算,不只是离线高帧率;物理因果依据要求改变条件后效果正确、无关状态不变。 检索记忆、递归状态、滚动训练、因果生成和少步采样解决不同瓶颈。增加历史容量未必修复离屏动态,蒸馏提速也不能证明动力学准确,需分别检查收益和退化。
7.3 应用
世界模型可作为合成数据引擎、想象训练环境、策略评价环境、先预测再行动的规划器,或面向人的交互模拟器。 应用证据不能停在视频质量。训练环境应提高真实策略表现,评价环境应正确排序候选策略,规划器应改善动作决策。频繁重规划可能补偿预测器缺陷,因此还应报告固定候选动作排序等诊断。
7.4 基准与评估
挑战导向测试检查控制、记忆、时延及物理;应用导向测试检查训练、规划、策略评估;综合资源覆盖更多世界属性,但不同提示、预测跨度、动作空间和裁判使数字不宜直接横比。 观测模型需要画面和轨迹测试,潜在模型需要状态探针,两者最终都需决策效用。应同时报告展开长度、动作频率、硬件、分辨率、采样步数、延迟方差,并控制数据泄漏、裁判偏差与环境重叠。
8 Open Challenges and Future Directions|开放挑战与未来方向
8.1 长时程世界一致性
读取远处证据、记住不可见状态、让它继续正确演化,是不同能力。冰块在遮挡期间会融化,回放旧观察会恢复过时状态。未来记忆应预测隐藏变化,并与抑制展开误差的训练结合。 评估应分别改变展开长度和重访距离,报告退化曲线、记忆大小与时延,区分渲染漂移和状态丢失,而非只给终点总分。
8.2 物理与因果依据
识别物理规律、生成合理现象和正确响应物理干预,需要递进证据。固定初态、只改变重力或一个动作,应使目标轨迹变化,而相机、背景和无关属性保持。 物理先验、仿真、几何奖励和检索可提供监督,但都受外部信息质量限制。应以成对干预定位首次违规的约束与时间,而不是仅用笼统物理合理性评分。
8.3 统一视频模型的可测量协同
开放问题是收益来自信息共享,还是额外数据、参数和监督。可把跨方向路径设计成可独立关闭组件,用匹配资源比较事件理解是否改善运动生成、生成中间状态是否改善时间推理和规划。
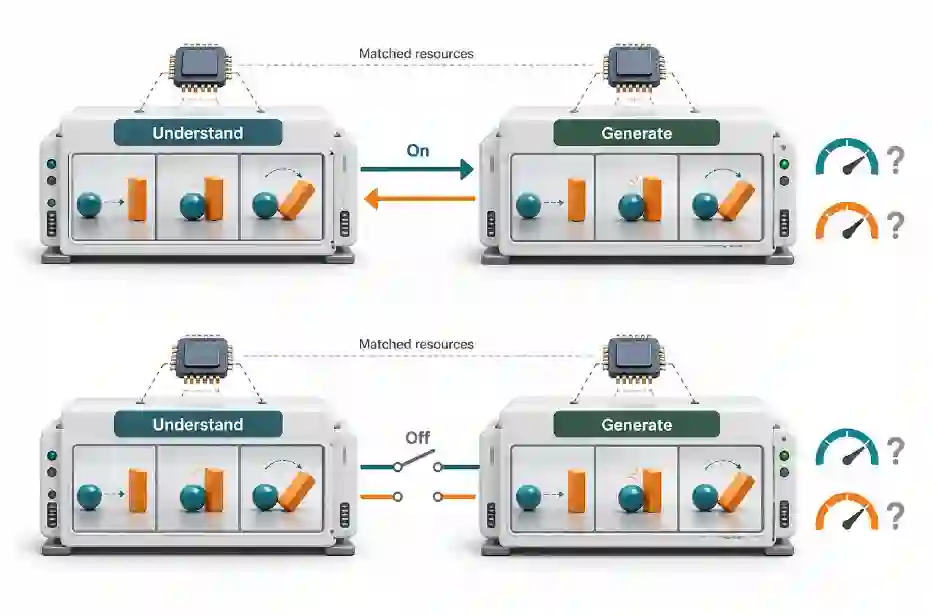
图6:保持资源一致,仅改变理解与生成之间的信息传递是否启用。两套系统的差异用于检验协同,而不是仅确认都能理解和生成。来源:原论文图13,PDF第62页。
8.4 世界属性的标准化评估
评估协议应匹配预测空间和交互接口:被动预测测未见转换,动作条件测固定控制响应,交互模型测途中干预和控制到显示延迟。视频与特征采用不同探针,却应面对共同决策测试。 还需标准化数据读取、规划器和环境变化,并用人工标注核验学习裁判。仅报告每秒帧数,无法说明控制响应是否及时或稳定。
8.5 从无标注视频扩展控制
互联网视频缺少真实动作标签。为重建而学习的潜在动作,可能同时编码抓手推动、相机摇移和背景运动,因此重建准确和码本利用率不是控制语义的充分证据。 少量标注可锚定真实控制,多视角和干预对可分离无关变化。伪动作只有在受控环境或真机产生预期效果时才有效,测试还应覆盖未见相机、背景、场景和身体。
8.6 跨场景与跨具身泛化
新房间与新机器人不是同一种泛化。身体、传感器、动作频率和自由度变化会改变同一命令的物理含义,不能把熟悉机型的新场景测试写成未知具身零样本迁移。 未来应以物体位移、接触和任务结果对齐动作效果,交叉留出场景与身体组合,并注明零样本、少量校准还是全面微调,以及目标数据量和安全表现。
8.7 随机世界与稀有事件
同一历史和动作可能有多种有效未来。能按提示生成碰撞,只提供一个案例,不代表知道真实碰撞概率。多样性也不能替代校准,多次采样只取最好结果会隐藏错误概率质量。 未来应以真实频率或合理仿真先验约束结果分布,在固定采样预算下报告校准、模式覆盖和适当评分,并区分无效与不可判读样本。稀有案例还需检查物理可行性、因果相关性和真实训练效用。
9 Conclusion|结论
综述把视频视作动态世界的观测轨迹,以读取、写入、共享与交互解释模型如何连接观测和状态。它没有把“画得像”升级为“懂世界”,而是要求更强主张对应更强证据。 未来进展不仅依靠更多视频,还需要遮挡重访、成对物理变化、共享路径消融、真实动作标签、跨场景具身留出与事件频率等干预证据。长期状态、可控效果、实时闭环和决策收益,应成为与画质并列的目标。 最值得记住的是:时间连贯属于视频轨迹,世界一致性属于轨迹背后的状态;真正的世界模型还要让预测转化为更好的行动。
原文链接 https://arxiv.org/abs/2610.31668 全文下载 https://arxiv.org/pdf/2610.31668 项目资源 https://vid-gen.github.io/video-world-model-survey 配图均截取原论文,保留图内原始文字,另附中文图题与来源页码。本文为压缩导读,细分方法和完整基准请参阅原文,不将不同设置下结果作统一排名。
 Reading, Writing, Sharing, and Interacting with the World through Video



相关内容

 微信扫码咨询专知VIP会员