深度强化学习智能体在即时战略游戏中达到了强劲的性能,但在面对训练分布之外的对手时可能显得脆弱。将战略命令选择与习得的单位控制相分离,使得在复用同一执行策略的前提下,能够针对不同对手选择不同的战略。这需要一个能够遵循不同命令的执行器,以及用于评估其是否遵循命令的可衡量标准。我们针对MicroRTS(一个即时战略环境)引入了一种带约束的命令条件化近端策略优化策略,即执行器。离散命令规定了跨多个环境步的经济、军队构成、军事姿态和工人政策的战略目标和行为要求;执行器决定用于实现这些目标的单位级行动。一个汤普森采样老虎机充当策略器,根据从游戏内观测而非对手身份构建的对手策略估计值来选择命令元组。在与使用相同架构、预算、课程和自我对弈联赛训练的平面PPO基线的受控比较中,策略器-执行器系统在一个训练地图上对阵四个最强对手中的三个(包括两个最强的留出对手)时胜率显著更高(分别为0.55对0.97和0.01对0.34),而与其他对手相比无显著差异。

即时战略游戏一直是展示强化学习进展的具有挑战性的基准,典型应用包括OpenAI Five和DeepMind的AlphaStar。尽管这些智能体通常达到超人的性能,但它们仍在几个方面存在局限性。首先,虽然可以对习得策略进行一些事后分析,但理解这些智能体为何做出特定决策或直接引导其行为仍然困难。其次,这些智能体表现出战略性脆弱:它们会针对近期训练对手进行优化,但面对近期未曾遇到的策略时会失败。这通常通过在自我对弈训练期间维持多样化的智能体种群来解决,这使得鲁棒性成为训练分布的一种属性,而非智能体在游戏时可自适应调整的东西。

将战略选择与单位控制相分离是对这两个问题的合乎逻辑的答案,但现有的分离方案各有牺牲。分层强化学习使目标明确,但通过奖励加成来激励遵循目标,这在对抗性游戏中会直接与获胜形成权衡,且没有给出是否遵循了目标的任何标准。基于组合搜索和程序化策略提供了一个可解释且可验证的选择空间,但依赖于脚本化执行,其在单位级控制上无法匹敌习得策略。

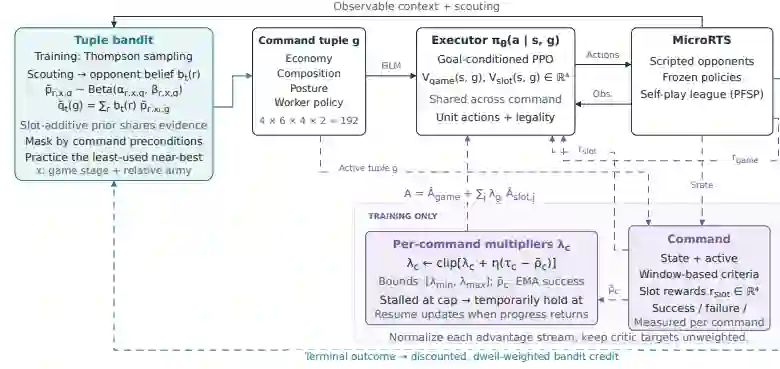
引入了一个围绕三个组成部分构建的战略控制框架:一个固定的、人类可读的命令空间,带有明确的、状态可衡量的成功标准;一个跨命令训练的执行器,在满足每个命令单独的成功率约束的前提下最大化游戏性能;以及一个策略器,它在不重新训练执行器的情况下,根据观察到的对手行为调整命令选择。我们在microRTS中评估该框架,这是一个用于年度IEEE游戏会议竞赛的RTS环境。强调以下主要贡献:

  • 一个具有可衡量结果的命令系统。 策略器选择一个四槽命令元组,涵盖经济、单位构成、军事姿态和工人政策,四个槽位共有16条命令。每条命令规定了何时可以下达以及执行器必须在执行窗口内实现什么目标,例如生产所要求的单位构成。游戏状态测量确定命令是成功、失败还是超时,从而允许我们衡量执行器遵循每条命令的可靠性,并通过固定命令来确定哪些策略能战胜哪些对手。
  • 一个带约束的命令条件化执行器。 一个强化学习策略,在满足每个命令单独的成功率约束的前提下最大化游戏性能。每个命令的拉格朗日乘子根据测量的达标差距进行调整,并对归一化的达标优势进行加权,同时设有针对持续停滞约束的启发式防护。
  • 一个基于观测的老虎机策略器。 一个老虎机策略器学习不同命令元组在不同对手行为下的表现,并通过其各自的命令在组合之间共享信息。在训练期间,它使用汤普森采样探索有前景和不确定的组合。在评估期间,冻结的策略器根据其习得的估计值和当前观测所提示的对手行为来选择命令元组,无需对手身份或重新训练执行器。
  • 与平面PPO的受控比较。 将完整的策略器-执行器系统与使用相同基础架构、环境步预算、课程和自我对弈联赛的平面PPO基线进行比较。我们的策略器-执行器在对阵四个最强对手中的三个时取得了显著更高的胜率,其中两个在训练期间未曾见过,而在对阵较弱对手时与平面PPO持平。
成为VIP会员查看完整内容
4

相关内容

《深度强化学习在兵棋推演中的应用》最新40页
专知会员服务
29+阅读 · 2月15日
《针对指挥控制强化学习智能体的对抗攻击》
专知会员服务
33+阅读 · 2月5日
《基于分层多智能体强化学习的逼真空战协同策略》
专知会员服务
49+阅读 · 2025年10月30日
《基于深度强化学习的战场策略》
专知会员服务
38+阅读 · 2025年1月13日
《战斗模拟中的强化学习》
专知会员服务
44+阅读 · 2024年12月10日
《指挥和控制强化学习智能体的对抗性攻击》
专知会员服务
73+阅读 · 2024年7月6日
《指挥和控制中强化学习智能体的对抗性攻击》
专知会员服务
74+阅读 · 2024年5月11日
强化学习《奖励函数设计: Reward Shaping》详细解读
深度强化学习实验室
20+阅读 · 2020年9月1日
探索(Exploration)还是利用(Exploitation)?强化学习如何tradeoff?
深度强化学习实验室
13+阅读 · 2020年8月23日
强化学习的两大话题之一,仍有极大探索空间
AI科技评论
22+阅读 · 2020年8月22日
Distributional Soft Actor-Critic (DSAC)强化学习算法的设计与验证
深度强化学习实验室
20+阅读 · 2020年8月11日
强化学习初探 - 从多臂老虎机问题说起
专知
10+阅读 · 2018年4月3日
【强化学习】强化学习+深度学习=人工智能
产业智能官
55+阅读 · 2017年8月11日
国家自然科学基金
348+阅读 · 2017年12月31日
国家自然科学基金
44+阅读 · 2015年12月31日
国家自然科学基金
5+阅读 · 2015年12月31日
国家自然科学基金
24+阅读 · 2015年12月31日
国家自然科学基金
50+阅读 · 2013年12月31日
国家自然科学基金
19+阅读 · 2012年12月31日
国家自然科学基金
11+阅读 · 2012年12月31日
国家自然科学基金
23+阅读 · 2009年12月31日
国家自然科学基金
50+阅读 · 2009年12月31日
国家自然科学基金
12+阅读 · 2008年12月31日
VIP会员
相关主题
最新内容
军事域更好使用人工智能的实用指南
专知会员服务
6+阅读 · 10月22日
《衡量语言模型中的作战规划能力》
专知会员服务
11+阅读 · 10月20日
Maven智能系统:帕兰提尔军事人工智能平台详解
专知会员服务
12+阅读 · 10月20日
《测试自动化框架在敏捷软件开发中的角色》
专知会员服务
8+阅读 · 10月20日
俄罗斯如何拦截乌克兰无人机与巡航导弹
专知会员服务
11+阅读 · 10月15日
《武器-目标分配问题:精确与近似求解算法》
专知会员服务
16+阅读 · 10月15日
现代电磁战:集成式系统簇时代如何实现频谱优势
综述|谁来改进机器人?迈向物理递归自我改进
专知会员服务
12+阅读 · 10月14日
相关VIP内容
《深度强化学习在兵棋推演中的应用》最新40页
专知会员服务
29+阅读 · 2月15日
《针对指挥控制强化学习智能体的对抗攻击》
专知会员服务
33+阅读 · 2月5日
《基于分层多智能体强化学习的逼真空战协同策略》
专知会员服务
49+阅读 · 2025年10月30日
《基于深度强化学习的战场策略》
专知会员服务
38+阅读 · 2025年1月13日
《战斗模拟中的强化学习》
专知会员服务
44+阅读 · 2024年12月10日
《指挥和控制强化学习智能体的对抗性攻击》
专知会员服务
73+阅读 · 2024年7月6日
《指挥和控制中强化学习智能体的对抗性攻击》
专知会员服务
74+阅读 · 2024年5月11日
相关基金
国家自然科学基金
348+阅读 · 2017年12月31日
国家自然科学基金
44+阅读 · 2015年12月31日
国家自然科学基金
5+阅读 · 2015年12月31日
国家自然科学基金
24+阅读 · 2015年12月31日
国家自然科学基金
50+阅读 · 2013年12月31日
国家自然科学基金
19+阅读 · 2012年12月31日
国家自然科学基金
11+阅读 · 2012年12月31日
国家自然科学基金
23+阅读 · 2009年12月31日
国家自然科学基金
50+阅读 · 2009年12月31日
国家自然科学基金
12+阅读 · 2008年12月31日
微信扫码咨询专知VIP会员