
探索孪生神经网络:请停止你的梯度传递!
关于写东西,因年中比较大变动,荒废了。人一懒下来就没个头,想着不能一直这样下去,决定从简单做起,真正阻拦写东西的是,每次一想到写完之后,排版润色一下几个小时就出去了,头疼。
那就先从写开始,慢慢先习惯写点东西,就像康复训练,也不管有没有人读。于是乎,也写了有一俩月了。
最近和朋友聊到,写东西不要追求量,要追求质,一个爆款就能吸很多粉,虽然自己很佛系,但想想也是这么个道理。
于是,开始改变风格,慢慢写。
...数日后...
于是就忙到像这次,中间空一天,周末再出去滑个雪,就好几天过去。
前段时间,都在读 EMNLP 一些论文,虽然也有很多不错论文,但都没有一篇能比上这篇 CV 领域论文带给我的喜悦。
这篇论文最开始吸引我的点,当然就是作者栏,正是恺明大神(膜拜),而一作陈鑫磊, CMU 毕业的博士大佬。此外,这是篇来自 FAIR (Facebook AI 研究院)的论文,而 FAIR 论文,总给我一种朴实无华但又干货满满的感觉。
首先这篇论文,标题说研究孪生网络,但其实和最近很火的对比学习(Contrastive Learning)息息相关。因此比较的方法模型也都是对比学习中的前辈们,比如顶顶大名的出自 Hinton 的 SimCLR,还有非常神奇如同自己给自己提起来的 BYOL 模型,然后就是前段时间同样出自 FAIR 的 SwAV.
读这篇论文,也可以同时参考上面提到的三个模型,都是非常有意思的论文,尤其 BYOL.
[SimCLR] A Simple Framework for Contrastive Learning of Visual Representations: https://arxiv.org/abs/2002.05709v1
[BYOL] Bootstrap Your Own Latent: A New Approach to Self-Supervised Learning: http://arxiv.org/abs/2006.07733
[SwAV] Unsupervised Learning of Visual Features by Contrasting Cluster Assignments: http://arxiv.org/abs/2006.09882
这些论文总体来说都是在解决一个问题,怎么用孪生网络来进行自监督对比学习,保证训练不会出现崩塌(collapsing)情况下,获得比较好的表示。所谓崩塌,也就是模型为了偷懒,无论什么图片都会输出同样表示,这样结果 loss 很小,然后却没学到任何东西。
怎么做?停止梯度就好了,So Easy!
这篇论文提出的模型叫做 SimSiam(Simple Siamese)网络,事实上正如其名,真的蛮 Simple 的。
模型整体架构很简单,如下图
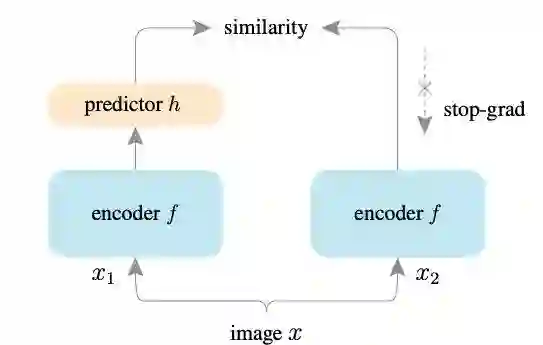
几句话也就能解释完,
-
首先一张图片 x,如一般对比学习的套路,用图片增强的算法获得两张增强过后的图x1和x2 -
接着,朴实无华地直接将两张图片输入编码器 f,如孪生网络一般设置,两个编码器共享参数,拿到两个表示z1和z2 -
之后将 z1过一个 预测 (prediction) 头,就是个双层的 MLP 网络,拿到p1 -
最后用这个表示 p1和之前获得的z2计算一个余弦相似度(Cosine Similarity) -
优化时,最大化该相似度就行,等同于最小化负余弦相似度
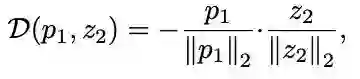
-
于是我们就完成一半了,将上面的损失作为 L1 -
接着从第 3 步,将 z1换成z2过预测头,同样过程获得p2,接着如第 4 步p2和z1计算余弦相似度,获得损失L2。就是个 对称过程。 -
最后,总损失为
即论文中的
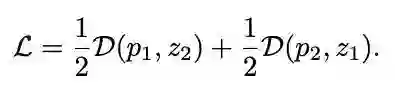
到目前为止还只是个前向过程,还不是最关键的点,最关键点是在反向过程。该篇论文中最关键的 idea:对右端的模型停止梯度传播(Stop-Gradient)
就如结构图里表示的一样,而反应在公式则会成为
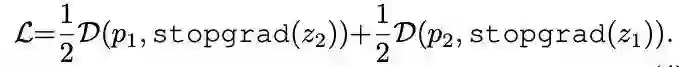
这就是 SimSiam 的大致结构和整个过程了。
非常简单明了是吧。
模型细节:平凡产生不平凡
关于一些实现细节。
编码器 f 是由一个 backbone(主干) 网络加一个 Projection(投影) MLP 头组成,而 backbone 由 ResNet-50 来担当。而 MLP 头则是三层 MLP,每层都有 BN (Batch Normalization),前两层有 ReLU,输出层没 ReLU.
最后还有将特征 z 转换成 p 的 预测 MLP 头,有两层,中间隐层维度小些,第一层有 BN 和 ReLU,输出层没有 BN.
之后实验有对 MLP 层为什么如此设置做对比实验,可以暂且按下好奇心。
So—,Why it works?
至此,基本结构以及细节就介绍完了,看上去平平无奇。它既没用到 SimCLR 的负样本对,也没 SwAV 的聚类算法,也没 BYOL 的 momentum encoder。只是在孪生网络的一边不传递梯度。
但事实上,它又是很 work 的。
不光让训练变得稳定了,而且和其他方法也能有得一比,同时对各种参数的要求也更少。
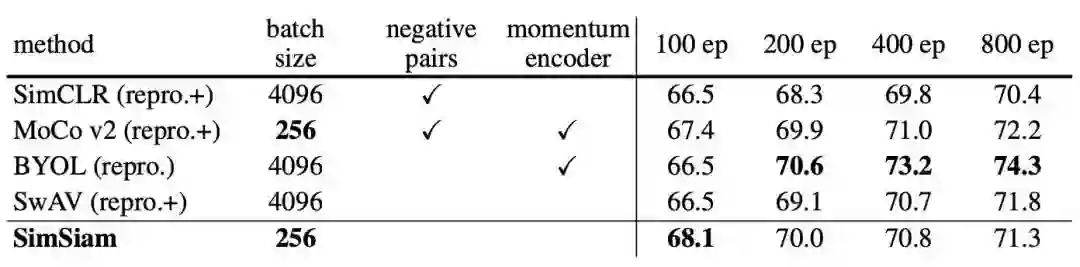
看到只有 BYOL 比它好很多,从之后的实验看,可以认为 BYOL 是它的一个改进版本。
首先说模型的原理,以及从中推导出的 Stop-Gradient 为什么是 work 的。
先考虑如下形式的损失函数
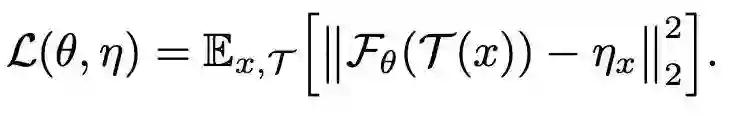
这里 是参数为 的神经网络,可以理解为上面讲的编码器模型,而 T 则是一个图片增强操作。至于 则是图片 x 的表示,不一定需要是神经网络输出。所以上式中,MSE 的两个部分,前面可理解为之前孪生网络的左边,而后面的 可理解为模型右边。
式中的两个参数就是 和 ,而优化损失函数的过程就是优化这俩参数。
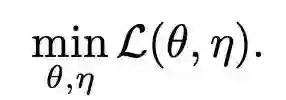
于是可以将这个优化过程类比成 k-means 聚类一样的优化过程,利用的是类似 EM (Expectation-Maximization) 的优化过程。
给优化看出两个阶段,E 阶段和 M 阶段,而简单说就是将整体优化分成
-
先优化
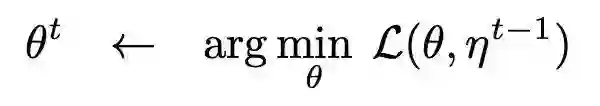
-
再优化
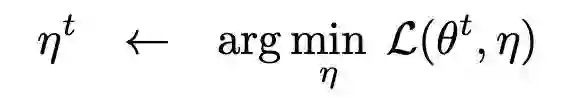
对前一步,因为 是神经网络模型的参数,所以自然直接用梯度下降就能优化。而对于后一步,因为是损失函数是 MSE,所以也好解,直接求导最小值
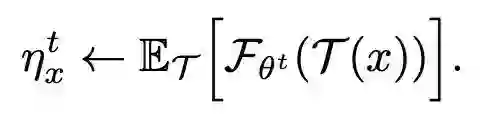
所以 的最优值是图片 x 增强之后,再过模型获得表示的一个平均表示。
但因为这个平均表示并不好拿到,所以这里是直接用单步的结果来进行估算,其实也就是上面模型介绍里面的过程,对图片增强一次,直接过模型拿到表示
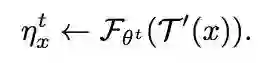
这样就大致获得了 SimSiam 的形式。而此时再理解模型右端为啥要用 Stop-gradient 就自然而然了,因为在是优化过程中,它并不需要反向传播的信息,优化 的时候 是被看成是常数的。
当然还有一些地方没有进行解释,比如预测头。
下面就来分析一下,预测头,以及其他一些因素,比如对称的影响。
分析实验:预测头?批大小?BN?相似函数?对称?
预测头
关于预测头的分析是模型中各部分分析最有意思的地方了。其实在对比学习中,很多模型都发现额外加一个简单的 MLP 头能对性能提升很大。
这里怎么解释预测头为什么 work 呢?
首先,先对模型做经验实验,分别用没有预测头的,和有预测头但固定随机初始化参数的,和原有进行对比。
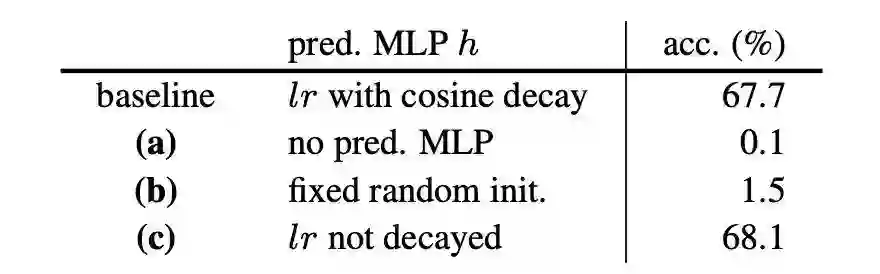
结果发现,仅仅只是少了个 MLP 预测头,结果就天差地别,根本就不能收敛。
于是重新回顾上一小节的推导过程,到底是什么地方出错了呢,扫过来,发现只有一个地方是有明显问题的,按照推导 理当是
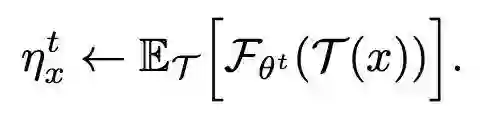
但为了方便计算我们是直接用了
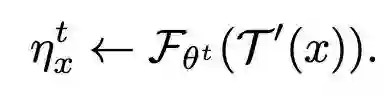
来估算的。所以只可能是这个地方出的问题,用单张图片的结果来估算整体平均导致的训练不稳定。因此可以提出如下假说
假说:预测头主要是学习一个函数,而这个函数可以大致理解为是一个从单次增强 x 的表示预测整体期望的函数。
真的是这样吗,作者们又做了如下实验来侧面验证,也就是用滑动平均来估算 期望
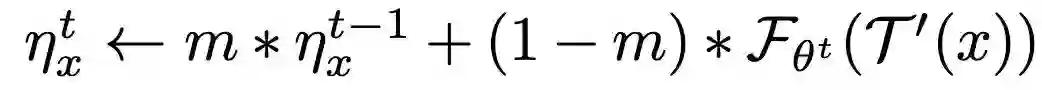
发现用上式,即使没有预测头也能获得 55% 的准确率,而如果没用滑动平均也没用预测头的时候就完全训练不起来。所以可以认为,预测头一定程度上是有承担这个计算期望的过程。
批大小
通过经验实验,作者们发现当前方法对批大小不怎么挑,不像之前一些方法会要求用大的批大小。
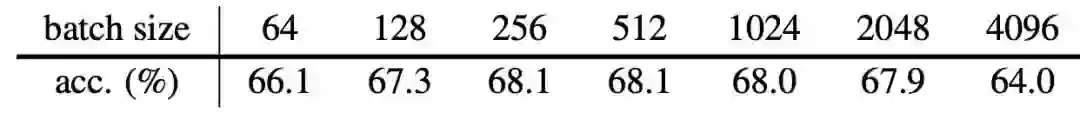
而且对优化器也没有特殊要求,比如要用 LARS 这样,这里直接用最 vanilla 的 SGD 就行,当然也发现 SGD 用大 batch 会表现有些不好。
Batch Normalization
相比在看模型架构的时候,有心的童鞋,也会和我看的时候一样,比较疑惑为什么两个 MLP 头里面 BN 和激活要这样设置。
于是作者也贴心的做了对比实验
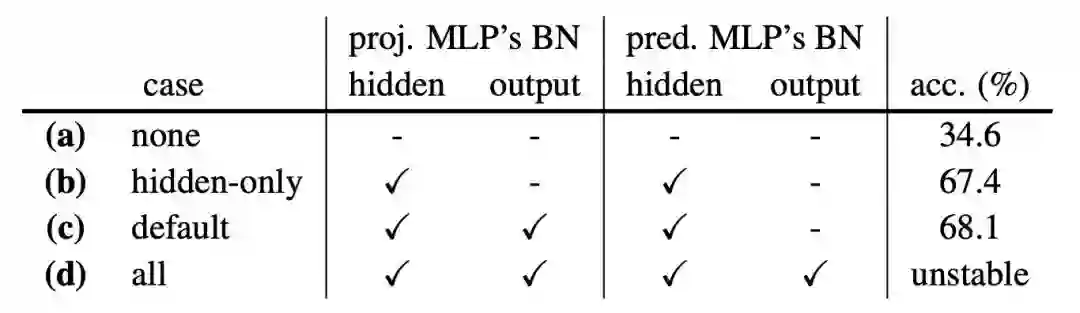
如表,发现就默认设置是最好的,至于为什么,经验实验嘛。
相似函数
对比学习中计算损失函数的时候因为要使用相似函数,所以这一块也可以稍微探索一下,比如说不用余弦相似,而用如 SwAV 一样的交叉熵相似。
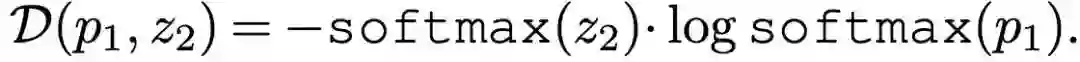
结果发现也能行,但是效果并没余弦相似好
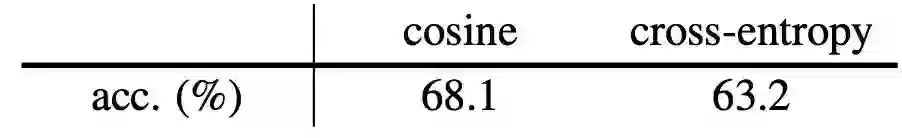
当然这也说明 Stop-gradient 策略和计算损失的相似函数没有什么关系。
对称
SimSiam 中计算损失的时候有一个对称过程,那这个对称是不是必要的呢。根据之前的分析推导,其实并没有说到对称嘛。
通过实验发现
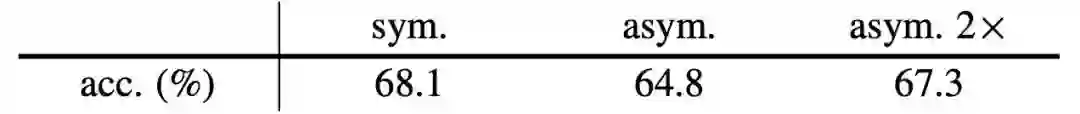
对称确实不是必要的,不对称并不是不能训练,只是性能低了些。
作者的解释是,对称过程其实就像是一个密集采样,可以让估算期望的时候更精确。而上表中最右边的实验就是不用对称形式,而是不对称形式进行两次采样,然后平均计算损失,性能只是差了些。
模型对比:胡乱的亲属关系
和之前对比学习模型的比较,其实看下图就行了
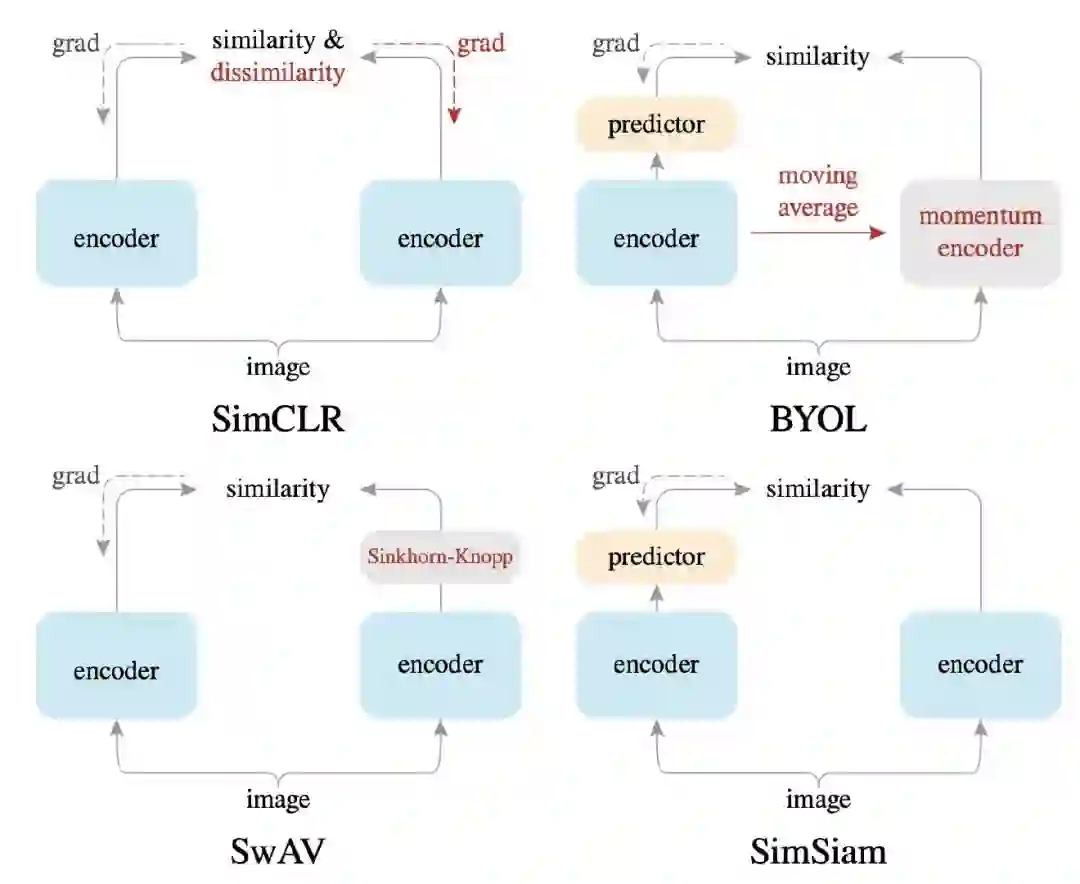
和 SimCLR 的不同主要就在于
-
首先当然是有 Stop-gradient -
其次没有负例对,也就是不计算 dissimilarity
和 SwAV 的不同主要在于
-
SwAV 在右端是用的 Sinkhorn-Knopp (SK) 变换便于聚类运算,而这里用的 stop-gradient
而和 BYOL 的不同感觉其实最小
-
BYOL 默认就是 stop-gradient,而右端的 encoder 用的是左边的滑动平均,其实也能理解为计算了一个更平滑的

由于微信平台算法改版,公号内容将不再以时间排序展示,如果大家想第一时间看到我们的推送,强烈建议星标我们和给我们多点点【在看】。星标具体步骤为:
(1)点击页面最上方"AINLP",进入公众号主页。
(2)点击右上角的小点点,在弹出页面点击“设为星标”,就可以啦。
感谢支持,比心
推荐阅读
征稿启示| 200元稿费+5000DBC(价值20个小时GPU算力)
完结撒花!李宏毅老师深度学习与人类语言处理课程视频及课件(附下载)
模型压缩实践系列之——bert-of-theseus,一个非常亲民的bert压缩方法
文本自动摘要任务的“不完全”心得总结番外篇——submodular函数优化
斯坦福大学NLP组Python深度学习自然语言处理工具Stanza试用
关于AINLP
AINLP 是一个有趣有AI的自然语言处理社区,专注于 AI、NLP、机器学习、深度学习、推荐算法等相关技术的分享,主题包括文本摘要、智能问答、聊天机器人、机器翻译、自动生成、知识图谱、预训练模型、推荐系统、计算广告、招聘信息、求职经验分享等,欢迎关注!加技术交流群请添加AINLPer(id:ainlper),备注工作/研究方向+加群目的。
阅读至此了,分享、点赞、在看三选一吧🙏



相关内容



 微信扫码咨询专知VIP会员