
导读
大模型迭代越来越快,评测却可能越来越重:每个版本都跑完整题库、完整基准套件,再调用昂贵裁判或人工复核。所有这些测试,都提供了不可替代的信息吗?中山大学研究者在《Are We Testing Too Much? A Survey of Benchmark Compression for Efficient Evaluation of Large Language Models》中梳理119篇研究,系统讨论如何以更低成本的部分评估,近似恢复完整评估的分数、排名或模型选择结果。 综述把研究组织为静态基准压缩、自适应评估、基准分析与基础研究,进一步比较信息需求、结果恢复、全生命周期成本和失效条件。它并不主张统一删掉某个比例的题目,也不认为“测得少”就等于“评得准”。 可靠压缩必须先确定要保留什么结果,再验证覆盖、估计和决策是否可信。 本文沿用原论文八章结构,保留主要小节,并结合附录解释方法选型与验证要点。这是一篇方法综述,不是推出一个新压缩算法,也没有在统一实验环境中给所有方法排出性能名次。 论文信息
英文题目 Are We Testing Too Much? A Survey of Benchmark Compression for Efficient Evaluation of Large Language Models 作者 Guoming Ling、Yupei Lin、Zhongzhan Huang、Junxin Li、Junjie Liu、Shanshan Zhong、Hefeng Wu、Liang Lin;单位为中山大学。 版本与范围 arXiv v1,2026年10月13日提交。原文31页,作者声明文献收集截止于2026年8月9日;arXiv页面未注明会议接收信息。 论文主页 https://arxiv.org/abs/2610.18248 完整论文 https://arxiv.org/pdf/2610.18248
1 Introduction|引言
基准是比较和改进大模型的重要工具,但重复测试不一定持续增加有效信息。已有研究在LongBench、GSM8K、MMLU等设置中发现,少于20%的样本也可能得到接近完整集合的结果。这是特定研究条件下的证据,不是对所有基准、模型和误差要求都成立的安全压缩率。
冗余会增加生成、判分、人工审核和开发等待成本。基准压缩因此关注:哪些评估单元值得执行,如何从部分结果估计完整结果,以及这种估计在新模型和新时期是否仍可靠。 自2024年以来,相关研究快速增长,但方法依赖的信息差异很大。有的只读题目文本,有的需要大量历史模型答题记录,有的先探测当前模型,还有的边测边调整。若只比较最终保留多少题,就会忽略历史校准、辅助信号、恢复模型和串行轮次的成本。 这篇综述的贡献,是以共同问题定义组织119篇研究,并提供跨方法比较与选型路线。它把效率放在可靠性的约束下讨论,而不是把缩短题库本身当成最终目标。
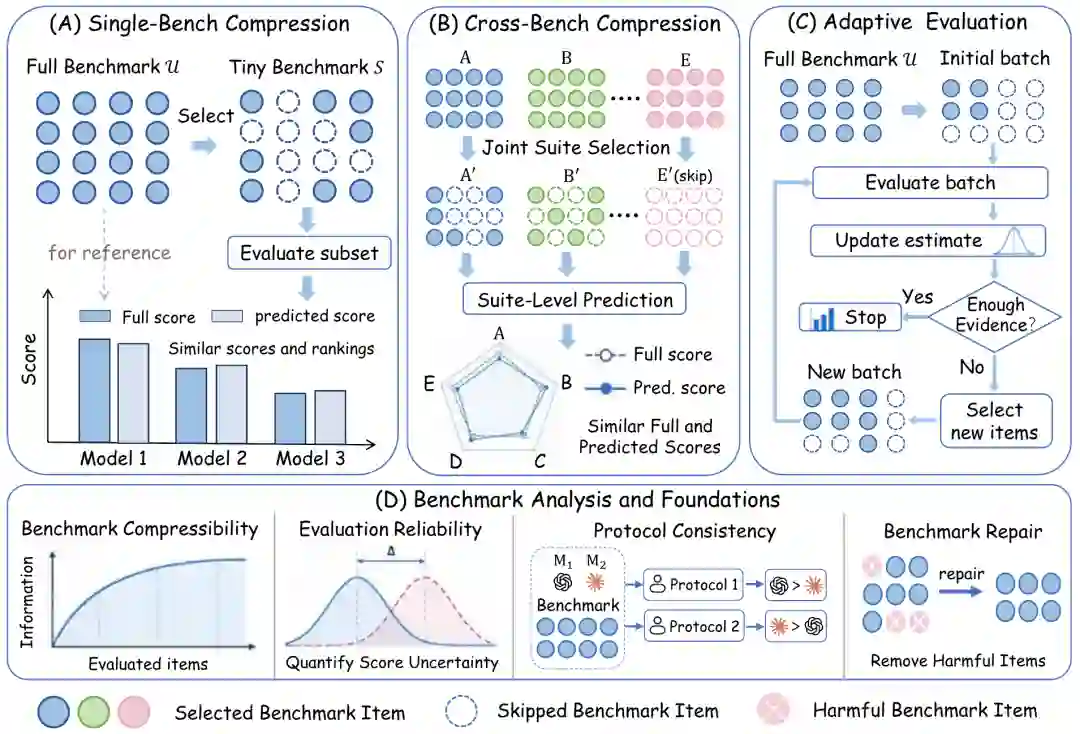
图1:综述的整体结构。单基准压缩选择代表子集,跨基准压缩联合减少多个任务的评估,自适应评估按已有结果继续测试,基础研究检查可压缩性、可靠性、协议一致性和基准修复。来源:原论文图2,PDF第2页。
2 Problem Formulation and Taxonomy|问题定义与分类体系
2.1 问题定义
首先固定完整评估:确定待测模型、测试协议、评估单元及聚合规则。单元通常是题目,也可以是一次人工判断、模型比较或智能体运行;完整评估对所有单元获得结果,再计算分数或排名。 压缩评估只执行成本较低的一部分单元,可以结合题目特征、历史回答或当前模型的廉价信号,再通过恢复规则估计完整结果。目标包含两个条件:结果差异不超过指定容忍度,同时在相同成本口径下比完整评估更便宜。
因此,评估单元、恢复方法和误差目标必须一起定义。保存整体排名,不等于精确恢复每个模型的分数;找出赢家,不等于恢复全部排名;一个短题库的平均分,也不天然代表原题库的平均分。 生成、裁判和智能体运行存在随机性时,还应区分“恢复某次完整运行结果”与“估计总体期望表现”。完整运行本身也可能有抽样误差,区间覆盖的是声明的统计目标,不一定是另一次完整运行的数值。
2.2 分类概览
论文按照有先后顺序的问题分类,而不是把所有属性混为一张平面清单。 第一,主要贡献是实际降低评估成本,还是研究冗余、测量与可靠性?后者归入基准分析与基础研究。第二,主评估开始后,已有结果能否改变后续测试、预算或停止点?可以则属于自适应评估,并按核心目标分为选题或序贯决策。 对于静态方法,再判断是否联合减少多个基准的工作量:是则属于跨基准压缩;否则属于单基准压缩。单基准方法又按必要信息分为内容驱动、历史响应驱动、目标模型条件驱动三类。 最终形成六类操作方法,加上一个基础研究类别。每篇论文获得一个主要标签,执行时机、范围、信息源、节省单元和输出类型则作为辅助属性。把同一方法分别应用到多个基准,不等于跨基准联合压缩;先用探针选定一批题,也不等于主评估中持续自适应。
3 Static Benchmark Compression|静态基准压缩
3.1 单基准压缩
单基准方法在主评估之前固定子集,用该子集的结果估计一个完整基准的表现。静态并不要求所有模型使用同一批题:若当前模型的廉价信号参与选题,每个模型可以有不同的固定子集。
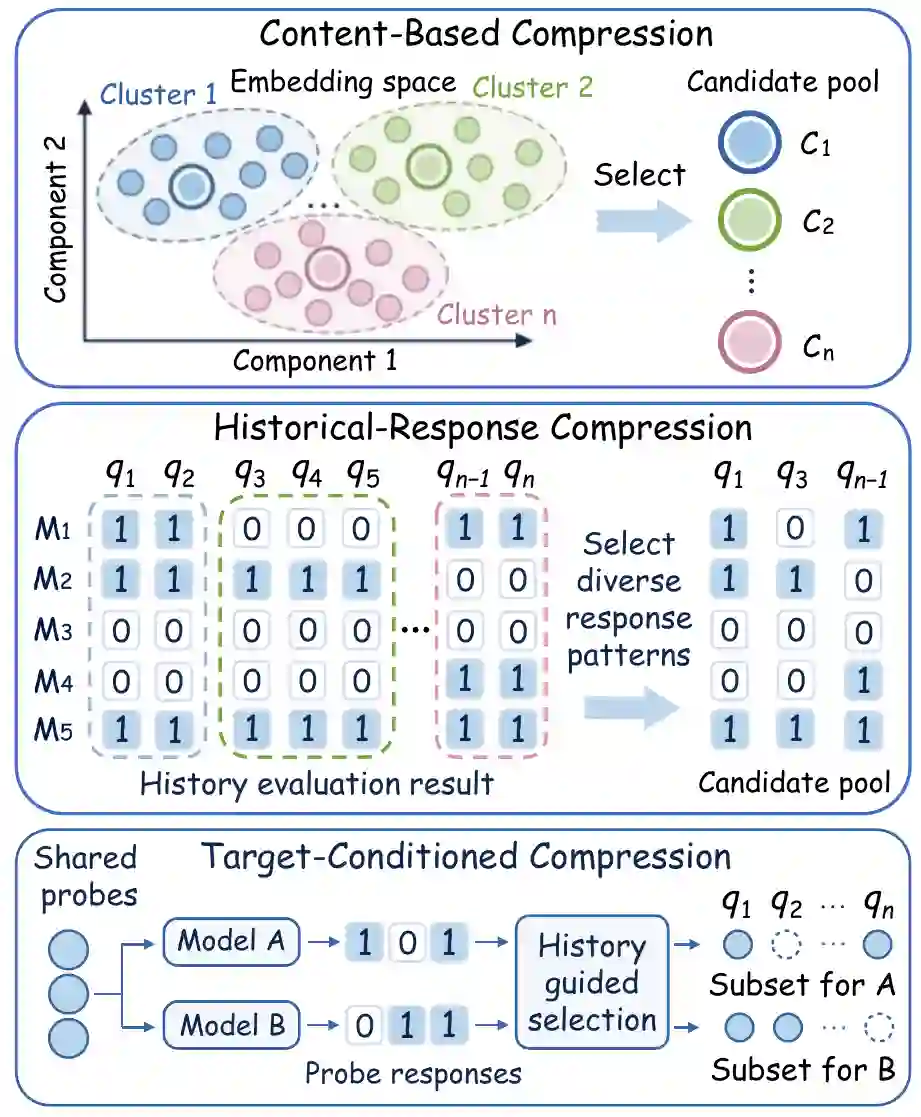
图2:单基准压缩的三条路径。内容方法依据表示和覆盖选择样本,历史方法依据以往模型答题模式选择代表题,目标条件方法利用当前模型的小规模探针构造专属子集。来源:原论文图4,PDF第4页。
3.1.1 基于内容的压缩
这类方法依据随机或分层规则,以及题目文本、元数据和表示构建子集,不要求历史模型—题目响应矩阵。随机采样可以用样本均值估计整体,分层采样可以按组权重聚合;PromptEval则在提示与样例组成的稀疏设计中预测未观测单元。 核心集方法按文本、所需技能或推理结构分组,选择代表项,再使用权重或预测恢复结果。某些方法借助内容辅助评分,倾向抽取更有信息的题目,并用逆概率权重校正不均匀选择。 优势是启动成本通常较低,不需先完整评测许多历史模型。风险是小随机子集方差较高,而嵌入空间中的多样性,不一定等于能力维度上的覆盖。对历史模式依赖较弱可能提升分布变化下的稳健性,但不能保证小子集在任何模型上都准确。
3.1.2 基于历史响应的压缩
这类方法复用已有模型在各题目上的结果,构成模型—题目矩阵。相似的答题模式可以揭示冗余,具有区分力的题目则帮助估计新模型能力。 Anchor Points、tinyBenchmarks等采用聚类或题目反应理论,把有限响应映射为完整分数;MiniLongBench、SparseEval等使用代表点和预测机制恢复未测结果。另一些方法结合随机抽样与残差、逆概率校正,让估计仍以原题库为目标。 历史记录可能让子集更小或估计更准,但构建矩阵往往需要多次完整评估。新模型家族或能力大幅提升后,旧响应关系可能失效,随机采样仍可能具有竞争力。历史覆盖、构建成本和迁移验证因此不能省略。 还有一类历史筛题保留难题或高区分度题目,却直接给新题库打分,而不恢复原完整分数。这属于边界案例:如果目标改变,应按基准修订或短版本验证,不能把分数变化包装成忠实压缩。
3.1.3 面向目标模型的条件压缩
目标条件方法先获得当前模型的低成本信号,再固定主评估批次。TailoredBench通过共享探针找出相似历史模型,为目标构建专属子集;不确定性或分歧信号也可以指导选题及模型间比较。 另一条路径用廉价裁判评估较大池,再把固定小部分送交人工或强裁判,审计代理错误、校正完整估计。此时节省的可能是人工标签或强裁判调用,而非目标模型输出生成。 收益取决于探针、全池扫描或廉价评分是否远低于节省的测试成本。弱信号可能漏掉关键题目,代理偏差也可能系统性影响结果;随机覆盖与成对人工核验可提供补充保障。
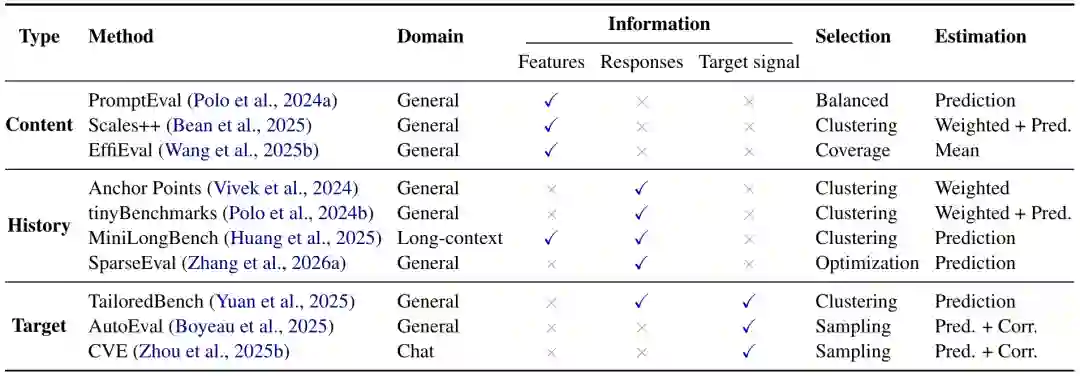
图3:代表性单基准压缩方法的信息需求、选题方式与估计机制。特征、历史响应和目标信号是不同信息来源;预测与残差校正也不应混为一谈。来源:原论文表1,PDF第5页。
3.2 跨基准压缩
多个基准也可能测量重叠能力。跨基准压缩通过联合选择和共享信息,恢复各基准分数、套件均分或套件排名,而非对每个题库独立做一次缩减。 套件锚点方法跨任务选取信息量较高的项目,并用共享能力模型恢复结果;基准选择方法只运行少量完整任务,再用分数矩阵补全预测被跳过任务;源到目标方法以较便宜任务代理昂贵基准,通过回归或重要性加权估计目标表现。多语言张量模型进一步跨语言共享结构。 节省单位由单题扩展到整次基准或昂贵环境运行,但风险也随之扩大:不同基准之间的关系,可能对新模型不成立。应在未见模型上验证,并直接运行无法可靠估计的部分。若代理源任务的成本接近被替代评估,也不能只以“跳过目标任务”宣称节省。
4 Adaptive Evaluation|自适应评估
4.1 自适应选题
自适应选题从小批测试开始,每个响应或批次之后更新分数、能力或不确定性,再选择下一项更有信息的测试。与静态方法相比,主评估结果会改变后续路径。 计算机化自适应测试使用题目反应模型,选择能提供更多能力信息的下一题;主动矩阵补全则选择有助于预测未测响应的题目。其他方法把预算集中到不确定组、罕见失败或噪声较大的裁判单元,并利用组权重、抽样概率或重复测试进行修正。 这些方法可以更有效地使用样本,却带来两种代价:串行轮次可能增加实际等待时间,不同模型的测试路径也会削弱直接可比性与复现。偏向难题或不确定项的样本,不再自然代表完整题库,因此需匹配的估计校正、历史校准与完整路径日志。 更会选题,不等于已经知道何时可以停止。 下一项测试的信息价值与最终决策的可靠性,是不同问题。
4.2 序贯决策与停止
序贯方法阶段性判断是否需要继续测试,目标可能是达到分数精度、可靠比较两个模型,或在固定预算下找到最佳模型。它也可能接受、拒绝、升级到强裁判,或者暂不作答。 Flash-HELM逐步扩大样本,在榜单分层足够清晰时停止;CELEUS结合直接测试校正预测,并按区间精度决定是否继续;UCB-E把固定预算集中到可能的赢家。后者重新分配预算,并不意味着减少预定总预算。 序贯规则必须适用于反复查看结果的过程。普通固定样本区间不能直接被当作随时停止的保证;支持任意时刻有效检查的方法,依赖相应的统计条件。 优势是把测试花在仍可能改变决策的地方。局限是接近的模型可能需要几乎完整评估,分阶段执行可能降低并行度,某些方法只返回赢家或阈值判断,而不返回所有分数。没有满足停止条件时,应继续、报告未分胜负、升级复核或弃权。
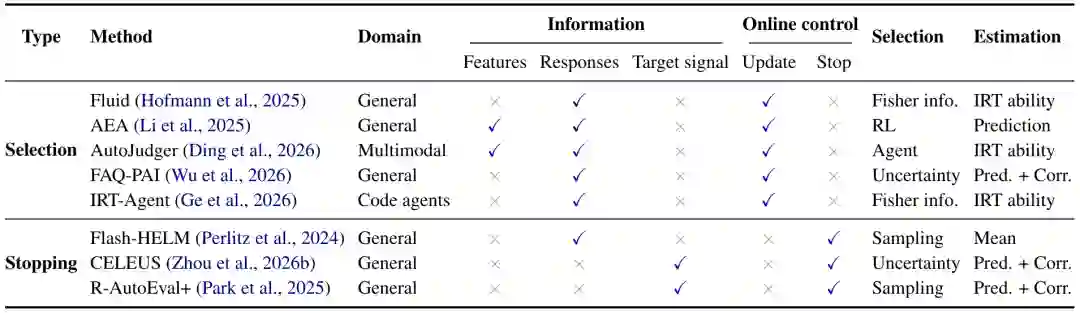
图4:代表性自适应评估方法比较。“更新选择”和“停止”分别指依据反馈改变后续测试,以及依据阶段性结果决定终止;两者可以独立存在。来源:原论文表2,PDF第6页。
5 Benchmark Analysis and Foundations|基准分析与基础研究
为什么能压缩? 题目可能测量重叠能力,模型响应高度相关,部分题目区分度低,整体响应矩阵的有效维度有限。少量代表项因而可能保留主要信息。不过冗余依赖当前模型群体和输出目标,保留整体排名不一定保留分数差距,尤其可能颠倒非常接近的模型。 可以删除多少题? 不存在普适安全比例。所需样本数与关注的分数差、成对方差、能力覆盖和允许错误率有关。题目反应理论还需要合适的校准模型及稳定题目参数;参数不确定会影响选题和排序。证据不足时,比较应保持未决,而非强行给出精确名次。 哪些条件必须固定? 完整与压缩评估应使用相同裁判、提示、解码设置和智能体运行框架。整体裁判准确率可能掩盖局部错误,提示或框架变化也可能改写模型比较。改变协议的影响必须与压缩本身分开评估。 压缩还是修复? 删除存在答案偏置、错误测量或能力顺序异常的题目,可能得到更干净的基准,但分数和排名也可能变化。压缩追求近似原结果,修复追问原结果是否值得保留。修复后更小的题库,应作为新基准独立验证。
6 Comparison Across Method Families|跨方法家族比较
6.1 子集选择:信息与时机
内容与历史方法可在测试目标模型前选择固定子集;目标条件方法先采集廉价信号,再确定一批题;跨基准方法提前联合选择。自适应选题用每次新结果决定下一题,序贯决策用阶段性证据决定是否还需测试。 更晚、更贴近目标的信息可能提高效率,但也会减少跨模型复用或并行空间。选型时应先判断手头有什么信息、何时可获得,而不是先挑一个看起来最先进的名称。 静态主批次也不保证整个两阶段设计在统计上完全非自适应:若探针影响选择,仍需说明探针复用与估计处理,并把成本计入一次,而非忽略或重复记账。
6.2 恢复完整结果
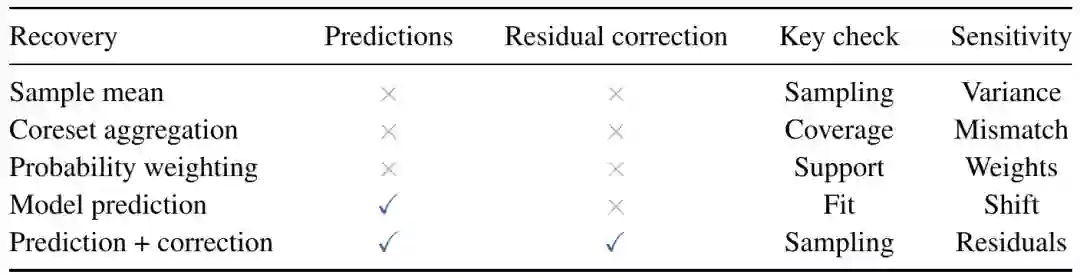
图5:结果恢复的主要机制及检查重点。随机均值看抽样与方差,核心集聚合看覆盖匹配,概率加权看支持和权重,模型预测看拟合与迁移,预测加校正看抽样设计与残差。来源:原论文表14,PDF第25页。 合适的随机设计使样本均值或分层均值对应原整体;确定性核心集代表题及其聚类权重,不自动具有同样保护。逆概率加权要求真实有效的选择概率及足够支持,极端权重会放大方差。 历史预测可以恢复缺失结果,但依赖向新模型迁移。预测加残差或人工标签校正,则用真实观测错误调整代理估计;在方法规定的抽样与估计条件下,预测较差可能降低精度和节省幅度,而不一定使校正估计失效。 检查必须对应实际输出。分数需报告误差及偏差;排名需检查相关性以及近似并列模型的颠倒;赢家或阈值决策需报告对应错误;区间需同时检查覆盖率和宽度;允许弃权的方法还需报告已决案例的风险与决策比例。弃权不是正确判断,平均分误差也不能替代尾部或分位数可靠性。
6.3 全生命周期成本
真正的成本包括构建、校准、目标侧信号、昂贵测试、恢复估计、维护刷新、审计和必要回退。多次评估的总账应理解为:初始构建成本+资产刷新成本+各目标运行成本之和。
内容方法避免构建完整历史矩阵,但全池嵌入或推理轨迹仍有代价。历史和跨基准方法先投入可复用资产,只有实际重复使用节省足以抵消构建与维护,才体现整体收益。目标条件方法每个目标都要付探针或代理成本;自适应方法可能减少调用,却增加串行等待。 应分别报告题数、模型调用、裁判调用、人工审核、计算量、货币成本和实际耗时。若未声明换算,不应直接把人工时间、GPU时间和费用相加。代理评估全部输出后只减少人工审核,节省的是标签工作,不能说目标生成计算同步减少。
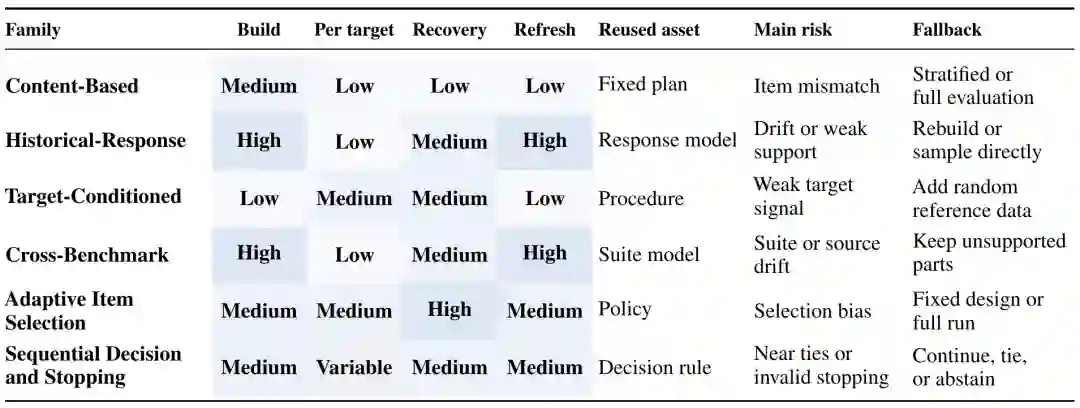
图6:六类操作方法的典型成本负担、可复用资产、主要风险和回退路径。“高、中、低”是结构性概括,不是统一实验测量,也不构成普适性能排名。来源:原论文表16,PDF第26页。
6.4 局限与方法选择
只有题目数据时,可考虑内容或分层采样;历史记录覆盖广且协议一致时,可考虑历史响应方法;廉价目标信号确实有效时,可考虑目标条件方法。联合评估相关套件可采用跨基准方法;允许串行轮次且估计能处理选择过程时,可采用自适应选题;明确需要最终决策且有有效停止规则时,可采用序贯方法。 验证应覆盖部署所需的迁移范围。留出模型测试已知任务上的新模型;留出整个家族检查家族迁移;时间留出测试未来版本;任务留出则检验未参与构建的任务。留出应覆盖构建、拟合、调参和校准,不能先利用所有目标结果选题,再只隐藏部分矩阵单元宣称新模型泛化。 离线回放与在线测试可采用相同留出划分,但自适应回放只能透露当前路径已获得的结果,不能偷看未来。前瞻测试应在新目标到来前冻结流程,理论保证也只针对其声明的目标、随机性和假设。 公平比较应对齐参考协议、输出、预算和资源,包括随机或分层基线,在相同预算下比较误差,或在相同质量要求下比较成本,并报告多次随机运行的变化。若条件不满足,应扩大随机覆盖、直接测不支持的任务、继续评估或弃权,而不是执意维持压缩率。
7 Challenges and Future Directions|挑战与未来方向
跨模型与跨时间泛化。 压缩子集常来自已有模型的响应,新家族或更强模型可能改变难度和区分模式。未来需要更稳健的迁移,并在新发布模型上持续检查覆盖与区分力,下降时刷新。验证若只在旧模型随机划分中进行,很难回答是否适用于未来版本。 更新已有基准。 正式榜单和历史论文仍以完整结果为参照,压缩因此更容易先用于开发迭代、筛选及重复验证。结合基准修复,发布重新校准的版本,去除有缺陷、冗余、过易或低区分度项目,可形成更便宜且有信息的公共参照。但新版本不能与旧分数无条件混用,需要重新验证测量目标与可比性。 发布前就考虑压缩。 对新基准,应在构建阶段兼顾紧凑性、信息量和能力覆盖,而不是先发布庞大冗余集合,再让每个使用者各自压缩。这可以降低评估和模型迭代成本,也减少不必要计算。紧凑设计仍需模型群体、误差目标和后续维护证据,不能只追求最少题数。
8 Conclusion|结论
这篇综述的统一视角是:用代表测试、廉价或可复用信息,以及针对不确定案例的追加评估,在减少成本的同时保留可靠结果。 它同时提醒我们,可靠压缩需要充分覆盖、准确恢复和有效自适应决策。方法能节省什么、需要先投入多少、面对新模型是否可靠,以及失败后怎样回退,必须一起回答。 对实践者而言,最有价值的顺序不是“先删题,再看误差”,而是先固定评估目标和协议,明确可用信息与总成本,再验证所需输出,在证据不足处恢复测试。 更高效的评估,是以更少代价收集足够有用的信息,而不是更快给出未经支持的结论。
Limitations|综述局限
作者指出三项局限:文献范围截止于2026年8月,后续研究不在其声明覆盖范围内;正文受篇幅限制,只能提供分类与路线图,详细方法需阅读附录;不同研究的模型、任务、成本与协议差异很大,难以直接量化合并。因此本文不把各论文不同条件下的压缩倍率整理成统一排行榜。 附录阅读指南
附录A列出论文目录与类别边界案例;B比较相邻方法综述和一般评估综述;C给出范围、分类规则、决策路径及辅助属性;D展开结果定义、选择与恢复、信息、成本、验证和选型;E逐类解释代表方法、假设、失败条件和回退;F说明检索、筛选和版本合并;G披露人工审核的辅助工具使用及影响;H总结综述贡献。需要复现选型和核查分类的读者,可重点阅读C、D、E,而不只看保留样本比例。 原文主页 https://arxiv.org/abs/2610.18248 完整论文 https://arxiv.org/pdf/2610.18248 本文依据论文v1整理;配图保留原始图内文字,图题与说明在图片下方以中文呈现。示例反映综述所讨论的研究设置,不构成对所有基准和未来模型的保证。
 Are We Testing Too Much? A Survey of Benchmark Compression for Efficient Evaluation of Large Language Models


相关内容

 微信扫码咨询专知VIP会员