
博士论文 | 语言监督驱动的空间推理:从引用定位、程序化视觉问答到医学 CT 分割
论文链接:http://www2.eecs.berkeley.edu/Pubs/TechRpts/2026/EECS-2026-238.html
PDF:https://www2.eecs.berkeley.edu/Pubs/TechRpts/2026/EECS-2026-238.pdf题目:Spatial Reasoning from Language Supervision作者:Sanjay Sriram Subramanian机构:University of California, Berkeley
技术报告编号:UCB/EECS-2026-238,2026 年 8 月 8 日
导读
空间推理是视觉智能绕不开的核心能力:系统要理解物体在哪里、谁在接触谁、多个图像之间是否满足某种关系,甚至要在三维医学影像中定位病灶。然而这类任务通常需要边界框、关键点、网格、分割掩码等高成本空间标注,远比普通类别标签或图像描述难以规模化。 这篇 Berkeley 博士论文提出一个贯穿全文的问题:语言监督能否帮助空间推理?作者的回答并不是“语言天然包含精确几何”,而是更细腻地指出:语言监督往往缺少距离、角度、左右手性等细粒度信息,但它能提供可扩展的弱信号、语义先验和可组合推理结构。论文围绕四个具体系统展开:ReCLIP 用图文预训练模型做零样本引用表达理解;CodeVQA 让代码生成模型组合视觉模块完成多跳视觉问答;ProsePose 把多模态模型输出的接触描述转化为 3D 姿态优化约束;最后一章从放射报告中抽取弱监督,提升开放式 CT 体数据分割。
Chapter 1 Introduction | 引言
空间推理为什么难
论文开篇指出,空间推理贯穿日常生活和实际工作:烹饪时要定位食材并按特定方式处理;制作幻灯片时要安排元素位置;理解篮球比赛时要持续关注球员位置和姿态。自动化系统若要完成这些任务,就必须具备空间理解能力。 计算机视觉从早期就把空间结构作为中心问题。关键点、边界框、分割掩码、3D 包围盒、点云和网格都是把空间关系形式化的输出表示。但这些表示也让监督学习高度依赖人工标注。与识别任务不同,空间输出难以从网页自然获得,标注成本高,跨领域迁移也更困难。
语言作为弱监督
论文的核心洞察是:虽然直接空间标注稀缺,但语言中蕴含大量空间信息。人类会用“左边”“靠近”“接触”“包围”“位于某层切片”等语言描述空间关系。这些描述不一定精确到像素或毫米,却可以作为弱监督,帮助模型做引用定位、组合问答、姿态修正和医学分割。 作者把这一直觉应用到四类任务:第二章做引用表达理解,第三章做多跳视觉问答,第四章做 3D 人体姿态估计,第五章做开放式 CT 体数据分割。第六章总结这些工作,并讨论新环境适应、实时视觉对话和机器人等方向。
Chapter 2 ReCLIP | 零样本引用表达理解
任务与动机
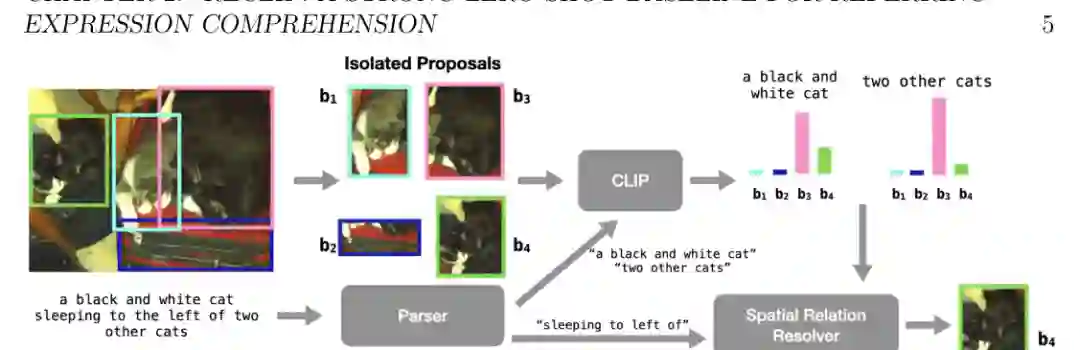
引用表达理解的输入是一张图像和一段描述,目标是在图中定位被描述对象。例如“左边穿红衣服的人”要求系统同时理解对象属性和空间关系。传统方法通常依赖任务特定标注数据,但在新视觉域中,这类监督数据往往昂贵或不存在。 ReCLIP 的目标是用只在图像-文本对上训练过的模型完成零样本引用定位。论文认为,像 CLIP 这样的图文模型在跨域图像分类中表现强,但直接用于需要空间关系推理的任务并不充分。因此,ReCLIP 不是简单把整张图和文本输入 CLIP,而是把引用定位拆成候选区域打分和空间关系解析两个部分。
方法设计
ReCLIP 的第一部分是孤立候选区域打分。给定一组候选框,系统为每个候选创建局部图像,例如裁剪该区域,或模糊除候选外的其他部分,然后用 CLIP 计算该区域与文本表达的匹配分数。这相当于把引用表达理解转化为更接近 CLIP 预训练目标的图文匹配问题。 第二部分是空间关系解析。作者通过 CLEVR 合成实验发现,CLIP 在非空间图文匹配任务上表现很好,但在需要判断 left、right、front、behind 等空间关系时接近随机。这说明仅依赖图文相似度不足以可靠处理空间关系。ReCLIP 因此使用依存句法解析,把表达式拆成谓词和关系,再用简单几何规则处理 left、right、above、below、bigger、smaller、inside 等关系。
实验结论
在 RefCOCOg、RefCOCO+、RefCOCO 等标准数据集上,ReCLIP 优于此前零样本方法,并在平均表现和不同对象类型之间的稳定性上优于或接近 GradCAM 基线。在跨域 RefGTA 数据集上,ReCLIP 的意义更加明显:它能在视频游戏域中超过训练于自然图像域的监督模型,显示出零样本图文模型与显式空间规则结合的实用价值。 同时,ReCLIP 也暴露了语言监督的边界。它能从文本中抽取关系并利用几何规则组合候选,但复杂自然语言、隐含关系、歧义指代表达和错误句法解析仍会带来失败。论文由此进入下一章:如果空间推理需要多步组合,能否让语言模型写程序来组织视觉模块?
Chapter 3 CodeVQA | 通过代码生成进行模块化视觉问答
程序化组合推理
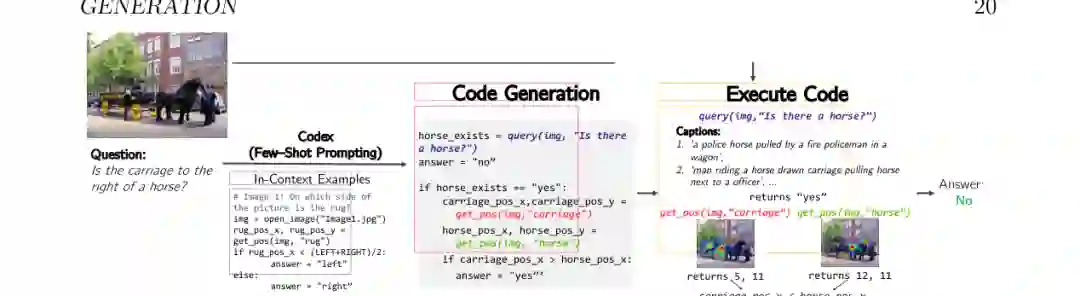
CodeVQA 面向多跳视觉问答。传统 VQA 系统往往把图像和问题输入一个端到端模型;模块化系统则会把问题拆成子问题,再调用检测、定位、问答等模块。CodeVQA 的关键是用代码生成模型承担“拆解和组合”的职责:它根据问题生成 Python 程序,通过条件分支、循环、算术和比较操作来调用视觉原语。 论文使用三个核心原语:query 用于回答关于图像的问题,get_pos 用于返回对象位置,find_matching_image 用于在多图场景中选择与文本最相关的图像。这些原语由图文匹配、图文对比和图像描述模型实现,因此仍主要依赖图像-文本对监督,而不需要为每个任务重新训练模块。
为什么代码有用
代码的优势在于它提供了显式控制流。对于“多张图中满足某条件的数量”“两个对象是否同色”“某物是否位于另一物右侧”等问题,系统不必把所有信息压缩到一次大模型问答中,而是可以把问题拆成一系列可执行步骤。代码还能自然表达循环、条件判断和数值比较,这正是许多空间和组合问题所需要的推理结构。 在 GQA、COVR、NLVR2 等数据集上,CodeVQA 在少样本设置下超过 Few-shot PnP-VQA 等基线。尤其在 COVR 的多图问题中,CodeVQA 能逐图查询并比较答案,而不是让语言模型在一个长上下文里一次性整合所有图像描述。
错误来源
作者对错误进行了细分:不相关 caption、图像选择错误、程序生成错误、问答错误、答案可争议、标注不清或数值错误都可能导致失败。值得注意的是,很多错误来自模块执行,而不是程序生成本身。这说明程序化 VQA 的瓶颈不仅在语言模型写代码,也在视觉原语的可靠性与接口设计。
Chapter 4 Pose Priors from Language Models | 语言模型中的姿态先验
从语言描述到三维约束
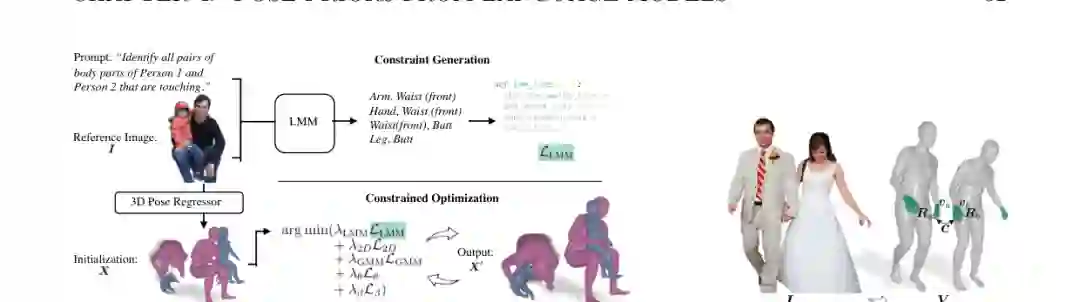
第四章转向 3D 人体姿态估计,尤其关注身体接触。人与人拥抱、握手、摔跤,或单人瑜伽中的手脚接触,都包含重要几何关系,但这些接触常被遮挡,普通 2D 关键点不足以表达。已有高质量方法往往依赖带接触标注的动作捕捉或人工标注数据,成本很高。 ProsePose 的想法是利用多模态大模型中的语义知识:让模型看图并输出哪些身体部位应该接触,再把这些自然语言接触描述转成 3D 网格上的损失函数,用于优化初始姿态估计。
方法流程
ProsePose 分三步工作。第一步,用现成姿态回归模型从图像得到粗略 3D 姿态。第二步,把图像输入多模态模型,要求其列出接触的身体区域对,例如 hand-arm、arm-waist、hand-foot。第三步,把这些区域对映射到 SMPL-X 网格顶点集合,定义区域间最小距离损失,并与 2D 关键点、姿态先验等损失共同优化。 由于多模态模型会幻觉或遗漏,论文采用多次采样并聚合约束的方式提高稳定性。作者还发现,要求模型准确区分左手右手、左腿右腿并不可靠,因此在提示设计中避免过度依赖左右手性,并在优化时枚举可能的手性分配。
实验发现
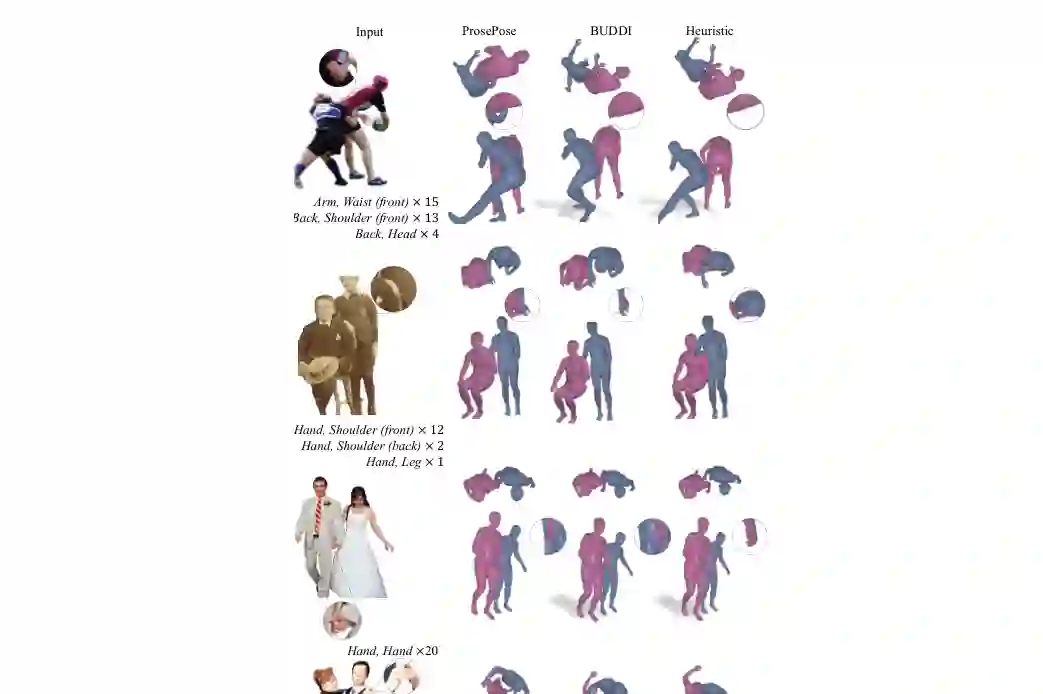
在 Hi4D、FlickrCI3D、CHI3D 等双人交互数据集上,ProsePose 相比不使用接触监督的强基线持续提升接触相关指标;在 MOYO 单人瑜伽数据上,它也能更好恢复手脚或双手之间的自接触。对于双人设置,ProsePose 在 Hi4D 上显著缩小了启发式方法与全监督 BUDDI 之间的 PA-MPJPE 差距。 局限也很清楚:多模态模型对左右肢体的判断仍容易失败,粗粒度身体区域限制了约束精度,模型输出也会随相机角度变化。这一章的意义在于证明语言监督不是只能用于 2D 图文任务,它还能以“语义约束”的形式进入 3D 优化。
Chapter 5 Open-Ended CT Volume Segmentation | 语言弱监督的开放式 CT 体分割
医学场景中的监督稀缺
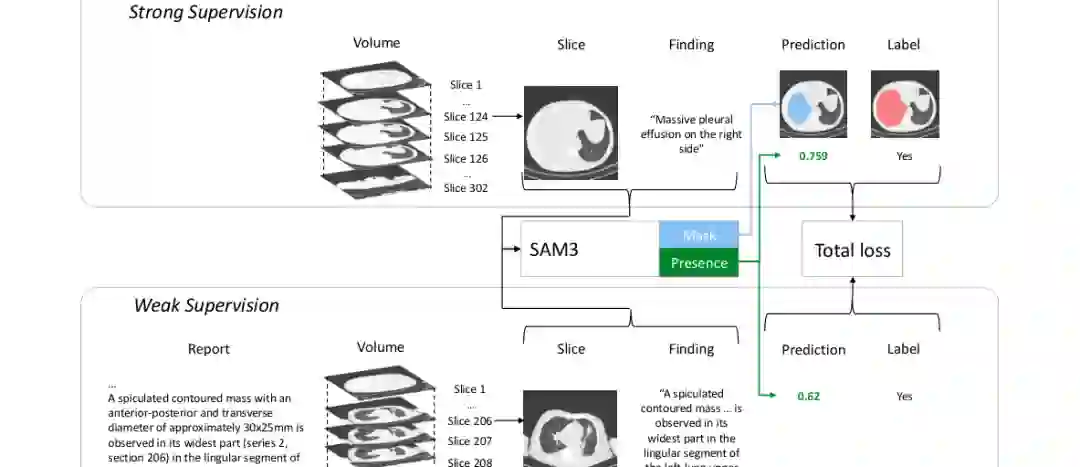
第五章把语言监督带到医学影像。CT 体数据分割很难:体数据大,病灶相对小,异常类型复杂,精细掩码需要专业医生标注。但医院常规保存 CT 体数据和放射报告,报告中会描述病灶,并经常给出可见切片的位置。因此,报告文本可以提供一种弱监督:它不告诉完整 3D 掩码,但能告诉某个发现大概出现在哪些切片上。 论文提出一个开放式、文本条件的 CT 分割方法:输入 CT 体数据和病灶描述,输出对应体素分割。系统基于 SAM3 进行微调,结合强监督数据中的切片级存在标签和掩码,以及从报告中抽取的弱监督切片存在标签。
报告文本如何变成训练信号
作者从约 24.4 万份胸部 CT 报告中抽取弱监督三元组:病灶描述、体数据、切片集合。流程包括用正则识别 “series X image Y” 等定位表达,切分局部文本片段,匹配对应扫描序列,映射到重采样后的切片索引,再用语言模型把片段整理成独立的肺部发现描述和定位 JSON。最终得到约 9.3 万个弱监督三元组。 训练时,强标注切片使用 SAM3 的标准存在损失、框损失和掩码损失;弱标注切片只使用存在损失。由于报告提到的切片通常不完整,论文只把明确提及或邻近切片作为正例,把远离这些切片的切片作为负例,中间区域不参与弱监督损失。
结果与启示
实验使用 ReXGroundingCT 数据集评估。结果显示,在强标注数据较少时,加入报告弱监督显著提升分割质量:1000 个全标注体数据时相对提升约 8%,250 个全标注体数据时相对提升约 22%。类别分析进一步显示,弱监督数据中覆盖更充分的发现类型,通常获得更大增益。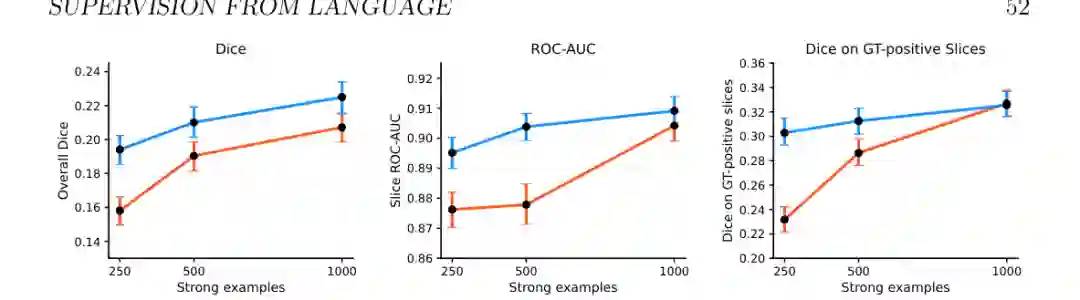
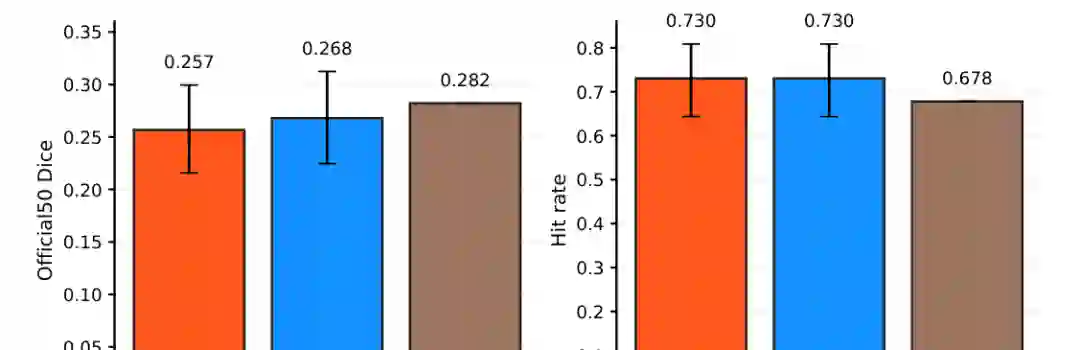
这一章说明语言监督不仅能作为通用视觉任务的语义先验,也能在专业医学场景中降低空间标注需求。不过,它也提出新的问题:这种方法能否扩展到其他器官、其他影像模态?能否训练真正 3D 原生的分割模型?报告中除切片位置外,还有哪些监督信号可被利用?
Chapter 6 Conclusion | 总结与未来方向
论文的总体贡献
这篇博士论文的统一主题,是用语言监督缓解空间监督昂贵的问题。ReCLIP 证明,图文预训练模型加显式空间规则可以做零样本引用定位;CodeVQA 证明,代码生成能把语言模型的组合能力变成可执行视觉推理流程;ProsePose 证明,多模态模型的语言化接触判断可以转化为 3D 姿态优化先验;CT 分割章节则证明,真实报告文本能够为医学体数据分割提供可扩展弱监督。 从方法论看,论文并没有把语言监督神化。相反,它一直在承认语言信号的弱点:CLIP 不擅长细粒度空间关系,多模态模型会幻觉且难辨左右,放射报告的切片定位并不完整。但作者通过候选隔离、关系解析、程序生成、约束聚合、弱标签设计等机制,把不完美的语言信号转化为有用的空间推理辅助。
三个未来方向
第一是适应新环境。当前通用视觉模型在训练数据充分覆盖的场景中表现较好,但面对低资源文化、地理环境、新软件界面或虚拟域时容易下降。论文认为,持续学习和无人工标注的数据生成可能是应对环境转移的重要路线。 第二是实时视觉对话。未来系统不只是回答一张图上的问题,而是要在实时变化的视觉上下文中与人持续对话。例如烹饪辅助系统需要低延迟、能处理中断、能同时响应语言和视觉变化,并在用户动作发生变化时更新推理。 第三是机器人。机器人需要把视觉-语言模型与动作可供性结合起来,并在新任务中泛化。论文建议探索更可扩展的弱监督或辅助数据来源,例如操作过程中的语言反馈,或把人类执行任务的视频作为检索增强参考,用于改进视觉-语言-动作模型。 总体来看,这篇论文给空间推理提供了一个非常务实的视角:与其等待昂贵空间标注无限扩展,不如系统地挖掘语言中已有的弱空间信号,并通过明确的任务结构、可解释模块和可验证约束把它们转化为模型可用的训练与推理资源。
 Spatial Reasoning from Language Supervision



 微信扫码咨询专知VIP会员