
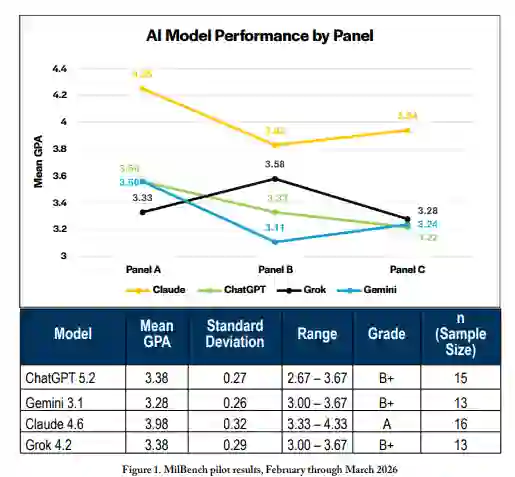
美国陆军战争学院的综合口试作为该学院的终极考核,用于衡量其高级军官的战略思维。2026年初,三个教员评审组依据该标准对四个领先的商业人工智能(AI)系统进行了测试:ChatGPT、Gemini、Claude和Grok。在未提供核心课程材料的情况下进行提示,所有四个模型均通过了考核。与静态基准不同,该考核的即兴对话形式揭示了在通用评估中不可见的显著性能差异,其中一个模型表现出统计学上的显著优势。这些发现对美国战争部评估商业人工智能战略应用的方式提出了挑战,并表明以领域特定、基于对话的基准测试作为更严格的标准。
成为VIP会员查看完整内容
 原文下载



最新内容
 微信扫码咨询专知VIP会员