
【QA】揭开知识库问答KB-QA的面纱1·简介篇
作者:刘大一恒
个人主页:https://dayihengliu.github.io
知乎专栏:揭开基于知识库问答系统的神秘面纱
原文链接,点击文末阅读全文直达:https://zhuanlan.zhihu.com/p/25735572
内容速览
-
什么是知识库(knowledge base, KB) -
什么是知识库问答(knowledge base question answering, KB-QA) -
知识库问答的主流方法 -
知识库问答的数据集
什么是知识库
❝“奥巴马出生在火奴鲁鲁。”
❞
“姚明是中国人。”
“谢霆锋的爸爸是谢贤。”
这些就是一条条知识,而把大量的知识汇聚起来就成为了知识库。我们可以在wiki百科,百度百科等百科全书查阅到大量的知识。然而,这些百科全书的知识组建形式是非结构化的自然语言,这样的组织方式很适合人们阅读但并不适合计算机去处理。为了方便计算机的处理和理解,我们需要更加形式化、简洁化的方式去表示知识,那就是「三元组(triple)」。
“奥巴马出生在火奴鲁鲁。” 可以用三元组表示为 (BarackObama, PlaceOfBirth, Honolulu)。
这里我们可以简单的把三元组理解为 (实体entity,实体关系relation,实体entity),进一步的,如果我们把实体看作是结点,把实体关系(包括属性,类别等等)看作是一条边,那么包含了大量三元组的知识库就成为了一个庞大的知识图。
知识库可以分为两种类型,一种是以Freebase,Yago2为代表的Curated KBs,它们从维基百科和WordNet等知识库中抽取大量的实体及实体关系,可以把它们理解为是一种结构化的维基百科,被google收购的Freebase中包含了上千万个实体,共计19亿条triple。
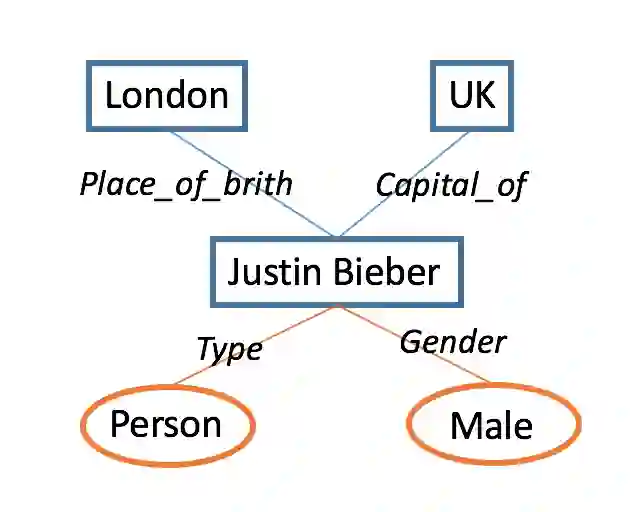
值得一提的是,有时候会把一些实体称为topic,如Justin Bieber。实体关系也可分为两种,一种是属性property,一种是关系relation。如下图所示,属性和关系的最大区别在于,属性所在的三元组对应的两个实体,常常是一个topic和一个字符串,如属性Type/Gender,对应的三元组(Justin Bieber, Type, Person),而关系所在的三元组所对应的两个实体,常常是两个topic。如关系Place_of_Brith,对应的三元组(Justin Bieber, Place_of_brith,London)。
但是,像维基百科这样的知识库,与整个互联网相比,仍只能算沧海一粟。知识库的另外一种类型,则是以Open Information Extraction (Open IE),Never-Ending Language Learning (NELL)为代表的Extracted KBs,它们直接从上亿个网页中抽取实体关系三元组。与Freebase相比,这样得到的知识更加具有多样性,而它们的实体关系和实体更多的则是自然语言的形式,如“奥巴马出生在火奴鲁鲁。” 可以被表示为(“Obama”, “was also born in”, “ Honolulu”),当然,直接从网页中抽取出来的知识,也会存在一定的noisy,其精确度要低于Curated KBs。
Extracted KBs 知识库涉及到的两大关键技术是:
1、「实体链指(Entity linking)」 ,即将文档中的实体名字链接到知识库中特定的实体上。它主要涉及自然语言处理领域的两个经典问题实体识别 (Entity Recognition) 与实体消歧 (Entity Disambiguation),简单地来说,就是要从文档中识别出人名、地名、机构名、电影等命名实体。并且,在不同环境下同一实体名称可能存在歧义,如苹果,我们需要根据上下文环境进行消歧。2、「关系抽取 (Relation extraction)」,即将文档中的实体关系抽取出来,主要涉及到的技术有词性标注 (Part-of-Speech tagging, POS),语法分析,依存关系树 (dependency tree) 以及构建SVM、最大熵模型等分类器进行关系分类等。
什么是知识库问答
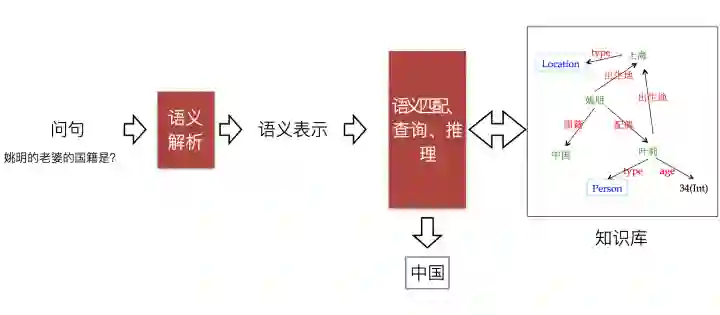
知识库问答(knowledge base question answering,KB-QA)即给定自然语言问题,通过对问题进行语义理解和解析,进而利用知识库进行查询、推理得出答案。如下图所示
与对话系统、对话机器人的交互式对话不同,KB-QA具有以下特点:
「答案」:回答的答案是知识库中的实体或实体关系,或者no-answer(即该问题在KB中找不到答案),当然这里答案不一定唯一,比如 中国的城市有哪些 。而对话系统则回复的是自然语言句子,有时甚至需要考虑上下文语境。
「评价标准」:召回率 (Recall),精确率 (Precision) ,F1-Score。而对话系统的评价标准以人工评价为主,以及BLEU和Perplexity。
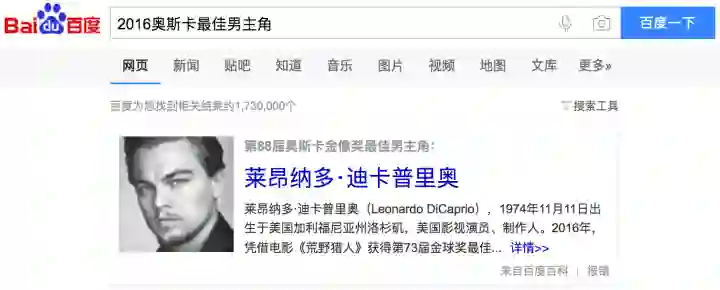
当我们在百度询问 2016年奥斯卡最佳男主角 时,百度会根据知识库进行查询和推理,返回答案,这其实就是KB-QA的一个应用。
知识库问答的主流方法
关于KB-QA的方法,个人认为,传统的主流方法可以分为三类:
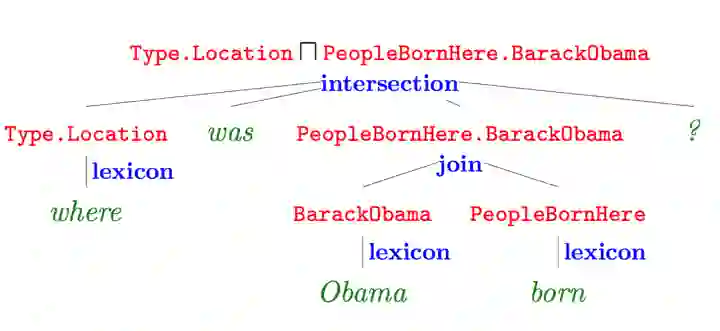
「语义解析(Semantic Parsing)」:该方法是一种偏linguistic的方法,主体思想是将「自然语言」转化为一系列形式化的「逻辑形式(logic form)」,通过对逻辑形式进行自底向上的解析,得到一种可以表达整个问题语义的逻辑形式,通过相应的查询语句(类似lambda-Caculus)在知识库中进行查询,从而得出答案。下图红色部分即逻辑形式,绿色部分where was Obama born 为自然语言问题,蓝色部分为语义解析进行的相关操作,而形成的语义解析树的根节点则是最终的语义解析结果,可以通过查询语句直接在知识库中查询最终答案。
这里给出「语义解析方法」的一些代表论文:
Berant J, Chou A, Frostig R, et al. Semantic Parsing on Freebase from Question-Answer Pairs[C]//EMNLP. 2013, 2(5): 6.
Cai Q, Yates A. Large-scale Semantic Parsing via Schema Matching and Lexicon Extension[C]//ACL (1). 2013: 423-433.
Kwiatkowski T, Choi E, Artzi Y, et al. Scaling semantic parsers with on-the-fly ontology matching[C]//In Proceedings of EMNLP. Percy. 2013.
Fader A, Zettlemoyer L, Etzioni O. Open question answering over curated and extracted knowledge bases[C]//Proceedings of the 20th ACM SIGKDD international conference on Knowledge discovery and data mining. ACM, 2014: 1156-1165.
「信息抽取(Information Extraction)」:该类方法通过提取问题中的实体,通过在知识库中查询该实体可以得到以该实体节点为中心的知识库子图,子图中的每一个节点或边都可以作为候选答案,通过观察问题依据某些规则或模板进行信息抽取,得到问题特征向量,建立分类器通过输入问题特征向量对候选答案进行筛选,从而得出最终答案。信息抽取的代表论文Yao X, Van Durme B. Information Extraction over Structured Data: Question Answering with Freebase[C]//ACL (1). 2014: 956-966.
「向量建模(Vector Modeling)」: 该方法思想和信息抽取的思想比较接近,根据问题得出候选答案,把问题和候选答案都映射为分布式表达(Distributed Embedding),通过训练数据对该分布式表达进行训练,使得问题和正确答案的向量表达的得分(通常以点乘为形式)尽量高,如下图所示。模型训练完成后则可根据候选答案的向量表达和问题表达的得分进行筛选,得出最终答案。
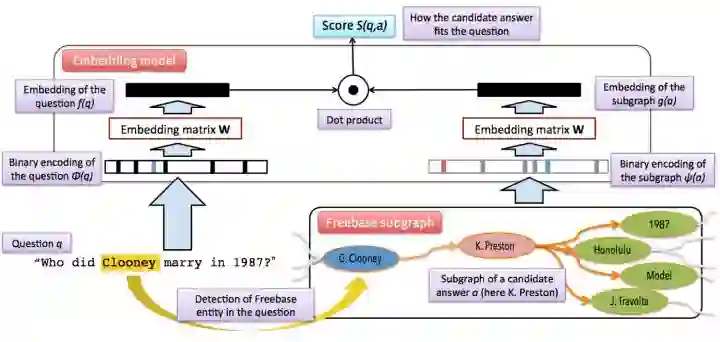
「向量建模方法」的代表论文:
Bordes A, Chopra S, Weston J. Question answering with subgraph embeddings[J]. arXiv preprint arXiv:1406.3676, 2014.
Yang M C, Duan N, Zhou M, et al. Joint Relational Embeddings for Knowledge-based Question Answering[C]//EMNLP. 2014, 14: 645-650.
Bordes A, Weston J, Usunier N. Open question answering with weakly supervised embedding models[C]//Joint European Conference on Machine Learning and Knowledge Discovery in Databases. Springer Berlin Heidelberg, 2014: 165-180.
细心的朋友已经发现了,以上三种方法的代表论文都集中在13-14年。那么14年之后KB-QA的主流方法是什么呢?
随着「深度学习(Deep Learning)」 在自然语言处理领域的飞速发展,从15年开始,开始涌现出一系列基于深度学习的KB-QA文章,通过深度学习对传统的方法进行提升,取得了较好的效果,比如:
使用「卷积神经网络」对「向量建模」方法进行提升:
Dong L, Wei F, Zhou M, et al. Question Answering over Freebase with Multi-Column Convolutional Neural Networks[C]//ACL (1). 2015: 260-269.
使用「卷积神经网络」对「语义解析」方法进行提升:
Yih S W, Chang M W, He X, et al. Semantic parsing via staged query graph generation: Question answering with knowledge base[J]. 2015.
(注 该paper来自微软,是ACL 2015年的「Outstanding paper」,也是目前KB-QA效果最好的paper之一)
使用「长短时记忆网络」(Long Short-Term Memory,LSTM),「卷积神经网络」(Convolutional Neural Networks,CNNs)进行实体关系分类:
Xu Y, Mou L, Li G, et al. Classifying Relations via Long Short Term Memory Networks along Shortest Dependency Paths[C]//EMNLP. 2015: 1785-1794.
Zeng D, Liu K, Lai S, et al. Relation Classification via Convolutional Deep Neural Network[C]//COLING. 2014: 2335-2344.(Best paper)
Zeng D, Liu K, Chen Y, et al. Distant Supervision for Relation Extraction via Piecewise Convolutional Neural Networks[C]//EMNLP. 2015: 1753-1762.
使用「记忆网络」(Memory Networks),「注意力机制」(Attention Mechanism)进行KB-QA:
Bordes A, Usunier N, Chopra S, et al. Large-scale simple question answering with memory networks[J]. arXiv preprint arXiv:1506.02075, 2015.
Zhang Y, Liu K, He S, et al. Question Answering over Knowledge Base with Neural Attention Combining Global Knowledge Information[J]. arXiv preprint arXiv:1606.00979, 2016.
以上论文几乎都使用了「Freebase」作为knowledge base,并且在「WebQuestion」数据集上进行过测试,这里给出各种方法的效果对比图,给大家一个更加直观的感受。
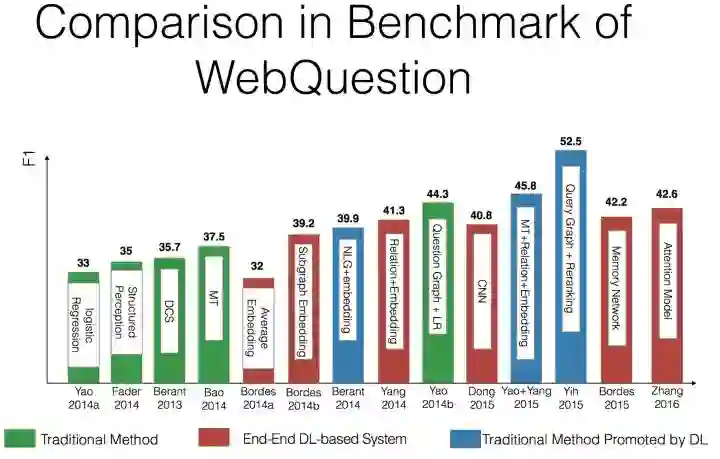
知识库问答的数据集
最后,我们再简单地介绍一下KB-QA问题的Benchmark数据集——WebQuestion。
该数据集由Berant J, Chou A, Frostig R, et al.在13年的论文Semantic Parsing on Freebase from Question-Answer Pairs中公开。
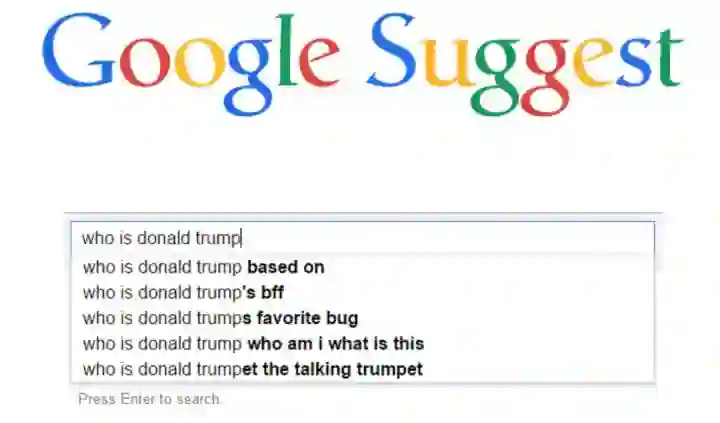
作者首先使用Google Suggest API获取以wh-word(what,who,why,where,whose...)为开头且只包含一个实体的问题,以“where was Barack Obama born?”作为问题图谱的起始节点,以Google Suggest API给出的建议作为新的问题,通过宽度优先搜索获取问题。具体来讲,对于每一个队列中的问题,通过对它删去实体,删去实体之前的短语,删去实体之后的短语形成3个新的query,将这三个新query放到google suggest中,每个query将生成5个候选问题,加入搜索队列,直到1M个问题被访问完。如下图所示
获取完问题后,随机选取100K个问题交给Amazon Mechanical Turk (AMT)的工人,让工人回答答案。注意,这里对答案进行了「限制」,让AMT的工人只能把答案设置为Freebase上的实体(entity),实体列表,值(value)或者no-answer。
最终,得到了5,810组问题答案对,其词汇表包含了4,525个词。并且,WebQuestion还提供了每个答案对应知识库的主题节点(topic node)。
可以看出WebQuestion的问题与freebase是不相关的,更加偏向自然语言,也更多样化。这里给出一些例子
❝“What is James Madison most famous for?”
❞
“What movies does Taylor Lautner play in?”
“What music did Beethoven compose?”
“What kind of system of government does the United States have?”
除了该数据集,这里再补充一些其他数据集的信息,如下图所示:
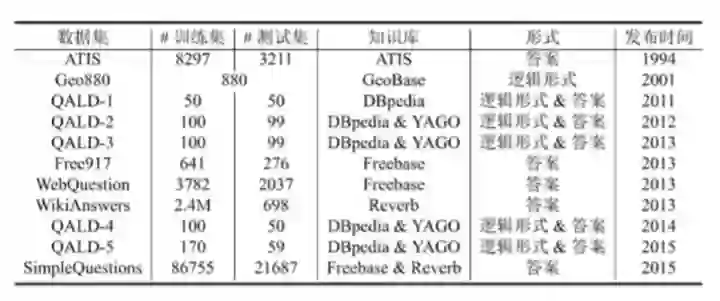
下篇预告
在接下来的文章中,我们会为大家对以上提到的主流方法和代表文章进行解读分析和讨论,一步步为大家揭开KB-QA的面纱。
下期,我们将从传统方法语义解析开始,介绍一个经典的baseline,来自斯坦福的Berant J, Chou A, Frostig R, et al. Semantic Parsing on Freebase from Question-Answer Pairs[C]//EMNLP. 2013, 2(5): 6.
该文章是语义解析的经典代表作,也提供了Benchmark数据集WebQuestion,敬请期待。




相关内容

 微信扫码咨询专知VIP会员