
Speech recognition (一) 之 基础篇

在deep learning 到来之前,speech recognition 系统基本全都是用HMM来实现的;deep learning 的到来,最前期也只是把acoustic model 换成了CNN (MFCC+GMM --> CNN, Geoffrey Hinton,2012; Abdel-Hamid Mohamed, 2014), 而phoneme/word 到phoneme/word 的transition, 仍然用HMM 来model的。再到后期,speech recognition最终脱离了HMM,而换成end-to-end的RNN 模型(Alex Graves, 2014)。然而,RNN也是与HMM 有着相似之处的:把RNN flatten后,也是一条linear chain, 只不过这条linear chain 是deterministic的,而不是probabilistic的。HMM和RNN都能很好的model temporal sequence。
既然HMM在speech recognition的进程中曾长期遥遥领先于其它方法,那么我们何尝不从HMM着手来了解speech recognition的基础呢?
Speech recognition, 顾名思义,就是给定acoustic signals, 识别sentence,如果从概率的角度来讲,就是推测下面的最大条件概率:p(sentence | acoustic signals),如果大家再进一步用bayes 把它重写,那么:p(sentence | acoustics signals) ~ p(acoustic signals |sentence) * p(sentence)。上面的公式,我们省去了分母:p(acoustic signals), 因为它不影响sentence的inference,因此被省略掉了。好了,我们具体看看约等式的右边two terms: p(acoustic signals | sentence) 和p(sentence)。p(acoustic signals | sentence) 是acoustic model, 而p(sentence) 是language model。首先来看language model, 为什么它会出现在speech recognition中?显而易见:当我们听一个有从南方来的有口语的同学讲话,如果他讲一个字,发音不准的话,我们很难听懂,当时如果他讲长句子,即使有几个字发音不准,我们也能从context中推测出他讲的那些字。language model 简言之,是用来model language的syntactic & semantic structure的,在speech recognition中,language model 排除了那些语法、语义不合理的句子,使得speech recognition更加的精确。大家有兴趣可以看看我们之前的文章:NLP 之语言模型。早期的speech recognition 系统,acoustic model使用HMM,而当时最常用的language model 是bi-gram/tri-gram模型。
在讲speech recognition之前,我们来认识speech recognition里面的一个基本的terminology: (1) phoneme – minimal unit ofsound that has semantic content (包括vowels & consonants); (2) syllable - aunit of organization for a sequence of speech sounds; (3) word; (4) sentence. 这四个概念是按照从小到大排列的,属于composition的关系。说到这里,我顺便来说一说speech recognition和vision 中object recognition的差异:众所周知,目前主流的CNN是object recognition的最好算法,CNN 也是一种compositional model: 底层学到image中的lower-level feature, 如edge, 随着层数变深,逐渐学到更抽象的parts, objects .... 所以我们看到,CNN其实也是慢慢学到更抽象、更大的concepts. 但是,vision中学到的这些concepts和speech中phoneme, syllable, words等等这些concepts有什么不同呢?最大的差异是:speech中的concepts are well defined, and they arephysically meaningful, 然后vision的concepts do have physical meaning, andtherefore they are usually uninterpretable。
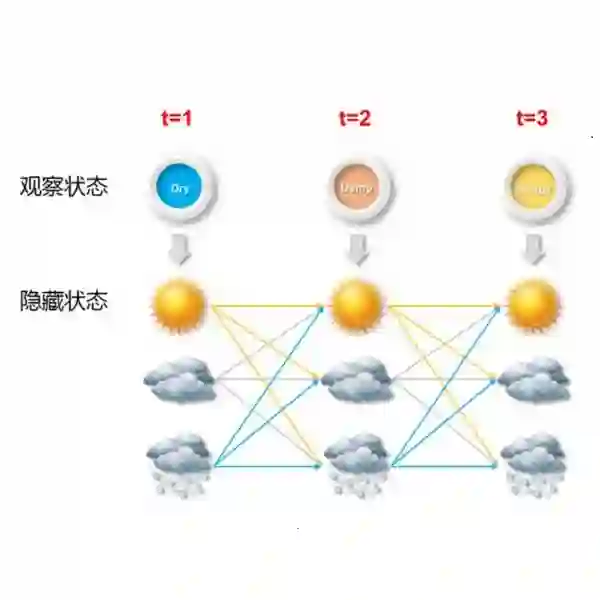
好了,我们来看HMM是怎么model acoustic signal的:分为三层:sentence由words组成,words 又由subwords组成,如果用HMM来model subwords, 把它plug in到word中,便可以得到word的HMM模型(因为words 由多个subwords组成),再把单个word的HMM模型plug in到sentence中,便可以得到sentence 的一个大的HMM 模型。对于一个training好的HMM,我们就可以根据input acoustic signals, 推断整个句子了,这就是一个理论上很简单的MAP inference, 可以通过Viterbi algorithm 来完成(也就是HMM中inference常要的dynamic programming 算法)。可是实际问题是:由于hidden states 太多,viterbi算法变得impractical, 于是我们一般用beam search 或A* 算法来找到most promising word sequences. 补充一下:常用的subword 模型有:phoneme, syllable, demi-syllable, triphone, 在实际的系统中,最常用的是triphone。
好了,我们再来看看HMM中的training: 大家也许有个疑问:我们HMM的building units 是phoneme, 可是我们只有整个句子的acoustic signal, 而没有每个phoneme的acoustic signal (也就是我们并没有每个word/phoneme的ground truth boundary)。既然整个sentence的HMM是由每个phoneme的HMM concatenated起来的,而我们需要学习每个phoneme的HMM的transition/emission parameters, 也就是我们得有Phoneme的acoustic signal才行。然而通过句子的acoustic signal来人工label phoneme的boundary几乎是不可能的(工作量太大,而且也会因人而异)。如果要training, 我们总得需要单个phoneme 的acoustic signal,那该怎么办呢?如果把phoneme的boundary position看成acoustic signal 中的hidden variable的话,那么我们就是要求解这些hidden variable, 大家也许马上想到:EM (expectation maximization) 算法不是很常用来解决有hidden variable的问题吗?对了,如何从continuous acoustic signal中得到phoneme的hidden boundary正是通过EM-styple 算法来解决的:首先根据每个training sentence 的phoneme transcription, 把acoustic signal均分到每个phoneme, 这样每个phoneme就可以单独估计自己HMM里面的参数了;把每个phoneme的HMM再concatenate 成整个sentence的HMM, 现在我们知道了HMM里面所有的参数,我们通过viterbi algorithm 来寻找最可能的path (MAP inference), 这样就能得到每个phoneme的boundary; 然后我们再次train 单个phoneme的HMM,concatenate 成整个句子的HMM,来继续找boundary, …., 这样迭代几次,直到boundary 不变,我们同时也training得到了每个phoneme的HMM的参数。
好了,相信大家对HMM用于speech recognition有了了解,接下来我们会讲到更advanced speech recognition: RNN.


相关内容



 微信扫码咨询专知VIP会员