
导读
一个模型能够给出令人信服的答案,并不意味着我们知道它为什么这样回答;它在安全测试中表现良好,也不意味着它在陌生环境中依然可靠。机制可解释性尝试打开模型内部,研究表征、特征与计算回路,进而支持行为预测、风险识别和有针对性的干预。然而,“解释得通”与“真正更安全”之间,仍有一条需要实验证据连接的鸿沟。 这篇182页的综述《Understanding AI from the Inside: The State of Mechanistic Interpretability for AI Safety》由Fazl Barez、Tung-Yu Wu等27位作者联合撰写,参与者来自牛津大学、MIT、Mila等机构。论文于2026年11月5日提交至arXiv。它不仅梳理技术工具,还提出五维统一评估框架,比较六类研究取向,并系统讨论安全应用、失败模式与开放问题。 本文沿用原论文15个主体章节的顺序,压缩技术推导与案例,保留各章核心问题和结论边界;参考文献及附录不逐项展开。最重要的阅读原则是:可解码不等于被使用,可干预不等于已解释,局部机制证据不等于完整安全保证。
论文链接:https://arxiv.org/abs/2611.08438 全文下载:https://arxiv.org/pdf/2611.08438
1 引言|Introduction
1.1 可解释性的简要历史
可解释性研究从早期模型分析、视觉特征可视化和显著性方法,逐渐发展到针对内部表征和因果计算的研究。随着模型规模扩大,一个神经元对应一个概念的直观图景越来越难以成立,研究对象也从单个神经元扩展为激活空间中的方向、稀疏特征及相互连接的回路。 机制可解释性的目标,不只是给输出附上一段合理说明,而是提出可以检验的内部计算假说:模型在哪里表示了某种信息?哪些部件读取、变换并传递它?改变这些部件,会怎样影响行为?
1.2 综述范围
论文主要讨论已训练模型的内部分析,也纳入学习动态、训练数据归因和内生可解释架构。重点是这些工具能否为安全提供增量价值,而不是把所有可解释性工作都视为安全成果。作者同时提供可复现实例的代码笔记本,帮助读者从操作中理解方法。
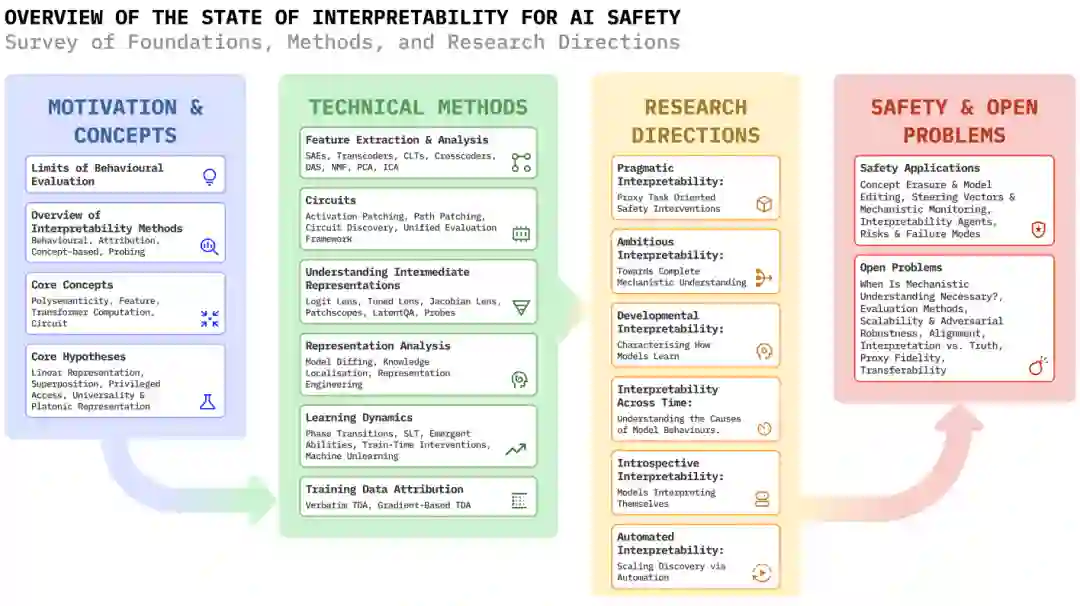
图1:综述的概念路线图。由“动机与概念”进入“技术方法”,再比较“研究方向”,最终讨论“安全与开放问题”。截取自原文图2,第14页。
2 行为评估的局限|The Limits of Behavioural Evaluation
行为评估观察模型在给定输入上的输出,是不可替代的第一层证据。但有限测试无法穷尽环境、任务和攻击策略;表面相同的答案,也可能来自不同的内部计算。模型还可能识别评估情境,使测试表现与部署表现脱节。 内部证据的价值在于补充这些盲区:例如检查某类信息是否被表示、某条路径是否参与危险行为,以及训练如何改变相关机制。不过,检查内部也不是绕过泛化难题的捷径。若分析只覆盖少数提示或局部部件,结论仍可能无法迁移。因此应比较“行为评估”和“行为评估加内部分析”的效果,而非默认白盒方法更优。
3 可解释性研究版图|The Interpretability Landscape
3.1 行为方法
通过基准、对照提示、红队测试等观察模型做了什么。它们便于部署且直接关联任务表现,但通常不能确定内部计算原因。
3.2 基于概念的方法
概念瓶颈等方法用人类指定的概念组织模型决策。在约束有效时,它们能让概念成为可操作接口;代价是概念集合可能不完整,且人类概念未必贴合模型实际使用的表征。
3.3 输入归因与显著性方法
输入归因回答哪些词、像素或输入因素影响输出。影响位置的可视化并不自动揭示这些因素如何在内部被组合,也可能对方法和基线选择敏感。
3.4 表征探测及事后分析
探针能够检验某种属性是否可从激活中读取。但探针自身可能学会任务,或利用与目标有关、却没有被原模型用于决策的信息。
3.5 机制可解释性方法
研究特征、注意力头、神经元及其连接,借助消融、激活替换与回路分析建立计算假说。它们强调内部对象与输出之间可检验的关系,而不只是相关性。
3.6 何时需要机制理解
当问题涉及隐藏状态、行为生成路径或有针对性的内部干预时,机制分析可能特别有用。是否值得采用,仍应取决于它相对于强行为基线的实际收益。
3.7 机制分析的局限
成本高、解释不完整、干预可能制造分布外状态,且研究者容易挑选成功案例。机制证据与行为证据应互相约束,而不是互相替代。
4 机制可解释性的基础概念|Foundational Concepts
4.1 行为理解与机制理解
行为理解描述输入与输出规律;机制理解进一步说明实现规律的内部计算。能够预测行为,不一定意味着找到了模型实际采用的算法。
4.2 神经元的多义性
同一个神经元可能在多个语义不同的情境下激活。给它贴一个概念标签,往往只能描述部分样本,而不能概括全部功能。
4.3 作为表征单位的特征
特征不必是坐标轴上的单个神经元,也可以是激活空间中的方向或更复杂结构。区分“模型中的表示”和“分析工具学出的分解”,是避免过度解释的关键。
4.4 变换器中的计算
残差流承载跨层信息,注意力在位置之间传递信息,多层感知机进行非线性变换。可解释性需要追踪这些部件如何读写共享状态,而不能只观察某层激活高低。
4.5 作为内部机制描述的回路
回路是实现某类行为的一组部件及信息流。它可能针对一类任务,也可能只解释单个查询;二者覆盖范围不同,不能混用。
5 核心假说|Core Hypotheses
5.1 线性表征假说
某些概念能用线性方向表达,使探针、特征提取和引导向量成为可行工具。但线性可读性并非所有概念、所有层、所有模型的普遍性质。
5.2 叠加假说
模型可能在有限维度中编码更多特征,使不同概念共享神经元。稀疏激活让这种压缩成为可能,也解释了为什么逐个查看神经元可能错过有意义的结构。
5.3 特权访问假说
模型可能对自身内部状态拥有外部观察者难以获得的访问能力,从而支持自我解释。问题在于,这种潜在能力并不保证自述真实、完整或对应实际计算。
5.4 普适性与柏拉图表征假说
不同模型可能发展出类似算法或表征。论文区分“计算模式类似”的弱普适性与“内部表征收敛”的强普适性:前者的支持相对更多,后者更依赖相似性指标和实验设置。单个模型中的发现不能未经检验就推广到其他模型。
6 特征提取与分析|Feature Extraction and Analysis
6.1 稀疏编码问题
稀疏编码希望把高维激活表示成少量字典元素的组合。其价值在于提供可研究的候选单位,而不是直接输出完整机制解释。
6.2 稀疏自编码器
稀疏自编码器先将激活映射到更大的潜在空间,再用少数激活特征重构输入。训练在重构误差与稀疏性之间权衡。一个特征可以通过高激活样本获得语义描述,但描述仍需在未见样本和干预实验中验证。
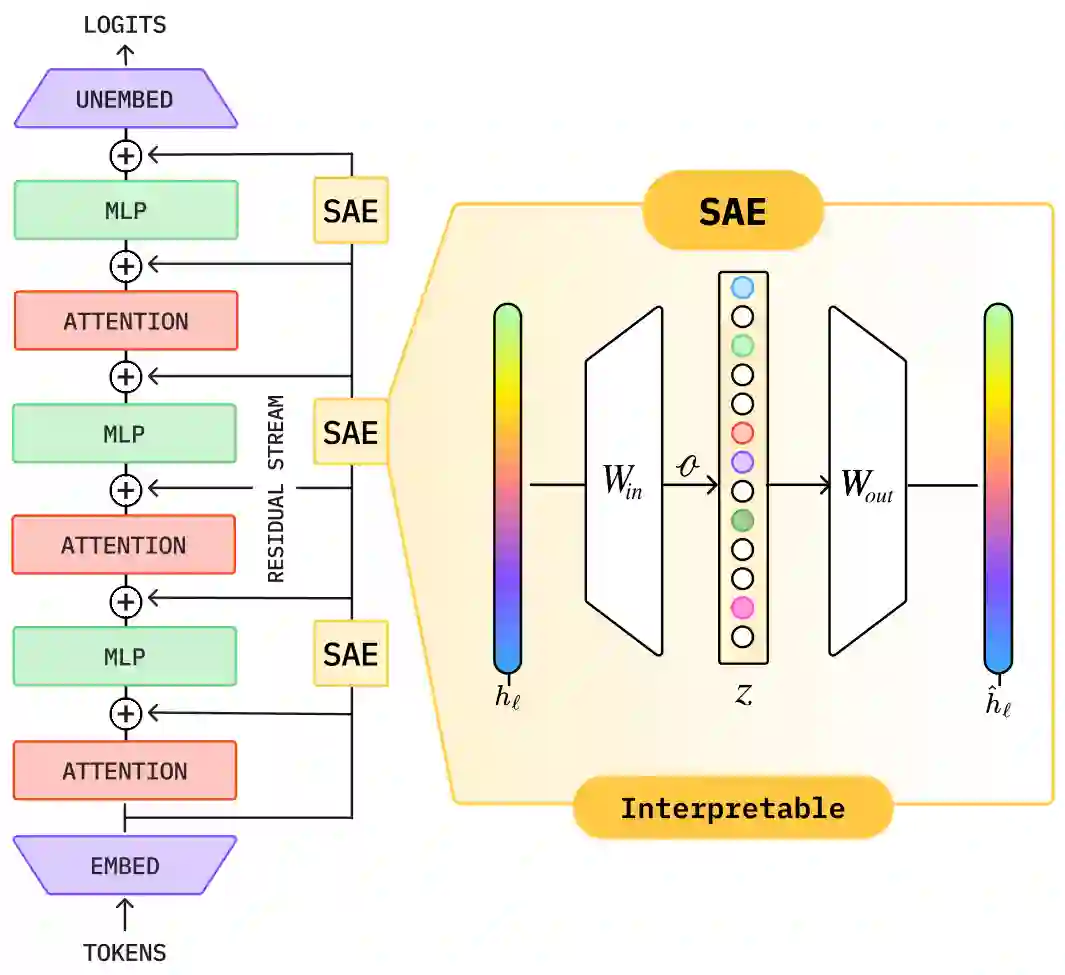
图2:稀疏自编码器将某层激活分解为稀疏潜在特征,再重构原激活。图中的“可解释”表示研究目标,并非对每个学出特征的保证。截取自原文图6,第33页。
6.3 变体与架构改进
门控、自适应阈值、固定或批次级激活数量等设计,分别处理幅值收缩、稀疏度控制和特征使用效率。选择方法时需要匹配计算预算、目标模型和下游任务。
6.4 变体的实证比较
在相同稀疏度下更好的重构表现,不一定意味着更好的知识定位、概念移除或行为控制。不同论文采用的模型、基线及评价标准不同,不能据此得出不受条件限制的优劣排名。
6.5 挑战与失败模式
论文讨论死特征、特征重复、吸收与分裂、随机种子不稳定,以及字典可辨识性。多个不同分解可能同样重构激活,却形成不同的概念图景。因此除重构损失外,还应报告特征使用率、重复程度、跨种子稳定性及因果测试。
6.6 多层特征提取与分析
转码器用稀疏特征从一层多层感知机的输入预测其输出;跨层转码器允许特征向后续多层输出写入贡献;跨编码器则学习跨层或跨模型的共享稀疏表示。这些设计使信息流分析更便利,但也引入替代模型与原模型不一致的风险。
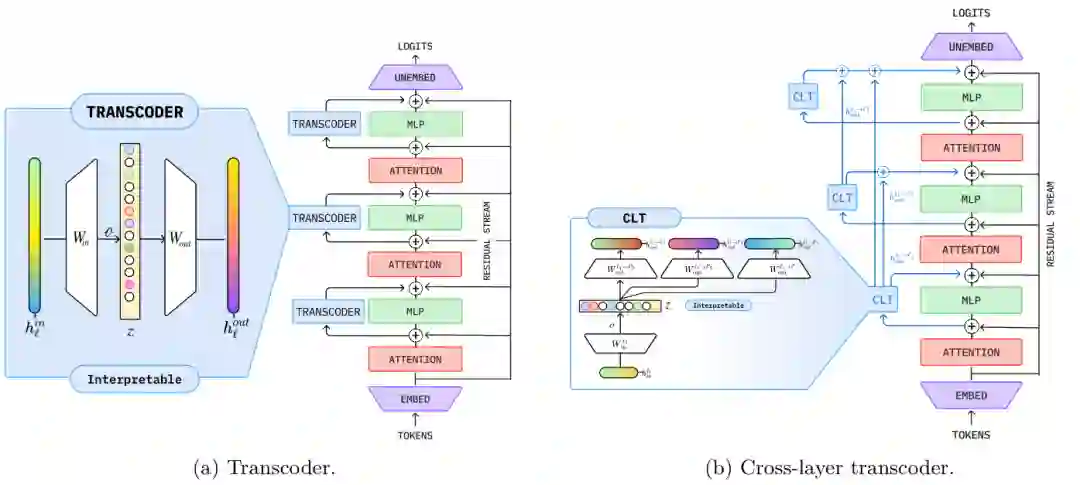
图3:转码器与跨层转码器的计算位置。左图重构同层多层感知机输出,右图让单处读取的特征向多个后续层贡献重构。截取自原文图7,第42页。
6.7 三类工具的比较
稀疏自编码器适合分析激活中的“有什么”;转码器更贴近局部输入到输出的变换;跨编码器适合研究不同层或模型之间的共享与差异。问题不同,合适的分解对象也不同。
6.8 案例:归纳头
归纳头展示了模型如何利用重复模式进行上下文预测,也是连接特征、注意力与回路研究的经典案例。它提供具体机制线索,却不能代替对复杂模型其他能力的分析。
6.9 替代特征提取方法
非负矩阵分解、主成分分析、独立成分分析、监督提取与其他字典学习方法,分别采用不同结构假设。它们既是候选工具,也是检验复杂方法是否真正带来增益的重要基线。
6.10 通过设计实现内生可解释性
另一条路线是在训练和架构中引入特征、权重或注意力稀疏性,或者改变计算原语。论文讨论SoLU、稀疏训练、MOLT和KAN等方向。它们希望减少事后拆解成本,但性能、规模化和解释忠实度之间的权衡仍需验证。
7 机制可解释性中的回路|Circuits
7.1 回路发现方法
通过消融、激活替换、归因近似和自动搜索,识别与目标行为有关的节点及边。搜索效率与因果准确性存在权衡,梯度近似得到的候选还需实际干预确认。
7.2 使用替代模型发现回路
稀疏替代模型可以把复杂网络变成较易分析的图。但解释可能只忠实于替代模型,而没有覆盖原模型的非线性、注意力变化和重构误差。
7.3 因果验证
删除某部件是否破坏行为,是必要性测试;只保留候选部件是否仍能完成行为,是充分性测试;是否主要影响目标而非其他能力,则涉及特异性。冗余路径、干预基线与分布外激活都会影响判断。
7.4 案例:归纳头
归纳行为适合把回路发现与因果验证联系起来:不仅要指出相关注意力模式,还应验证其在对应预测任务中的作用和适用范围。
7.5 统一评估框架
这是论文的重要贡献。作者提出五个互补维度:归因忠实度、完整性、稳定性、因果有效性、人类可解释性。分别追问归因是否对应干预效果、解释覆盖多少行为、结果是否跨设置稳定、机制是否必要且充分且具有特异性,以及解释是否帮助人类预测与调试模型。
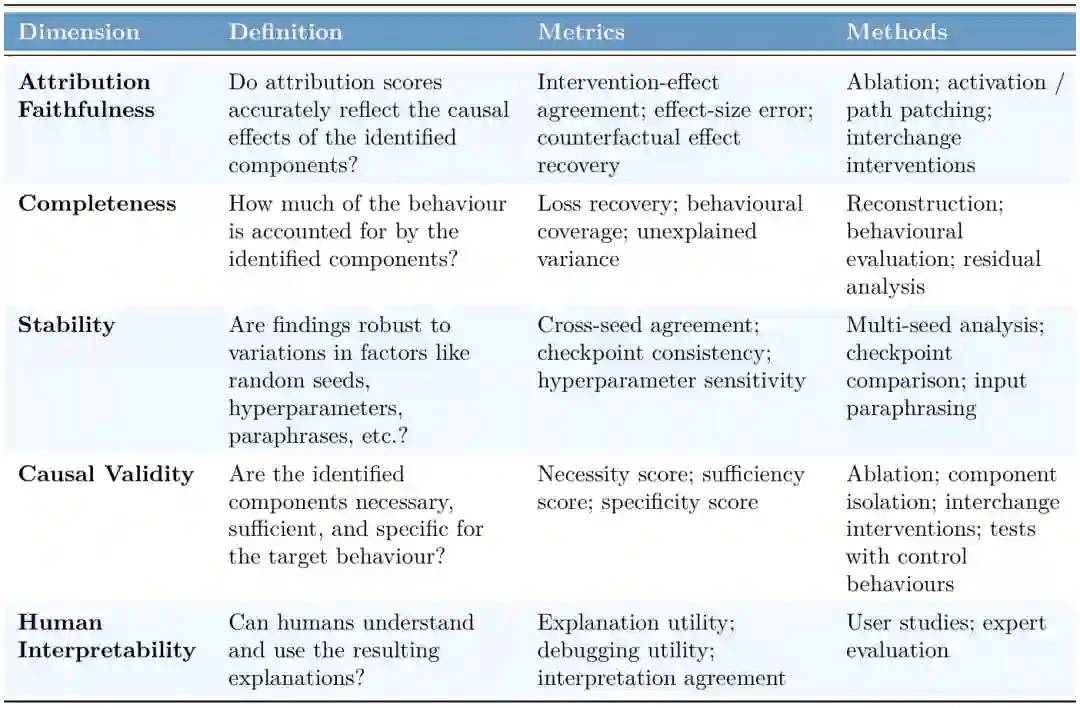
图4:机制可解释性的统一评估框架。五个维度分别配有定义、指标和验证方法。截取自原文表9,第60页。 评估应事先明确目标行为、比较随机部件及强行为基线,在多种输入、种子和超参数下报告不确定性与失败案例。不能仅凭几张易懂的图宣称成功,也不能用单一重构分数替代全部验证。这一框架本身仍需标准化基准支持,并非已经确立的安全认证标准。
8 理解中间表征|Understanding Intermediate Representations
8.1 输出透镜:逐层追踪预测
Logit Lens将中间状态映射到词表,观察预测随深度如何变化。它直观易用,但早期层未必处于适合最终输出映射的坐标空间。
8.2 校准透镜:学习逐层变换
Tuned Lens为不同层学习变换,以改善中间状态解码。更好的解码并不意味着模型内部真的执行了该解码器的计算。
8.3 雅可比透镜:解码计算倾向
Jacobian Lens关注局部计算如何响应变化,为理解表征的后续计算作用提供另一种视角,但其结论仍受局部近似范围约束。
8.4 通过模型解释中间状态
Patchscopes把源情境的激活移植到目标提示,使模型用自然语言表达其中内容。得到的文字受目标提示和模型生成机制影响,不能直接视为内部状态的逐字转写。
8.5 训练激活语言化模型
LatentQA通过训练,使模型能够回答有关隐藏表征的问题。语言化提高了可访问性,也增加了训练偏差及生成错误进入解释的可能。
8.6 探针分类器的能力与局限
探针研究应设置控制任务、选择性指标、复杂度约束及未见数据验证。需要因果结论时,还应结合概念移除或激活干预。“信息能被读出”是证据起点,不是模型实际使用该信息的终点证据。
9 表征分析:比较、定位与控制|Representation Analysis
9.1 模型差分
比较基础模型与微调模型的内部表示,可帮助识别训练引起的变化、共享特征及潜在新增行为。坐标不对齐、特征匹配误差和分解不稳定都可能干扰结论。
9.2 知识定位
定位哪些参数或激活与某项知识有关,为编辑和干预提供入口。但知识可能分布于多个位置,“编辑这里有效”不等于“知识只存储在这里”。
9.3 表征工程与引导
常见引导向量来自正负样本激活均值的差,在推理时加入指定层的状态,以改变行为倾向。需要同时考察控制效果、强度、跨提示泛化及其他能力损伤。
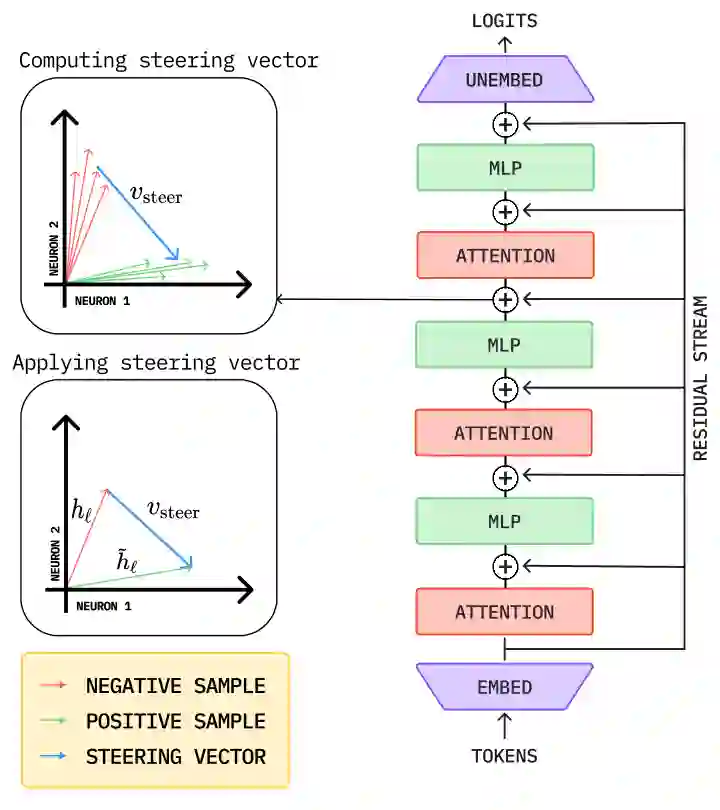
图5:从正负对照样本构造引导方向,并在推理中加入隐藏状态。成功控制说明方向具有因果影响,不代表已经完整解释目标行为。截取自原文图15,第82页。
10 学习动态与机制可解释性|Learning Dynamics
10.1 纵向分析
沿训练检查点追踪特征形成、巩固与漂移,有助于理解能力何时出现、训练数据怎样参与其形成。只看最终模型会错失这些过程证据。
10.2 将学习动态用作解释工具
时间定位可以缩小机制搜索范围;改变训练过程则可能检验机制形成的因果条件。不过,训练干预会同时影响许多因素,需要谨慎设置对照。
10.3 相变与涌现
论文讨论顿悟式泛化、内部进展指标及能力跃迁。外部指标突然改善,并不必然对应内部计算的瞬时诞生;表征可能在更早阶段逐渐形成。
10.4 利用学习动态支持安全
目标是提前预测风险行为并在训练中干预,而不只是在部署前修补。其现实条件包括足够密集的检查点、可获得的训练信息,以及跨规模验证的预测指标。
11 训练数据归因|Training Data Attribution
11.1 逐字数据归因
OLMoTrace等工具通过最大匹配片段,将生成内容连接到训练语料。文本相同可以提供来源线索,却不等于证明特定样本对输出具有因果影响;常见短语尤其需要谨慎处理。
11.2 基于梯度的数据归因
影响函数及相关方法估计改变训练样本权重后,参数和目标输出怎样变化。论文梳理曲率近似、重训练估计、datamodels、TRAK和利用训练轨迹的TracIn等路线。主要瓶颈包括计算、存储、非凸优化及估计目标差异。应说明归因近似了哪一种干预,而非把影响分数统称为输出的“真实来源”。
12 六类研究取向|Six Research Orientations
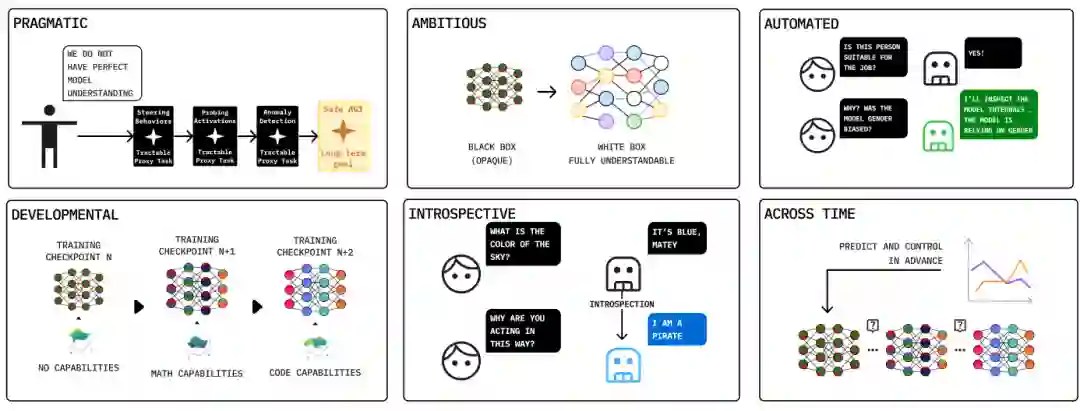
图6:六类研究取向。它们围绕目标、假设和代价组织研究,不是相互排斥的六种算法。截取自原文图17,第102页。
12.1 务实可解释性
优先解决近期安全代理任务,不要求完整理解模型。优势是更易形成可测效果;局限是代理任务改善未必迁移到真实风险。
12.2 追求完整机制理解的可解释性
以尽可能完整的因果理解为目标,强调忠实性和可模拟性。当前小规模、受控设置中的成果,尚不能证明前沿模型可以低成本地被完整解释。
12.3 发展性可解释性
研究表征、机制和能力怎样形成,关注学习阶段、几何结构与相变,试图建立关于模型发展的基础认识。
12.4 跨时间可解释性
同样利用训练过程,但更强调通过动态信息预测和控制未来行为。评价重点包括预测准确性与训练干预效果,而非只描述演化轨迹。
12.5 内省式可解释性
让模型解释自身。自述可以产生候选假说,但模型可能编造、迎合或给出自利解释,因此必须用独立证据和因果干预检验。
12.6 自动化可解释性
借助自动搜索与语言模型扩大特征、回路和解释的分析规模。风险包括系统性错误传播、自动化偏见及自我强化反馈。论文建议结合抽样人工验证、一致性与因果检查、对抗测试、误差校准以及版本化和可追责的监管实践。
12.7 取向之间的权衡
完整性、成本、时效和对欺骗的鲁棒性难以同时最大化。论文的比较用于澄清目标,不应被理解为经过统一实验证实的安全性排行榜。
12.8 如何选择研究取向
近期部署问题可优先采用可验证的务实工具;基础机制研究、训练干预和大规模审计则需要不同组合。方法选择应服从具体问题与资源条件。
12.9 张力与开放问题
完整理解的长期价值如何与近期干预平衡?自动化解释怎样避免超出人类可核验范围?检查点与训练数据如何开放?这些不仅是技术问题,也涉及研究资源和治理安排。
13 从理解到干预:安全应用|Safety Applications
13.1 为什么采用机制方法
输入输出过滤、安全训练及黑盒监测各有作用,也存在绕过、覆盖和成本限制。内部工具可以补充检测与干预接口,但是否更有效仍需与这些替代方案直接比较。
13.2 概念擦除与知识编辑
概念擦除和局部知识编辑尝试改变不希望保留的表示或事实关联。风险是信息通过其他路径仍然可用,或编辑影响无关知识。某个探针失效或某组问答改变,不能证明危险能力已被永久移除。
13.3 引导向量与机制监测
引导用于推理时控制,监测用于识别内部状态中的风险信号。两者都要验证误报、漏报、分布漂移、对抗适应和能力代价;离线测试有效不保证长期部署有效。
13.4 自动化可解释性智能体
智能体可以承担提出假说、调用工具、寻找特征和运行验证等工作。但自动生成的叙述仍是待验证解释,不应因流程复杂就被视为高强度证据。
13.5 针对安全任务选择方法
知识编辑、风险检测与行为控制要求不同。应先定义希望改善的安全结果,再选择内部对象、数据和验证流程,避免围绕现成工具反过来构造问题。
13.6 从研究取向到技术方法
同一种技术可服务于不同研究取向。例如探针既可用于务实监测,也可用于训练动态分析。研究目标、工具与证据要求应分别说明。
13.7 机制可解释性的安全风险
论文将风险归为四类:部分或错误理解造成虚假信心;部署条件变化导致失效;内部知识被用于攻击或规避防护;过度投入挤压其他有效安全措施。机制可解释性因此应嵌入纵深防御,而非成为单独的安全背书。
14 开放问题|Open Problems
14.1 何时必须理解机制
需要识别哪些安全任务确实无法仅靠行为方法解决,以及内部分析在何种条件下提供不可替代的收益。
14.2 评估与基准的挑战
统一指标、可靠真值、负面结果与强基线仍不足。真正有价值的基准应检验发现能否支持未见场景中的预测与干预。
14.3 完整性、扩展性、泛化与鲁棒性
局部回路如何扩展到整个模型?解释怎样跨任务、检查点和模型迁移?面对主动适应的攻击,发现是否仍然有效?这些问题尚未解决。
14.4 机制理解与对齐
识别某种机制,不等于确定模型符合人类意图;控制一个方向,也不等于获得稳定的价值对齐。技术解释与规范目标之间需要明确连接。
14.5 解释与真实结构
人类赋予的概念标签,究竟对应模型内部的自然单位,还是只是方便描述的分类?多个同样有效的分解,使这个本体论问题具有实际方法意义。
14.6 代理忠实度问题
如果解释依赖稀疏替代模型,就必须研究替代模型遗漏了什么。保留总体预测表现,不意味着保留所有安全相关计算路径。
14.7 向其他架构迁移
卷积网络、状态空间模型、循环模型、扩散模型及混合专家架构各有计算特点。针对残差流和自回归预测形成的工具,不能直接照搬;混合专家中的干预还可能改变后续路由,增加因果分析难度。
15 结论|Conclusion
15.1 成就与边界
机制可解释性已经在特征提取、回路发现和定向行为干预上取得进展,但解释的完整性、跨分布泛化和前沿模型扩展能力仍有限。“理解内部机制自然带来安全”仍是需要检验的假设,而不是已经完成的论证。
15.2 未来道路
论文将未来工作概括为三条互补路径:事后解释、研究学习动态、通过设计实现可解释性。共同要求是可证伪、可复现,并用真实的预测和干预收益检验解释价值。 对研究者和开发团队而言,实践重点不是寻找最有说服力的解释,而是建立一条可审计的证据链:明确目标行为,定位候选机制,通过干预检验,报告覆盖和失败范围,再验证其是否真正改善安全结果。 原文题目:Understanding AI from the Inside: The State of Mechanistic Interpretability for AI Safety 论文页面:https://arxiv.org/abs/2611.08438 PDF全文:https://arxiv.org/pdf/2611.08438
 Understanding AI from the Inside: The State of Mechanistic Interpretability for AI Safety


相关内容

 微信扫码咨询专知VIP会员