题目: Learning by Cheating

摘要:

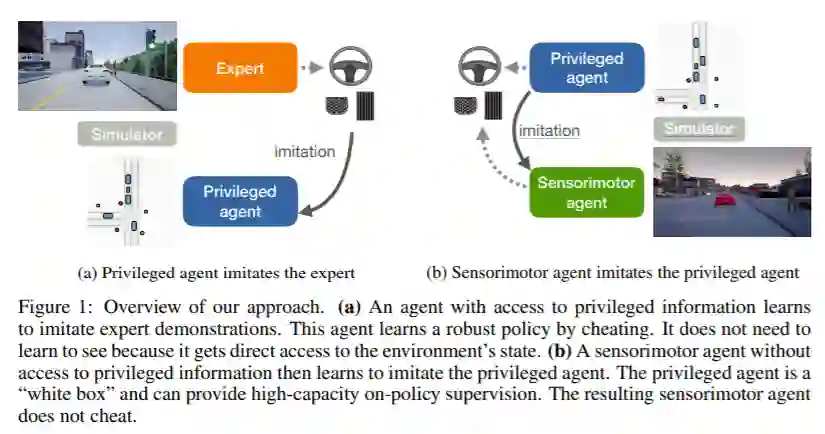
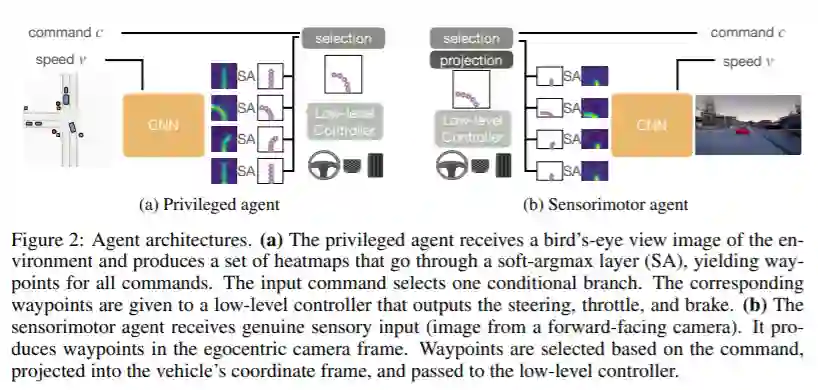
基于视觉的城市驾驶是困难的。自主系统需要学会感知世界并在其中行动。我们证明这个具有挑战性的学习问题可以通过把它分解成两个阶段来简化。我们首先训练一个可以访问特权信息的智能体。这个特权智能体通过观察环境的真实布局和所有交通参与者的位置来作弊。在第二阶段,有特权的智能体充当老师,训练一个纯粹基于视觉的感觉运动智能体。产生的感知运动智能体不能访问任何特权信息,也不会欺骗。这个两阶段的训练程序一开始是反直觉的,但是我们分析和实证证明了它有许多重要的优势。我们使用所提出的方法来训练一个基于视觉的自动驾驶系统,该系统在卡拉基准测试和最近的NoCrash基准测试上的表现远远超过现有水平。我们的方法首次实现了原始CARLA基准测试中所有任务的100%成功率,在NoCrash基准测试中创下了新记录,并将违规的频率与现有技术相比降低了一个数量级。

作者:

Dian Chen是得克萨斯大学奥斯汀分校CS专业的二年级博士生,之前在加州大学伯克利分校学习计算机科学和应用数学专业,在伯克利人工智能研究(BAIR)实验室担任研究助理。研究兴趣是机器人,计算机视觉和机器学习,包括强化学习。个人官网:http://www.cs.utexas.edu/~dchen/

成为VIP会员查看完整内容
28

相关内容

智能体,顾名思义,就是具有智能的实体,英文名是Agent。
【Uber AI新论文】持续元学习,Learning to Continually Learn
专知会员服务
37+阅读 · 2020年2月27日
【CMU】机器学习导论课程(Introduction to Machine Learning)
专知会员服务
62+阅读 · 2019年8月26日
元学习—Meta Learning的兴起
专知
44+阅读 · 2019年10月19日
ICML2019《元学习》教程与必读论文列表
专知
42+阅读 · 2019年6月16日
Reinforcement Learning: An Introduction 2018第二版 500页
CreateAMind
14+阅读 · 2018年4月27日
Andrew NG的新书《Machine Learning Yearning》
我爱机器学习
11+阅读 · 2016年12月7日
Continual Unsupervised Representation Learning
Arxiv
7+阅读 · 2019年10月31日
Meta-Transfer Learning for Few-Shot Learning
Arxiv
8+阅读 · 2018年12月6日
Arxiv
11+阅读 · 2018年7月8日
Relational Deep Reinforcement Learning
Arxiv
10+阅读 · 2018年6月28日
Arxiv
7+阅读 · 2018年5月23日
Arxiv
4+阅读 · 2018年3月19日
Arxiv
5+阅读 · 2017年10月27日
VIP会员
最新内容
世界模型入门:从序贯决策到通用智能体
专知会员服务
8+阅读 · 10月24日
军事域更好使用人工智能的实用指南
专知会员服务
10+阅读 · 10月22日
《衡量语言模型中的作战规划能力》
专知会员服务
14+阅读 · 10月20日
Maven智能系统:帕兰提尔军事人工智能平台详解
专知会员服务
17+阅读 · 10月20日
《测试自动化框架在敏捷软件开发中的角色》
专知会员服务
9+阅读 · 10月20日
俄罗斯如何拦截乌克兰无人机与巡航导弹
专知会员服务
13+阅读 · 10月15日
《武器-目标分配问题:精确与近似求解算法》
专知会员服务
19+阅读 · 10月15日
相关论文
Continual Unsupervised Representation Learning
Arxiv
7+阅读 · 2019年10月31日
Meta-Transfer Learning for Few-Shot Learning
Arxiv
8+阅读 · 2018年12月6日
Arxiv
11+阅读 · 2018年7月8日
Relational Deep Reinforcement Learning
Arxiv
10+阅读 · 2018年6月28日
Arxiv
7+阅读 · 2018年5月23日
Arxiv
4+阅读 · 2018年3月19日
Arxiv
5+阅读 · 2017年10月27日
微信扫码咨询专知VIP会员