
教程|三维视觉语言模型:从几何表示到开放词汇与具身交互
导读
输入一句“找到这把椅子”,模型需要完成的可能是三种不同任务:判断一个三维对象的类别,从资产库中检索对应形状,或在场景里定位具体椅子。若继续问“椅子在桌子的哪一侧”,甚至要求机器人搬动它,系统还需要空间关系理解和动作能力。把三维数据接入语言,远不止给点云加一个文本标签。 这篇教程论文《An overview of 3D Vision-Language Models》从三维表示和编码器出发,解释如何通过CLIP式对比学习,把几何、图像与文本放入可比较的语义空间;随后梳理投影适配、原生联合嵌入、语言对齐的三维高斯表示,以及接入大语言模型的生成式路线。它的核心区分是:嵌入式三维视觉语言模型擅长相似度匹配,三维视觉大语言模型则面向描述、问答与指令交互,二者的目标、架构和风险并不相同。 以下按原文五个一级部分展开,保留全部12个下级小节。配图使用论文原图,内部英文标注不改动,图注采用中文。本文是一篇教程解读,不是统一基准下的新实验报告,不将图中示意分数当作实测性能。 论文信息
- 原题:An overview of 3D Vision-Language Models。
- 作者:Márcus Lobo、Vitor Matias、Afonso Paiva、Jeová Farias、Tiago Novello、Moacir Ponti;前两位为共同贡献作者。
- 机构:圣保罗大学数学与计算机科学研究所、巴西纯粹与应用数学研究所、鲍登学院。
- 版本:arXiv于2026年9月4日提交,全文6页;摘要页注明已被接收为SIBGRAPI 2026教程。
- 论文页面:https://arxiv.org/abs/2609.05583
- 原文下载:https://arxiv.org/pdf/2609.05583
- 作者提供的教程页面:https://usmarcv.github.io/Tutorial-3DVLMs/。
1 Introduction|绪论
理解三维对象与场景,需要联合处理几何、外观和语义。二维图像是规则像素网格,三维数据却可以是无序点集、带拓扑连接的网格、多视图渲染、稀疏体素或高斯基元。不同表示保留的信息不同,也需要不同的编码方式。 传统三维深度学习通常在闭集设定下工作:训练与测试共享固定类别,模型把输入映射到预设标签。MVCNN和PointNet分别展示了多视图与点云的编码路线,但用于特定分类任务的输出,并不会自然形成可用文本或图像查询的跨模态空间。 CLIP提供了另一条路径:学习图像和文本的共享嵌入,使匹配内容具有较高相似度。三维视觉语言模型进一步将几何嵌入与已有图像—文本空间对齐,使自然语言可以参与对象识别、开放词汇理解和跨模态检索。
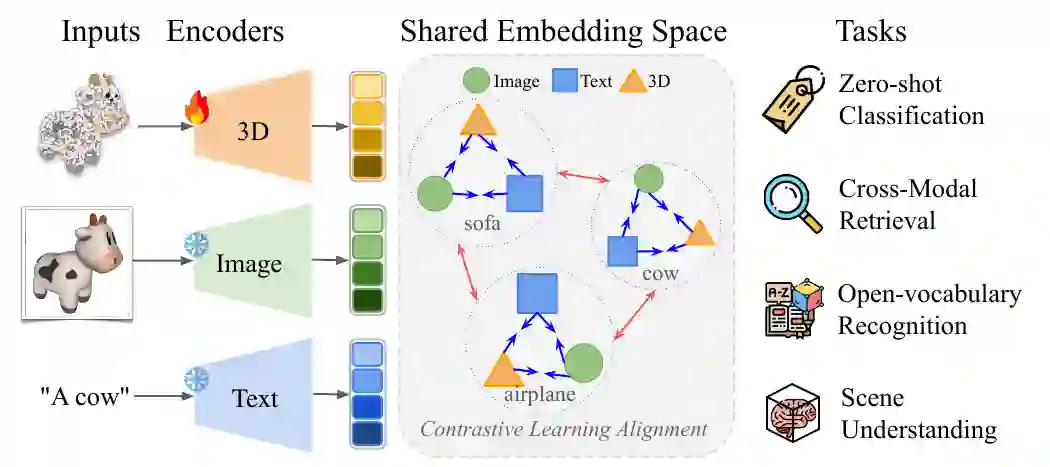
图1:三维、图像和文本分别经编码器映射,通过跨模态对比目标对齐到共享语义空间,再用于分类、检索、开放词汇识别等任务。来源:原论文图1,第1页。 论文特别区分两类模型。三维视觉语言模型(3D VLM)主要输出嵌入或相似度,用于比较、排序和识别;三维视觉大语言模型(3D VLLM)把三维特征或令牌送入大语言模型,生成描述、回答问题、响应指令或处理空间关系。 这一区分能避免概念混用:能够把文本与形状匹配,不意味着已经能可靠回答复杂空间问题;能够生成流畅回答,也不证明其描述符合真实几何。
2 Representations and Cross-Modal Alignment|表示与跨模态对齐
原文从匹配的三元组出发:一个三维对象或场景表示S,一幅相关图像I,一段相关文本T。三个编码器分别提取特征,再经投影层映射到同维度、经过归一化的嵌入。文本可能是类别名、对象描述、问题、指代表达或指令,而不是只有一种标注形式。 在CLIP式方法中,图像和文本编码器常由预训练模型初始化,并可以保持冻结;三维编码器学习与其视觉语义空间兼容的表示。不过具体哪些组件可训练,取决于方法设计,不能把所有三维模型都概括为同一种冻结方案。
2.1 三维输入与编码器
多视图图像。 从多个视点渲染同一个对象,用共享二维编码器处理各视图,再聚合为对象级特征。优势是能借助成熟的图像基础模型;代价是视点和渲染选择会影响哪些几何信息可见,被遮挡或未投影出的结构可能丢失。 点云。 点云是三维坐标组成的无序集合,可以附带法向或颜色,也是激光雷达、深度传感器的重要输出形式。模型需要处理排列无关性、局部邻域与长程几何关系。PointNet、动态图网络、点云Transformer以及掩码预训练分别提供不同编码思路;稀疏卷积则适合稀疏空间数据。原文还介绍将点云分解成紧凑几何基元的研究方向。 网格。 网格通过顶点、边和面描述表面,保留显式连接关系,是计算机图形学的重要表示。MeshCNN侧重边上的运算与池化,MeshNet使用面级空间及结构特征。网格学习的难点不仅是坐标,还包括不规则拓扑与连接关系。 隐式场。 占据函数或符号距离函数以连续函数表达表面,而不是直接列出全部点或面。Michelangelo等工作把这类形状潜表示与图像、语言对齐。这条路线体现了共享语义空间可以连接不同几何表示,但并不意味着它们的几何编码完全相同。 三维高斯泼溅。 三维高斯泼溅(3D Gaussian Splatting,3DGS)用包含中心、协方差、不透明度与颜色的各向异性高斯基元描述场景,再通过可微渲染形成图像。它同时携带几何和外观,便于联系二维视觉监督。虽然高斯中心也是空间点,但完整高斯表示还包含更多属性,不能简单等同于只有坐标的点云。
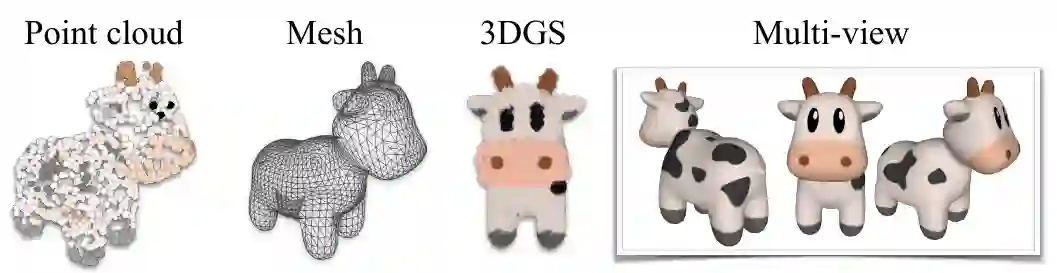
图2:点云、网格、三维高斯表示和多视图图像的对比。不同表示暴露的结构与外观信息不同,决定了编码器及后续任务的适用条件。来源:原论文图2,第2页。 表示选择因此不是无关紧要的前处理。对象级检索、场景交互、资产生成和机器人感知,对细节、外观、度量精度与计算成本的要求并不相同。
2.2 对比对齐的几何视角
同一把椅子可以表现为点云、渲染图或“木制椅子”这段文字,但三个原始特征空间并不天然可比。即使向量维度相同,距离也可能更多反映编码器差异,而不是语义对应关系。 对比学习把它们投影到共同空间,提升匹配对象之间的相似度,相对于批次内其他候选强化正确对应。直观上,这是一张语义地图:表达相同内容的不同模态靠近,不匹配内容在相对关系上分开。 当嵌入经过二范数归一化,它们位于单位超球面,内积等于余弦相似度。因此,对齐也可以从角度理解:匹配的三维与图像、文本向量应具有更小夹角。这里的角度是嵌入空间角度,不是物体在真实世界中的朝向。
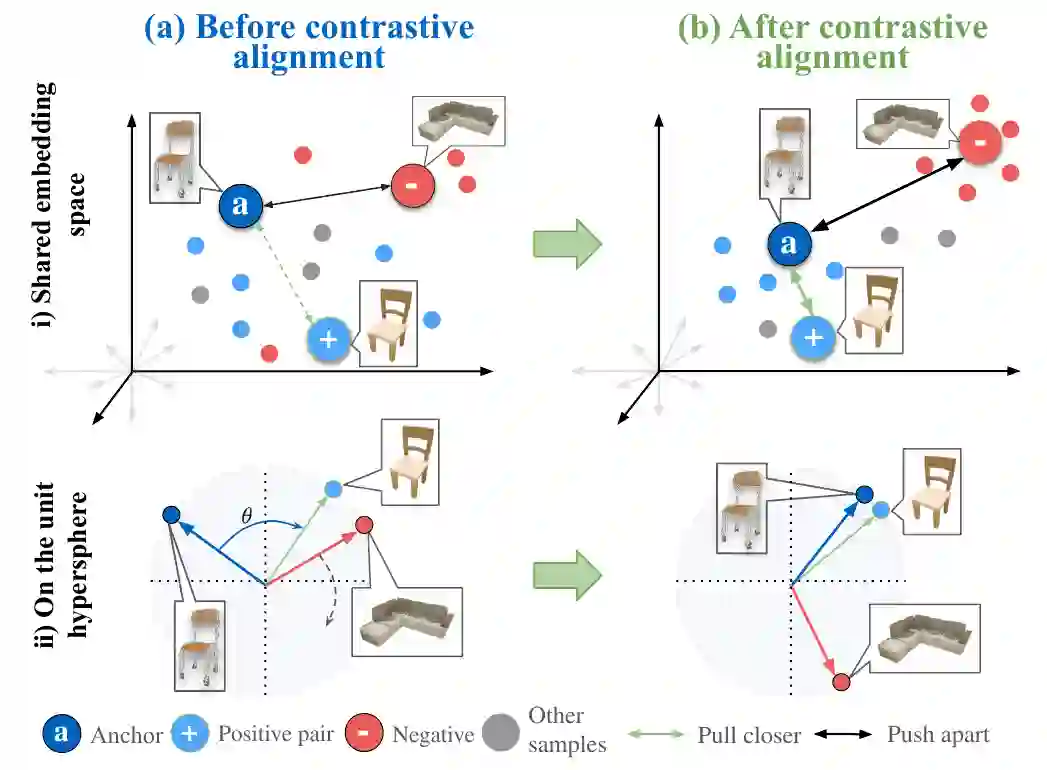
图3:对齐前,三维锚点可能比自己的匹配样本更接近其他候选;对比目标改善这种相对关系。上半部分展示共享空间,下半部分展示单位超球面的角度解释。来源:原论文图3,第3页。 “正样本”与“负样本”由锚点的对应关系决定:配对图像或文本为正,其余批次候选为负。它们不是对内容质量的价值判断。共享空间改善跨模态比较,但不能仅凭语义相近,就认定模型已保留全部几何细节。
2.3 三维视觉语言模型的对比对齐
训练时,对一个批次中的N组匹配数据,构建三维—图像和三维—文本相似度矩阵。主对角线是匹配关系,非对角线是其他候选。相似度通常为两个归一化向量的内积除以温度参数,温度调节匹配分布的集中程度。 方向性的InfoNCE损失,可以理解为跨模态N选一:给定三维锚点,从整批图像或文本中识别与其配对的样本。损失提高正确配对相对于其他候选的概率,而不只是孤立地拉近两点。 匹配通常双向进行。例如,三维找图像与图像找三维各有一个方向性损失,两者取平均;三维与文本也采用类似方式。原文给出的三模态目标是两个双向目标相加: 总对齐损失 = 三维↔图像损失 + 三维↔文本损失。
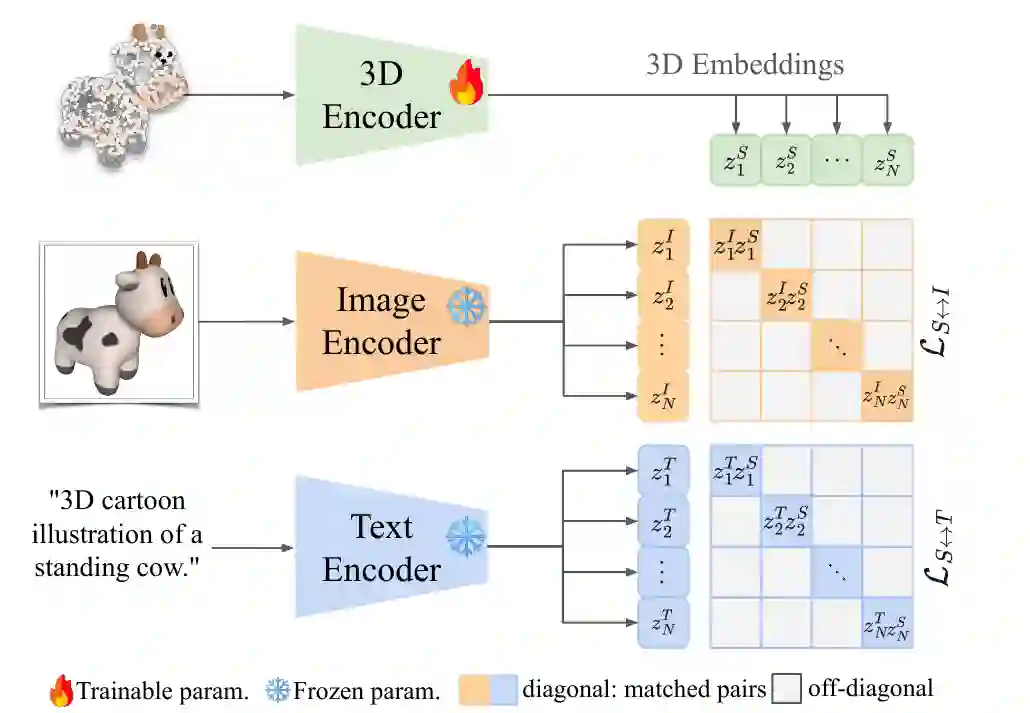
图4:三维编码器与图像、文本编码器进行CLIP式对齐。两组相似度矩阵的对角线表示匹配正对,其余项为批内候选;图中的训练与冻结标记描述所示方案。来源:原论文图4,第3页。 若图像和文本编码器继承CLIP,三维编码器就可以借助已有视觉语义结构学习比较能力。不同方法的主要差异仍包括三维表示、骨干网络、监督质量、配对构造与可训练组件,不能只看损失形式是否相同。
3 A Taxonomy of 3D Vision-Language Models|三维视觉语言模型分类
3.1 从闭集三维识别到语言对齐
早期模型在固定类别中分类,后续图网络与Transformer提高了几何编码能力,但任务标签仍约束输出。语言对齐把固定分类头连接到连续语义空间,使推理时可用文本定义类别或查询对象。 零样本分类指不针对待识别类别进行专门的标签训练,并不意味着模型从未预训练、没有见过相关语义,或对任何新类别都可靠。开放词汇扩大了查询接口,识别质量仍取决于数据覆盖、描述方式和领域差异。
3.2 基于投影的三维视觉语言适配
投影路线将不规则三维结构转换为二维视图,让已有图像编码器处理。PointCLIP使用多视图深度图与文本类别特征比较,PointCLIP V2通过改进投影和三维相关提示增强迁移,EPCL探索冻结CLIP特征在点云理解中的使用。 该路线的吸引力是可以较直接复用二维预训练能力,部分方法无需另行学习专用三维编码器。但它依赖视点选择、渲染质量和投影保留的信息。二维语义强,不保证隐藏结构、精确尺度和拓扑信息同样完整。
3.3 原生联合嵌入空间
联合嵌入方法直接训练三维编码器,使原生几何输入产生与图像、文本兼容的特征。CG3D、CLIP2Point探索早期迁移,ULIP采用广泛使用的三模态对齐形式,将点云编码器与冻结图像、文本编码器联系起来。 后续研究从数据、监督和模型规模推进:OpenShape强调大规模、多样三维资产,Uni3D探索可扩展骨干,ULIP-2使用自动生成描述;其他方法改善增强、跨模态监督、模态间差异和轻量适配。 教程还讨论向通用空间编码器的扩展。Concerto结合三维自蒸馏和二维—三维联合嵌入,再连接语言空间;Utonia研究跨异构点云领域的统一自监督编码。这些工作不应全部概括成相同的三元组训练流程。 原生编码通常能保留比投影更多的几何信息,但需要大规模配对数据,面临弱监督或噪声描述以及预训练成本。保留几何也不是自动发生的,仍由编码器和训练目标决定。
3.4 三维高斯泼溅与视觉语言模型
高斯表示将几何与可渲染外观放在同一结构里,因此能建立三维基元和二维视觉监督之间的联系。UniGS将三模态对齐扩展到高斯特征;TIGaussian分解不同属性的潜分支并利用多视图融合;CLIP-GS关注高斯令牌化与视点感知监督,用于跨模态检索。 这种路线有利于把语义附着到可交互的三维场景,但仍依赖重建质量,并可能引入较高存储和逐场景处理成本。对象级高斯检索与场景中的语义分割、编辑虽共享表示,也不是同一个任务。
3.5 三维视觉大语言模型
这类模型通常由三维编码器或令牌化器、学习到的投影器和预训练语言骨干组成。投影器把三维特征接入语言模型的输入空间,语言模型在几何信息和文本指令条件下生成回答。 PointLLM和ShapeLLM代表这一常见架构;PointAlign以特征正则保持几何信息;Multi-3DLLM处理多对象关系;SAGE将点云转换为离散令牌;N3D-VLM强调原生三维定位与空间推理。 从嵌入式模型转向生成式模型,也改变了学习目标:从跨模态比较转向语言生成。由此获得交互能力,同时增加幻觉、几何保真、令牌效率和三维指令数据不足等问题。流畅语言不是空间正确性的替代指标。
4 Current Trends and Emerging Applications|当前趋势与新兴应用
原文这一部分按四个小节展开,应用图则展示八种任务形式。它们共享三维与语言连接能力,但输出和评价目标各不相同,不应混作一个统一任务。
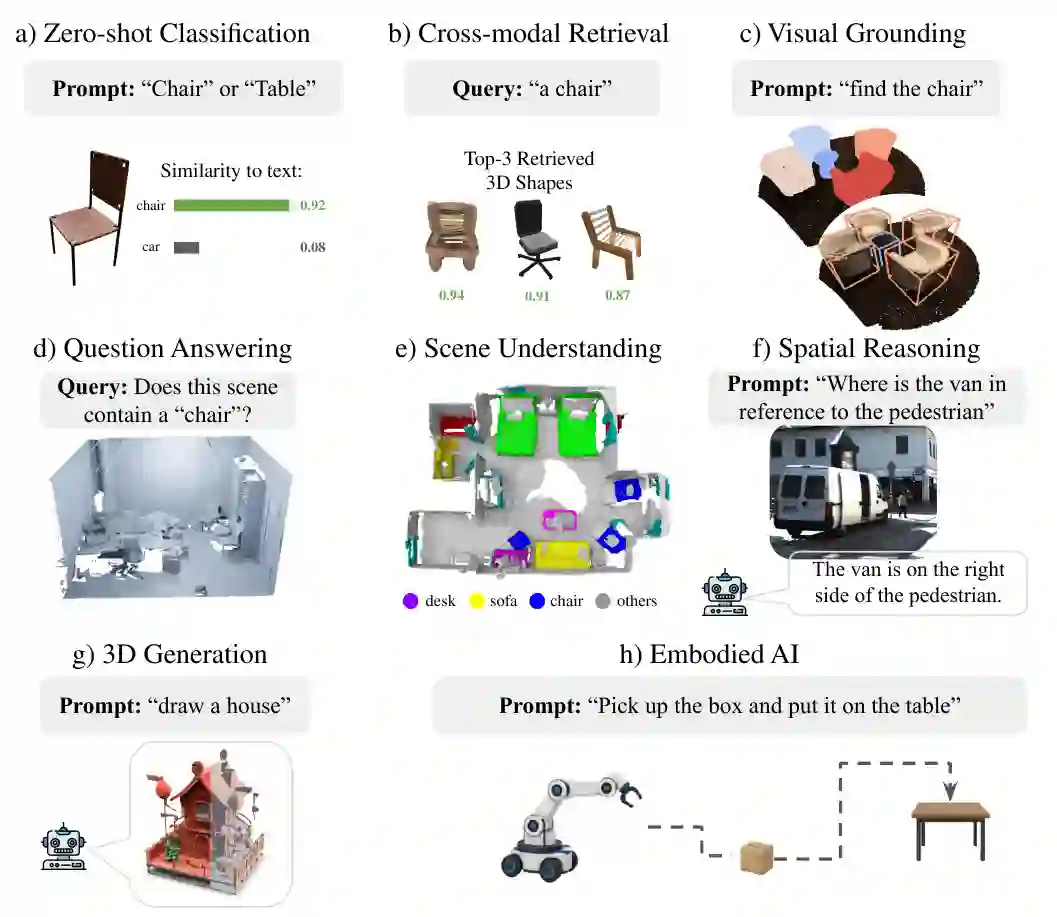
图5:零样本分类、跨模态检索、视觉定位、问答、场景理解、空间推理、三维生成与具身交互。图中相似度和排序数字为任务示意,不代表统一实验结果。来源:原论文图5,第5页。
4.1 识别、定位与检索
零样本分类把三维对象与文本类别比较,输出候选类别分数;跨模态检索用文本或图像查询资产库,输出排序后的三维对象;视觉定位则把指代表达落到场景中的空间区域。 PointCLIP系列通过投影迁移图像—文本知识,ULIP、OpenShape与Uni3D通过原生嵌入支持识别和检索,CLIP-GS将检索扩展到高斯表示。多对象与原生几何模型进一步支持定位和关系理解。 这三种任务的共同基础是语言对齐,差别是输出分别为类别、排名或位置。“检索到一个椅子模型”与“找到当前房间里的那把椅子”,在粒度和几何要求上并不相同。
4.2 场景理解与空间推理
三维问答从单对象属性走向多对象关系。PointLLM和ShapeLLM处理对象相关语言交互,Multi-3DLLM将关系建模扩展到多个对象,N3D-VLM强调原生三维依据。 场景级方法还把语义特征嵌入高斯表示:语言嵌入高斯研究跨视图一致性,Gaussian Grouping与Unified-Lift支持实例分割、分组和编辑,OpenGaussian提供点级开放词汇理解,GaussianCut支持交互对象分离,SceneSplat探索无需逐场景优化的语言对齐特征预测。 场景语义标签、对象边界与空间关系需要共同准确。文本查询、点击和空间提示可以形成交互入口,但若几何依据不足,正确的类别词也不能保证位置、方向和关系正确。
4.3 三维生成
生成任务需要合成几何与外观,而不仅是比较现有对象。原文讨论MeshGPT和MeshFlow等几何生成方法,同时明确它们本身属于几何生成器,不应仅因能生成三维内容就自动归为视觉语言模型。 TRELLIS以文本或图像条件生成结构化三维内容,并支持网格、辐射场或高斯等输出;SAM 3D则研究由单张图像恢复几何、纹理与布局。几何生成、多模态条件生成和图像重建是互补方向,其输入条件与监督目标不同。
4.4 具身人工智能
具身任务把语义与空间理解连接到物理行动。CLIPort结合语义和空间通路进行操作,Gato探索跨感知与控制的通用序列模型,RT-2、Octo、OpenVLA和GR00T N1等视觉—语言—动作模型把观察与指令映射为动作。 作者特别指出,这些系统多数主要依赖二维观察,因此不能全部称为显式三维视觉语言模型。三维表示可以补充度量深度、物体范围与空间关系,但动作控制还面临时延、三维—语言—动作数据不足、未见环境鲁棒性及几何精度保持问题。 “能够说出怎么做”与“能够安全、准确地执行”之间仍有距离。语言接口、几何感知与动作策略需要分别验证,而不能由某一项能力替其他环节作保证。
5 Conclusion and Future Directions|结论与未来方向
教程梳理了从二维投影到原生联合嵌入,再到语言对齐的高斯表示与三维视觉大语言模型的路径。共同目标是让语言成为访问三维对象和场景的接口;不同路线在复用二维知识、保留原生几何、表达外观和支持生成交互之间作出不同选择。 原文归纳的核心挑战包括:缺少能够跨点云、网格、高斯与结构化潜表示泛化的可扩展编码器;现有具身模型对显式几何利用有限;多模态对齐效率、三维—语言—动作数据规模,以及合成资产向真实传感器数据迁移仍需改进。 这些是未来研究方向,不是本文已经实现的统一三维基础模型。论文也未给出全部路线在相同数据、预算和指标下的统一性能比较,因此不能据此宣称某类表示或某个方法在所有任务上最优。 对读者而言,这份教程提供的关键框架是:先辨明三维表示保留什么,再判断任务需要相似度匹配还是语言生成,最后审视几何信息是否在对齐和交互中得到保留。三维视觉语言学习的进展,不仅是让模型“会描述三维”,更是让语义、几何与实际操作之间建立可检验的联系。 原文入口: 论文摘要与版本记录;完整论文与参考文献;作者教程页面。文中方法介绍依据该教程,具体架构和实验设置请查阅原文及其引用研究。
 An overview of 3D Vision-Language Models



 微信扫码咨询专知VIP会员