
多模态一定更好吗?从参数几何诊断缺失模态退化
导读
多模态模型在图像和文本都可用时通常更强,但部署环境未必总能提供完整输入。当图像完全缺失、只剩文本时,一个经历多模态训练的模型,是否至少能达到只用文本训练的模型水平?这篇论文给出的实验答案是:并不一定。在所考察的27组架构与数据集组合中,多模态训练后以文本单独推理的模型,全部落后于对应的文本专门化参考模型。 作者进一步把这一现象与跨模态交互层的主参数子空间旋转、任务相关表征偏移联系起来,提出测地线遗忘(Geodesic Unlearning,GU):利用匹配的单模态参考模型,选择一个目标层,在Grassmann流形上调整其主输入子空间,再重构权重。该方法不需要对原多模态模型进行梯度更新,但需要参考模型与开发集。其价值不是“让丢失的信息重新出现”,而是在一定程度上纠正多模态训练留下的不利依赖,同时尽量保留完整输入时的能力。 以下按原论文七个章节的顺序解读,并补充附录中的证据与限制。原图内部标注保留英文,图注采用中文。
论文信息
- 原题:Do More Modalities Always Help? A Geometric Perspective on Missing-Modality Robustness
- 作者:Songyuan Sui、Zhen Tan、Mohan Zhang、Rana Muhammad Shahroz Khan、Xia Hu、Tianlong Chen。
- 机构:莱斯大学、史蒂文斯理工学院、北卡罗来纳大学教堂山分校。
- 版本:arXiv于2026年10月3日提交;摘要页备注标注“NeurIPS 2026 Main Conference”。本文依据当前论文版本解读。
- 论文页面:https://arxiv.org/abs/2610.04792
1 Introduction|绪论
多模态学习通常依靠不同输入之间的互补性:图像补充视觉证据,文本提供语义线索,交互模块将两者结合。但真实部署可能因传感器故障、隐私约束、成本限制或数据管道异常而缺少一个模态。模型此时不能直接沿用“训练时始终具备完整输入”的假设。 一个容易被忽略的问题是,退化不只有“丢失图像自然损失信息”。多模态训练也可能改变模型使用文本的方式,形成对另一模态的依赖。因此,缺失图像时,模型甚至可能比从始至终只看文本的同类模型更差。论文把这一差距视为需要诊断与纠正的部署失效,而不是仅以填补空输入作为处理终点。 论文的研究路线有三步。首先,跨模型家族验证退化是否反复出现;其次,从参数子空间和任务相关表征两个角度寻找退化特征;最后,把观察转化为一个局部参数编辑方法,评估“缺失输入下恢复多少”与“完整输入下损失多少”的权衡。 需要强调的是,论文没有证明“多模态学习必然有害”。它研究的是特定缺失模态部署条件下的可靠性问题,实验范围也以双模态分类为主。完整输入条件下,多模态模型总体仍表现出优势。
2 Related Work|相关工作
原文围绕三条研究线索展开。第一条是缺失模态鲁棒性,包括缺失信息补全、模态恢复、动态路由与自适应融合等方法。这些方法可以利用剩余输入估计缺失内容,或根据当前可用模态改变融合策略。不过,“部分样本缺失某种模态”与“部署时某一模态在全部样本中彻底不存在”并非同一问题。在后者中,双模态系统只剩一条有效输入通路,恢复与路由可利用的互补证据更有限。 第二条是参数空间几何。权重矩阵的奇异值分解可以揭示模型主要读取与输出的方向,Grassmann流形则把子空间作为研究对象,避免将同一子空间的不同基底表示误判为结构差异。论文借此比较多模态模型与单模态参考模型,并用测地线控制主子空间的移动。 第三条是机器遗忘。传统遗忘常以移除指定训练数据影响为目标,近年来也扩展到纠正模型行为与能力。本文借用了这种“选择性削弱依赖”的思想,把目标设为缺失模态条件下的有害跨模态依赖。这里的“遗忘”不是经过认证的个人数据删除,也不构成隐私擦除保证。
3 Problem Setup and Preliminaries|问题设定与预备知识
3.1 部署阶段的模态完全缺失
论文关注模型用完整多模态输入训练,但推理时缺少某一模态的场景。主体实验采用文本与图像两种模态,部署时图像在所有测试样本中完全缺失,文本仍然可用。缺失输入通过掩码、零值特征或空嵌入等方式表示,具体取决于模型实现。 这不是随机遮住少量图像,也不是训练与测试都只用文本。明确这个边界,才能正确理解基线方法的表现与论文结论。
3.2 评估协议与两类性能差距
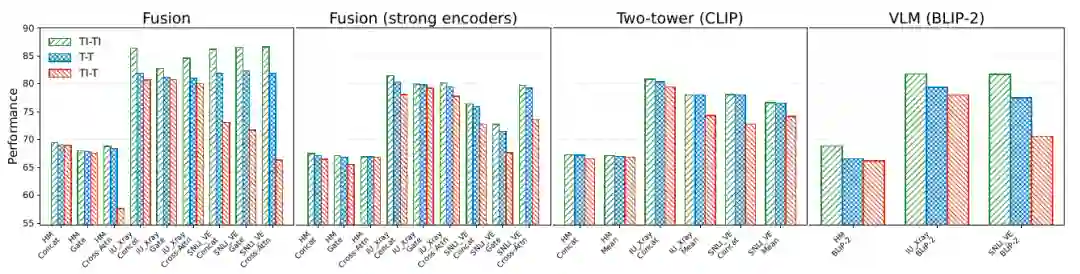
作者设置三种训练—测试组合:TI–TI表示训练和测试都有文本与图像;T–T表示训练和测试均只有文本;TI–T表示训练时双模态、测试时仅文本。主体实验以F1作为性能指标。 两类差距分别回答不同问题:
- 缺失模态差距:Δmiss = F1(TI–TI) − F1(TI–T),衡量拿掉图像后的总体损失。
- 单模态参考差距:Δuni = F1(T–T) − F1(TI–T),衡量缺失图像的多模态模型比文本专门化模型差多少。
前一差距包含图像信息消失带来的正常损失,不应全部解释为可纠正的有害依赖。后一差距更直接反映多模态训练后剩余通路的不足。 T–T参考模型也不是任意拿来的另一个文本模型:它与多模态模型采用匹配的整体架构、预训练参数化和对应层形状,图像分支在训练与测试中都保持空输入。这样的对齐使后续层级比较与子空间编辑具有对应关系。
3.3 参数子空间的几何表示
对某个线性层权重W进行奇异值分解,可写成W = UΣVᵀ。取前k个主方向,V对应主要输入方向,U对应主要输出方向,Σ描述这些方向的强度。直观上,V揭示这一层重点“读取”哪些输入组合。 作者把V张成的k维子空间视为Grassmann流形上的一个点。该表示关注子空间本身,而不是具体基底:即使基底经过内部旋转,只要张成空间不变,其几何对象也不变。 两个模型对应层的主子空间差异,通过主角度度量。具体而言,对两组主输入基底的交叉乘积求奇异值,再取反余弦,得到各个主角度;均值反映总体偏离。主角度越大,说明两层所侧重的输入方向越不一致,但它本身并不等同于任务错误率。
4 Empirical Analysis|缺失模态退化的实证分析
4.1 分析范围:架构与基准
论文覆盖四类模型家族:RoBERTa与ResNet50组成的融合模型;Qwen2.5-3B与OpenCLIP ViT-bigG-14组成的强编码器融合模型;OpenCLIP ViT-L-14双塔模型;带分类头的BLIP-2视觉语言模型。两类融合模型各比较拼接、门控与交叉注意力,双塔模型比较均值池化与后期拼接。 三组主体数据集分别是Hateful Memes、SNLI-VE与IU-XRay。它们涉及图文仇恨内容识别、视觉蕴含和胸部影像—报告相关分类。SNLI-VE在本文设定中去掉中立类别,转成二分类。27组组合来自9种模型配置与3个数据集,不是27个完全独立的新架构。
4.2 不同架构是否都出现退化
全部27组组合都有T–T优于TI–T,意味着缺失图像的多模态模型未达到匹配文本参考模型的表现。其中26组满足TI–TI > T–T > TI–T;剩余一组中,完整输入与文本参考并列,但仍高于缺失图像推理。 缺失模态差距Δmiss平均为4.74个F1百分点,范围从0.08到20.29。这说明退化普遍出现在所测设置中,但程度差异很大。一些架构几乎不受影响,另一些则明显依赖跨模态交互。
4.3 参数几何是否跟随性能退化
作者发现,跨模态交互层的主子空间偏移与缺失模态差距呈较强正相关。为了避免模型尺度不同造成混淆,先在模型家族内部进行标准化;27组组合合并后,相关系数为0.91,决定系数为0.82。 未经标准化的家族内部结果也呈正关联:普通融合模型、强编码器融合模型、双塔模型的相关系数分别为0.93、0.88和0.86。BLIP-2只有三个数据点,即使相关系数很高,也只能作描述性观察,不能据此作强统计推断。 一个典型例子是SNLI-VE上的普通融合交叉注意力模型:缺失模态差距达到20.29个F1百分点,交互层输入与输出主角度约为16.00°和16.57°,最终分类器对应角度仅为1.95°和0°。这提示主要参数变化不一定集中在最终决策头,而可能发生在更早的交互位置。
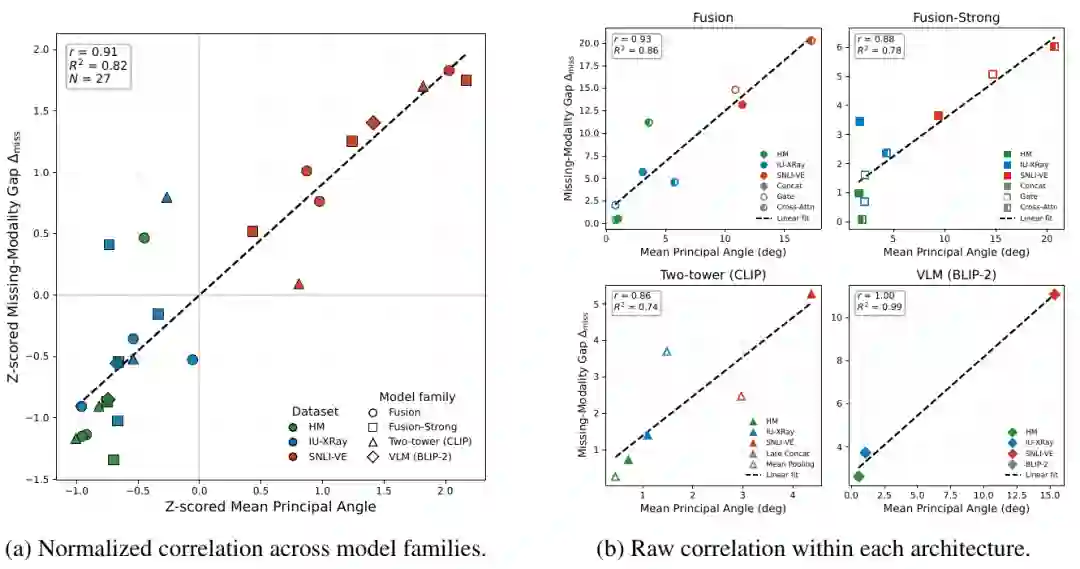
这些结果支持参数几何作为诊断信号,但相关性不等于普遍因果定律。后续编辑实验提供了干预证据,也仍受所选架构、数据集与任务限制。
4.4 表征损害主要集中在哪里
除了比较参数,作者还追踪输入投影、跨模态交互和分类器等阶段的任务相关表征。二分类中,先由正负类表征质心确定类别分离方向,再计算样本相对于两类中点的有符号投影间隔;取间隔的负值作为“表征损害”指标。 研究把样本按缺失模态条件下的最终预测分成错误组与正确组,在每个中间阶段比较两组平均损害差。这样可以观察最终失败样本从哪一阶段开始偏离有利于分类的方向。 结果显示,损害差在跨模态交互阶段已经出现,且往往延续到分类器附近。因此,分类器处的异常可能是上游偏移的延续,而不是所有问题都由分类头独立产生。
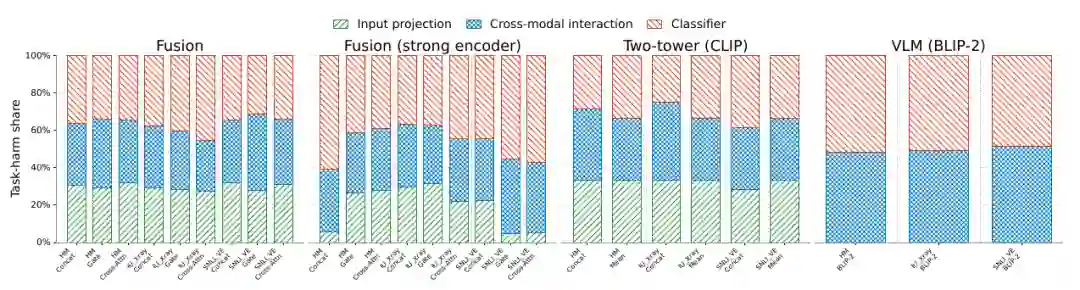
这个诊断使用最终错误分组,不能单凭分组差异就断言某层独立导致错误;图中的归一化占比也不是各阶段的错误率。结合参数几何结果,它主要用于定位值得尝试局部纠正的位置。
5 Geodesic Unlearning|测地线遗忘
5.1 方法概览
GU接收一个已训练的多模态模型和一个匹配的单模态参考模型。它首先选择一个目标层,再把该层的主输入子空间沿测地线向参考子空间移动,最后重构权重。其他层保持不变,部署时只使用编辑后的模型,不再需要参考模型参与前向计算。 方法的核心是选择性纠正,而非整网重训练或完整权重替换。它希望保留多模态模型已有的输出结构与大部分参数,仅降低缺失输入条件下不利的跨模态依赖。
5.2 目标层选择
候选范围包括交互层及附近的投影、分类层。作者在开发集上计算每层的平均主角度和错误组—正确组表征损害差,分别在当前模型的候选层中标准化,再相加形成选择分数:sℓ = z(平均主角度ℓ) + z(表征损害差ℓ)。最高分层成为编辑对象。 两项信号分工不同:主角度找出与单模态参考偏离明显的位置,损害差判断这种偏离是否伴随任务相关表征问题。同阶段的候选层可使用该阶段的诊断值。选择依赖开发集,测试集不应参与挑层或调参。
5.3 子空间重对齐与权重重构
将目标层原始权重分解为主秩部分和剩余部分:W = UₖΣₖVₖᵀ + R。GU保留原模型的Uₖ、Σₖ与R,只把Vₖ对应的子空间沿Grassmann测地线移向单模态参考,得到V(η),再重构W′ = R + UₖΣₖV(η)ᵀ。 η控制移动程度。η = 0对应不编辑;η = 1把主输入子空间移到参考端点,但不意味着整层权重等于参考模型,因为输出因子、主系数与残差仍来自原模型。正文默认使用开发集选择的η = 0.75、k = 8,并在不同模型与数据集上保持固定。 理论保证的含义也需要准确理解。在给定Grassmann距离预算的条件下,沿连接两个子空间的最短测地线移动,能够最小化到参考子空间的剩余距离。移动η比例的路程后,剩余距离相应为原距离的1−η比例。 这是一项几何最优性结果,不是F1最优、完整模态能力零损失或应用安全保证。保留主系数和残差,也不应被表述成“重构后的整层奇异值谱严格不变”。 论文另外比较了完整权重插值,以及对齐基底后的线性子空间插值。后者虽然保留同样的其他因子,但不同主角度方向的推进速度通常不一致。测地线提供了更明确、统一的几何移动路径。
6 Experiments|实验
6.1 实验设置
主要基线对比在RoBERTa–ResNet50交叉注意力模型上进行,包含空输入直接推理、SMIL、Flex-MoE、DyMo及权重插值。缺失图像恢复与完整输入保持则扩展到全部模型家族。主要性能表报告三个独立运行的均值,附录提供标准差与十种子配对统计。 这里应按实际设定理解基线:测试时图像在全部样本中完全不可用,只剩文本。某些原本面向部分缺失或更丰富可用模态的补全、路由方法,在这个严格双模态条件下未必发挥优势,不意味着这些方法在所有原始适用场景中失效。
6.2 缺失模态条件下的主要结果
GU在三个主体数据集上取得主表最高F1:Hateful Memes为60.88,IU-XRay为81.41,SNLI-VE为74.41,分别高于各自最强比较基线2.38、1.27和2.21个F1百分点。
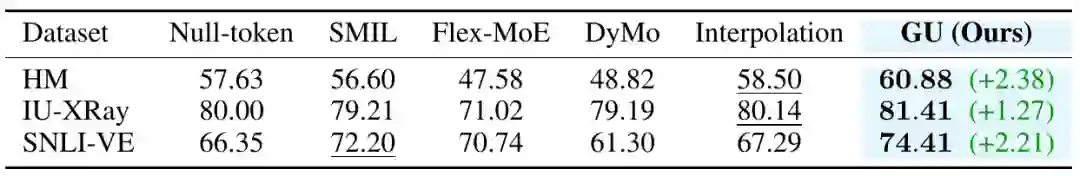
其中,SNLI-VE的空输入基线为66.35,权重插值为67.29,SMIL为72.20,GU为74.41。这说明局部几何纠正的收益不仅超过不处理缺失输入,也超过简单的整层权重混合。 附录进一步用十个匹配种子进行配对检验,对六组比较执行多重比较校正后均达到p < 0.05。与对应最强基线的三十次配对运行中,GU全部获胜;这组十种子结果的平均提升与三次运行主表略有差异,不能混作同一统计口径。 表征分析还揭示一个细节:在SNLI-VE上,GU与原模型的全局表征相似度仍很高,CKA为0.991,权重插值为0.988;但GU纠正了原错误样本的34.0%,插值仅纠正11.8%。同时,GU使原正确样本中的5.1%变错,插值为4.5%。纠错率与退化率的分母不同,不能直接相减得到净提升。整体表征“看起来接近”,也不足以判断任务行为是否相同。
6.3 不同模型家族的恢复与保持权衡
在SNLI-VE上,按家族平均,普通融合模型的缺失模态F1提高3.49个百分点,完整模态F1下降0.09;强编码器融合模型分别为提高1.69、下降0.34;双塔模型为提高1.22、下降0.64;BLIP-2仅提高0.01,完整输入提高0.01。 因此,收益并不均匀。依赖集中于局部交互层的融合模型更适合单层纠正;更分布式的模型结构可能需要不同干预。BLIP-2几乎无收益,尤其提醒我们不能把“编辑开销小”理解成“所有模型都值得编辑”。 评价也不能只看缺失模态分数。系统仍会面对完整输入,修复缺失场景却显著破坏正常场景,可能不符合部署需求。GU的目标是改善这一权衡,而不是在每项任务上都最大化单一指标。
6.4 成本分析
论文区分了编辑阶段和包含参考模型训练的完整离线成本。单独执行GU编辑耗时约230至858秒,比比较中的后训练低秩适配少57%至88%的墙钟时间。但这些比例不包含单模态参考模型训练,不能代表从零开始的总成本。
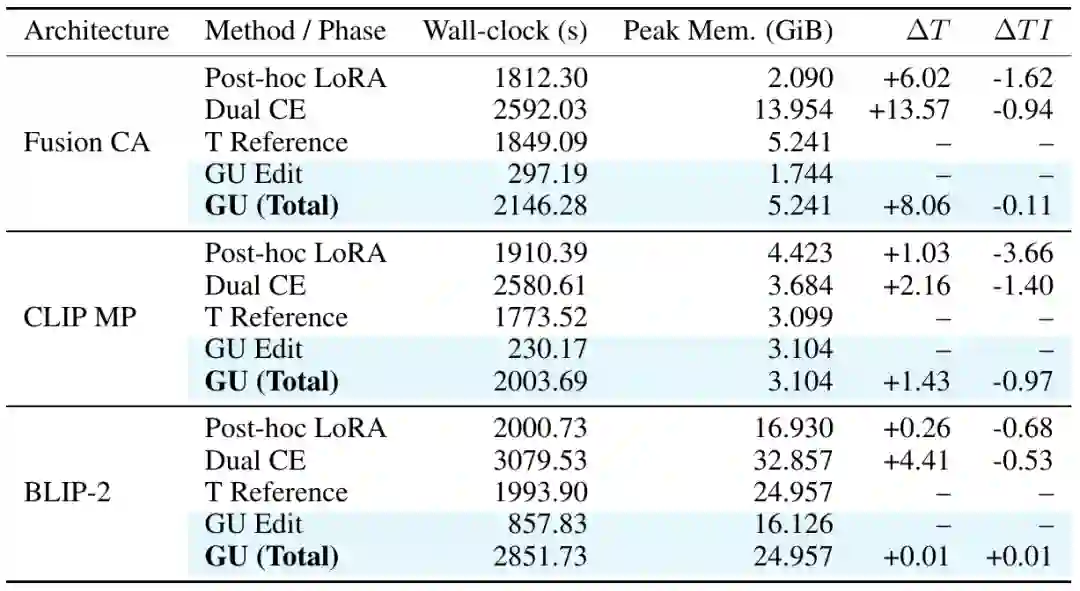
以融合交叉注意力模型为例,参考训练1849.09秒,编辑297.19秒,总计2146.28秒,峰值显存5.241 GiB。GU使缺失模态分数提高8.06个百分点,完整输入下降0.11;后训练低秩适配耗时1812.30秒,对应提高6.02、下降1.62。计入参考训练后,GU总时间反而更长,但完整能力保持更好。 另一种双条件交叉熵训练方案耗时2592.03秒,峰值显存13.954 GiB,缺失模态提升13.57,完整模态下降0.94。它恢复得更多,GU则保留正常场景能力更好。作者报告,完整GU相对该方案节省约7%至22%时间、16%至62%峰值显存;这不是相对所有训练方案的普遍成本优势。 两阶段顺序执行,因此总时间取相加,峰值显存取阶段最大值。编辑不会增加原模型的参数量或前向运算量,但也不等于移除了原图像分支,更不意味着实际硬件延迟在所有实现中都严格一致。
6.5 消融研究
作者比较测地线步长、主子空间秩与目标层。η从0.25到1、k从2到32变化时,结果相对稳定;选哪一层的影响更明显。结论不是参数完全不敏感,而是定位合适的交互层比盲目加大编辑力度更关键。
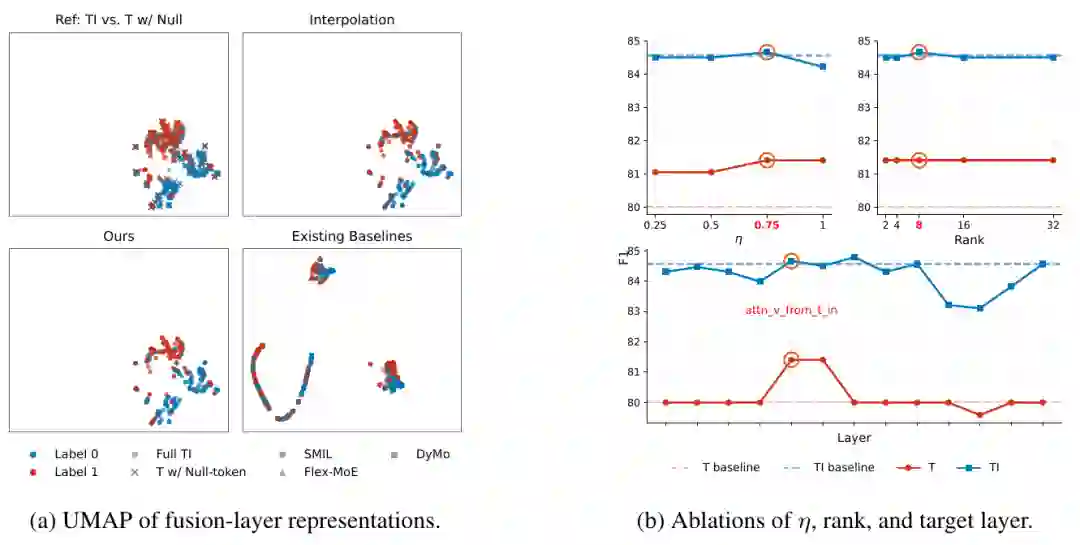
在IU-XRay交叉注意力模型中,仅按主角度选层,缺失模态F1为80.34;仅按表征损害选层为80.72;联合两项信号为81.41。联合选择的完整输入F1为84.44,较原模型仅下降0.13,优于两个单信号选择的保持情况。 路径比较也支持方法设计。在SNLI-VE上,权重插值、线性子空间插值和GU的缺失模态F1分别为67.29、66.84与74.41,而完整输入分别为86.50、86.50与86.53。相同参考方向并不足够,沿什么路径、改变哪些因子,会影响最终的恢复效果。
7 Conclusion|结论
本文把缺失模态问题从“输入不完整”进一步推进到“模型内部形成了怎样的依赖”。其核心发现是:在所测设置中,多模态模型缺失图像后普遍低于匹配文本参考;较大的交互层子空间旋转与较大的退化相关;最终错误样本的任务相关表征偏移在中间交互阶段已经出现。 GU据此提供了一种局部、免原模型梯度更新的后训练纠正方式。它选择单层,沿测地线重对齐主输入子空间,在部分架构上实现明显恢复,同时较好保留完整输入表现。理论给出子空间距离层面的最优性,实验验证任务层面的收益,两者应分开理解。 对部署实践的启示是:不仅要测完整输入,也要单独测试关键模态完全不可用时的行为;不仅要和原模型完整输入比较,也要设立匹配的剩余模态参考;不仅要看恢复分数,也要计算正常场景损失及完整离线成本。多模态可靠性不是“模态越多越好”的简单延伸,而需要明确条件、定位依赖、检验权衡。
附录解读|补充证据与适用边界
任务扩展。 附录在A-OKVQA多项选择问答上报告十次运行的准确率:原模型缺失图像为38.94,GU为41.07,提高2.13个百分点;完整输入从50.79降至47.40,下降3.39。低秩适配的缺失输入准确率更高,为43.52,但完整输入降至45.01。因此,扩展任务支持“恢复—保持权衡”,并不支持“GU始终最优”或“完整能力无损”。该实验也不能直接外推到开放式长文本生成。 缺失文本。 作者还反向测试图像保留、文本缺失的情形。融合交叉注意力模型上,GU使三个主体数据集的图像单独推理F1分别提高1.02、0.84、2.13个百分点,但仍未达到对应图像专门化参考。方法不是仅能处理缺失图像,不过扩展证据仍然有限。 方法限制。 GU需要架构、参数与层级对应的单模态参考,并利用任务开发集诊断和选择目标层,不能称为完全无数据的编辑。单层方法适合局部依赖相对集中的结构,对更分布式的大模型收益可能很小;BLIP-2实验已展示这种情况。当前证据也未覆盖任意多模态组合、规模更大的生成模型或复杂真实部署异常。 应用边界。 仇恨内容识别与医疗影像相关数据集上的性能,不等于偏见消除或临床有效性认证。几何距离改善与分类指标提高,也不能替代真实数据漂移、群体公平性和安全风险的专项测试。 原文入口: 论文摘要与版本记录;完整论文及附录。本文为论文解读,具体实验、证明与实现细节以原文为准。
 Do More Modalities Always Help? A Geometric Perspective on Missing-Modality Robustness


相关内容

 微信扫码咨询专知VIP会员