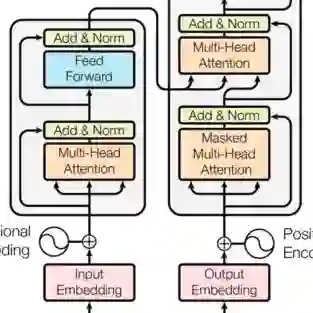
由于硬件资源有限,训练深度学习模型的目标通常是在训练和推理的时间和记忆约束下使准确性最大化。在这种情况下,我们研究了模型大小的影响,重点研究了受计算限制的NLP任务的Transformer模型:自我监督的预训练和高资源机器翻译。我们首先表明,尽管较小的Transformer模型在每次迭代中执行得更快,但是更广泛和更深入的模型在更少的步骤中收敛。此外,这种收敛速度通常超过使用大型模型的额外计算开销。因此,最具计算效率的训练策略是反直觉地训练非常大的模型,但是在少量的迭代之后停止。

这导致大型Transformer 模型的训练效率与小型Transformer 模型的推理效率之间存在明显的权衡。然而,我们证明大型模型比小型模型对量化和剪枝等压缩技术有更强的鲁棒性。因此,我们可以同时利用两个方面的优势:高度压缩的大型模型比轻度压缩的小型模型获得更高的精度。

成为VIP会员查看完整内容
45

相关内容

Transformer是谷歌发表的论文《Attention Is All You Need》提出一种完全基于Attention的翻译架构

知识荟萃

精品入门和进阶教程、论文和代码整理等

更多

查看相关VIP内容、论文、资讯等
[ICML-Google]先宽后窄:对深度薄网络的有效训练
专知会员服务
36+阅读 · 2020年7月5日
【CVPR2020】用多样性最大化克服单样本NAS中的多模型遗忘
【ACL2020-伯克利】预训练Transformer提高分布外鲁棒性
专知会员服务
20+阅读 · 2020年4月14日
【伯克利】再思考 Transformer中的Batch Normalization
专知会员服务
41+阅读 · 2020年3月21日
【Amazon】使用预先训练的Transformer模型进行数据增强
专知会员服务
58+阅读 · 2020年3月6日
深度学习的下一步:Transformer和注意力机制
云头条
56+阅读 · 2019年9月14日
利用神经网络进行序列到序列转换的学习
AI研习社
12+阅读 · 2019年4月26日
Transformer-XL:释放注意力模型的潜力
谷歌开发者
31+阅读 · 2019年2月19日
CMU、谷歌提出Transformer-XL:学习超长上下文关系
机器之心
9+阅读 · 2019年1月18日
Heterogeneous Graph Transformer
Arxiv
27+阅读 · 2020年3月3日
Arxiv
20+阅读 · 2019年9月7日
Arxiv
6+阅读 · 2019年3月19日
Universal Transformers
Arxiv
5+阅读 · 2019年3月5日
Arxiv
11+阅读 · 2018年2月4日
VIP会员
最新内容
世界模型入门:从序贯决策到通用智能体
专知会员服务
8+阅读 · 10月24日
军事域更好使用人工智能的实用指南
专知会员服务
10+阅读 · 10月22日
《衡量语言模型中的作战规划能力》
专知会员服务
14+阅读 · 10月20日
Maven智能系统:帕兰提尔军事人工智能平台详解
专知会员服务
17+阅读 · 10月20日
《测试自动化框架在敏捷软件开发中的角色》
专知会员服务
9+阅读 · 10月20日
俄罗斯如何拦截乌克兰无人机与巡航导弹
专知会员服务
13+阅读 · 10月15日
《武器-目标分配问题:精确与近似求解算法》
专知会员服务
19+阅读 · 10月15日
相关论文
Heterogeneous Graph Transformer
Arxiv
27+阅读 · 2020年3月3日
Arxiv
20+阅读 · 2019年9月7日
Arxiv
6+阅读 · 2019年3月19日
Universal Transformers
Arxiv
5+阅读 · 2019年3月5日
Arxiv
11+阅读 · 2018年2月4日
微信扫码咨询专知VIP会员