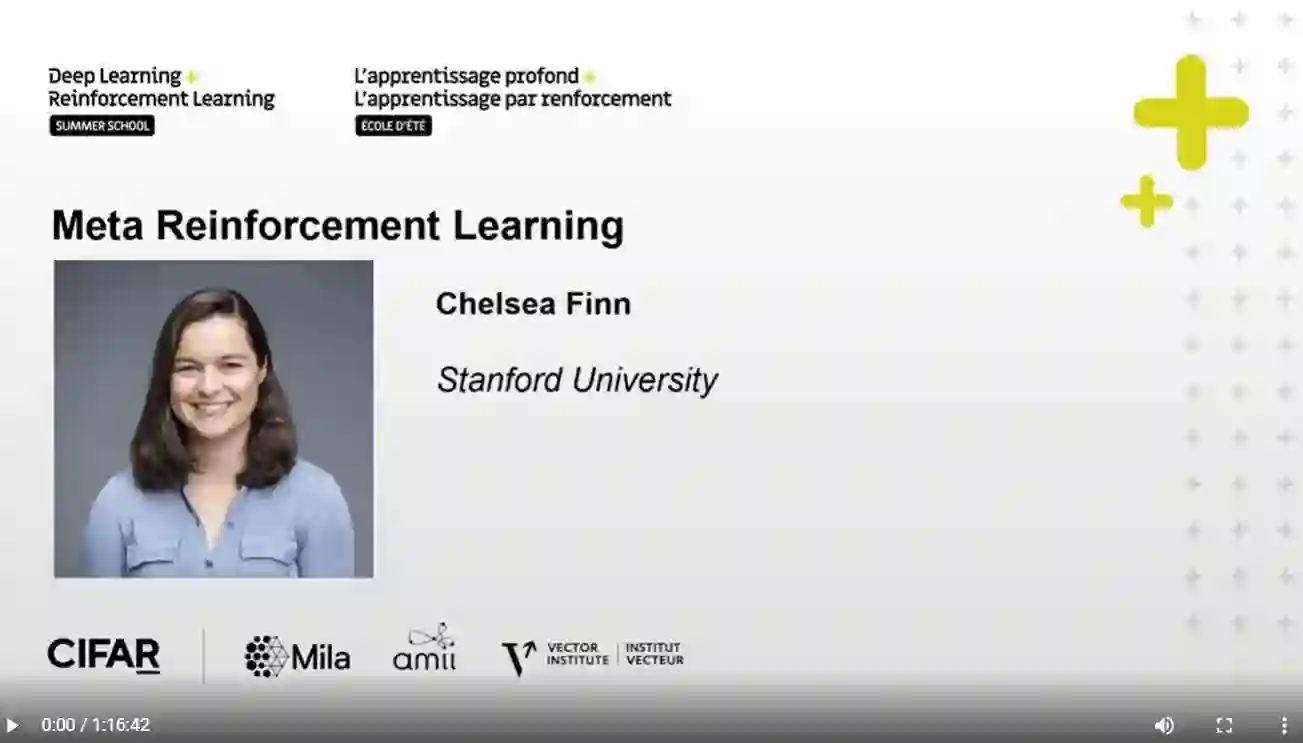
元强化学习算法可以利用以前的经验来学习如何学习,从而使机器人更快地获得新技能。然而,目前关于元强化学习的研究大多集中在非常狭窄的任务分布上。例如,一个常用的元强化学习基准将模拟机器人的不同跑步速度作为不同的任务。当策略在如此狭窄的任务分布上进行元训练时,它们不可能推广到更快地获得全新的任务。因此,如果这些方法的目标是能够更快地获得全新的行为,我们就必须在任务分布上评估它们,任务分布必须足够广泛,以使新行为普遍化。
成为VIP会员查看完整内容
43

相关内容

Meta RL(Meta Reinforcement Learning)是Meta Learning应用到Reinforcement Learning的一个研究方向,核心的想法就是希望AI在学习大量的RL任务中获取足够的先验知识Prior Knowledge然后在面对新的RL任务时能够 学的更快,学的更好,能够自适应新环境!
元学习—Meta Learning的兴起
专知
44+阅读 · 2019年10月19日
DeepMind:用PopArt进行多任务深度强化学习
论智
30+阅读 · 2018年9月14日
一文了解强化学习
AI100
15+阅读 · 2018年8月20日
增强学习算法讲解:马尔可夫决策过程MDP
数据挖掘入门与实战
7+阅读 · 2018年4月22日
Arxiv
1+阅读 · 2021年3月8日
Arxiv
0+阅读 · 2021年3月6日
Arxiv
0+阅读 · 2021年3月4日
Few-shot Learning: A Survey
Arxiv
364+阅读 · 2019年4月10日
Meta-Transfer Learning for Few-Shot Learning
Arxiv
4+阅读 · 2019年4月9日
Relational Deep Reinforcement Learning
Arxiv
10+阅读 · 2018年6月28日
VIP会员
最新内容
世界模型入门:从序贯决策到通用智能体
专知会员服务
8+阅读 · 10月24日
军事域更好使用人工智能的实用指南
专知会员服务
10+阅读 · 10月22日
《衡量语言模型中的作战规划能力》
专知会员服务
14+阅读 · 10月20日
Maven智能系统:帕兰提尔军事人工智能平台详解
专知会员服务
17+阅读 · 10月20日
《测试自动化框架在敏捷软件开发中的角色》
专知会员服务
9+阅读 · 10月20日
俄罗斯如何拦截乌克兰无人机与巡航导弹
专知会员服务
13+阅读 · 10月15日
《武器-目标分配问题:精确与近似求解算法》
专知会员服务
19+阅读 · 10月15日
相关VIP内容
相关论文
Arxiv
1+阅读 · 2021年3月8日
Arxiv
0+阅读 · 2021年3月6日
Arxiv
0+阅读 · 2021年3月4日
Few-shot Learning: A Survey
Arxiv
364+阅读 · 2019年4月10日
Meta-Transfer Learning for Few-Shot Learning
Arxiv
4+阅读 · 2019年4月9日
Relational Deep Reinforcement Learning
Arxiv
10+阅读 · 2018年6月28日
微信扫码咨询专知VIP会员