
主题: Representations for Stable Off-Policy Reinforcement Learning

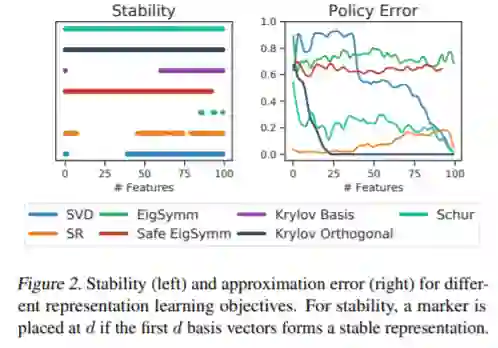
摘要: 具有函数逼近的强化学习可能不稳定,甚至会产生分歧,尤其是与非策略学习和Bellman更新结合使用时。在深度强化学习中,这些问题已通过调整和规范化表示形式(特别是辅助任务)以经验方式得到处理。这表明表示学习可以提供一种保证稳定性的方法。在本文中,我们正式表明,即使在学习非策略时,确实存在非平凡的状态表示形式,规范的TD算法是稳定的。我们沿着三个轴分析基于策略过渡矩阵(例如原型值函数)的表示学习方案:逼近误差,稳定性和易于估计性。在最一般的情况下,我们表明Schur基提供了收敛性保证,但是很难从样本中进行估计。对于固定的奖励函数,我们发现相应Krylov子空间的正交基础是更好的选择。我们通过经验证明,可以使用随机梯度下降学习这些稳定的表示,从而为使用深度网络进行表示学习的改进技术打开了大门。
成为VIP会员查看完整内容
17

相关内容

【斯坦福大学】Gradient Surgery for Multi-Task Learning
专知会员服务
47+阅读 · 2020年1月23日
强化学习扫盲贴:从Q-learning到DQN
夕小瑶的卖萌屋
52+阅读 · 2019年10月13日
DeepMind:用PopArt进行多任务深度强化学习
论智
30+阅读 · 2018年9月14日
Hierarchical Imitation - Reinforcement Learning
CreateAMind
19+阅读 · 2018年5月25日
Representation Learning on Network 网络表示学习
全球人工智能
10+阅读 · 2017年10月19日
Representation Learning on Network 网络表示学习笔记
全球人工智能
5+阅读 · 2017年9月30日
Arxiv
35+阅读 · 2020年1月2日
Logically-Constrained Reinforcement Learning
Arxiv
3+阅读 · 2018年12月6日
Arxiv
11+阅读 · 2018年4月25日
Arxiv
25+阅读 · 2018年1月24日
VIP会员
最新内容
世界模型入门:从序贯决策到通用智能体
专知会员服务
4+阅读 · 10月24日
军事域更好使用人工智能的实用指南
专知会员服务
9+阅读 · 10月22日
《衡量语言模型中的作战规划能力》
专知会员服务
14+阅读 · 10月20日
Maven智能系统:帕兰提尔军事人工智能平台详解
专知会员服务
16+阅读 · 10月20日
《测试自动化框架在敏捷软件开发中的角色》
专知会员服务
8+阅读 · 10月20日
俄罗斯如何拦截乌克兰无人机与巡航导弹
专知会员服务
12+阅读 · 10月15日
《武器-目标分配问题:精确与近似求解算法》
专知会员服务
17+阅读 · 10月15日
相关VIP内容
相关资讯
相关论文
微信扫码咨询专知VIP会员


