
**
**
ACL 2026 杰出论文奖 | PALU:在关键前缀上最大化局部熵,让大模型精准“失忆”
导读
大语言模型在海量语料上进行训练,也不可避免地记住了其中的隐私信息、版权内容和其他敏感知识。当数据所有者要求删除相关信息时,重新收集数据并从头训练模型通常成本高昂。因此,如何在不重新训练模型的情况下,消除指定数据对模型行为的影响,成为大模型安全与隐私研究中的重要问题。 这类技术通常被称为大语言模型遗忘学习(LLM Unlearning)。理想的遗忘方法需要同时满足两个目标:一方面,模型不再生成与目标数据相关的内容;另一方面,模型原有的语言理解和生成能力应当尽可能保持不变。 然而,现有方法往往通过对完整回答进行负向优化,或者在整个词表上提高预测不确定性。这种“全序列、全词表”的干预方式虽然能够削弱目标知识,却也会更新大量与敏感信息无关的内容,容易造成模型能力下降和训练资源浪费。 针对这一问题,中国科学技术大学与新加坡国立大学的研究团队提出了 PALU(Prefix-Aware Localized Unlearning,前缀感知局部遗忘)。该工作从生成过程的时序维度和词表维度同时引入局部化约束,只对真正决定敏感内容生成的少量位置进行干预。
论文信息
**论文题目:**Maximizing Local Entropy Where It Matters: Prefix-Aware Localized LLM Unlearning **论文链接:**https://arxiv.org/abs/2601.03190 **会议:**ACL 2026 **作者:**Naixin Zhai, Pengyang Shao, Binbin Zheng, Yonghui Yang, Fei Shen, Long Bai, Xun Yang **代码:**https://github.com/nxZhai/PALU **关键词:**LLM Unlearning, Machine Unlearning, Sensitive Knowledge Removal, Localized Optimization
1. 大模型遗忘,真的需要修改整个回答吗?
**
**
目前许多梯度式大模型遗忘方法都建立在负交叉熵目标之上。模型正常训练时,会最小化交叉熵损失,提高正确目标词元的生成概率;而在执行遗忘时,Gradient Ascent、NPO等方法反向操作,通过降低目标回答的生成概率,使模型逐渐“不再相信”原来的答案。这一思路直观,但存在两个问题。 **第一个问题是,降低目标词元的概率,并不等价于让模型真正变得不确定。**假设模型原本会以很高概率生成一个敏感实体。负交叉熵目标只负责压低该实体对应词元的概率,却无法控制被压低的概率质量流向哪里。模型可能只是将概率转移到另一个同义词、相关实体或者语义相近的表达上。换言之,模型忘掉的可能只是某一种表述,而没有忘掉背后的语义概念。 **第二个问题是,现有方法的干预范围通常过大。一个包含敏感知识的回答中,并不是所有词元都属于敏感信息。**大量介词、冠词、连接词以及句式成分只承担一般性的语言组织功能。如果在完整回答上执行负向优化,这些通用词元也会被一并更新,从而损害模型的语言流畅性和通用能力。类似地,在词表维度上,下一词元生成通常只由少数高概率候选主导。对数万甚至十余万个长尾词元同时进行优化,对最终解码行为的影响很小,却会引入额外计算和参数扰动。 PALU由此提出一个核心问题: 为了切断敏感内容的生成路径,我们究竟需要干预多少词元、多少词表维度?
**
**
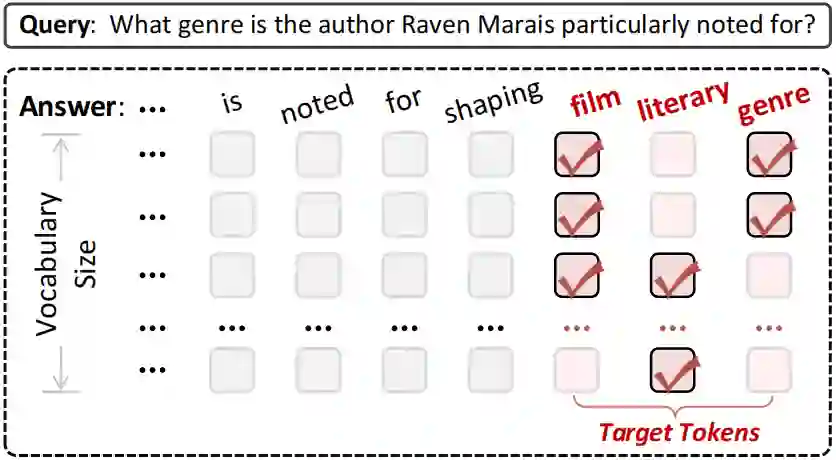
图1 局部优化示意图 图1直观展示了PALU的基本思想:在序列维度上只选择敏感词元,在每个敏感位置上又只优化Top-K高概率候选,而跳过无关词元和长尾词表维度。
2. PALU的核心发现:敏感生成具有“双重稀疏性”
**
**
PALU 重新从干预效率的角度理解大模型遗忘。对于一个输入问题 x 和敏感回答 y,遗忘的本质并不一定是破坏回答中的所有词元,而是打断模型从问题到敏感回答的生成轨迹。研究团队发现,这一生成轨迹同时具有时序稀疏性和词表稀疏性。
时序稀疏性:切断敏感前缀即可改变后续生成
**
**
大语言模型采用自回归方式逐词生成文本。每个新词元都会以前面已经生成的内容作为条件。 因此,在敏感实体或敏感事实开始出现时,前几个词元往往承担着“启动语义”的作用。一旦这些起始词元发生变化,后续生成过程也会随之偏离原来的轨迹。 例如,在生成一个人物姓名时,模型一旦在姓氏或名称前缀处选择了不同词元,后续名字、身份和背景描述通常都会发生改变。 PALU 将敏感片段中的词元进一步划分为三类: 1. 起始目标词元(Initiating Targets):敏感片段最前面的若干词元,是主要遗忘对象; 1. 通用词元(Common Tokens):与敏感知识无关,通过KL散度约束维持原有分布; 1. 冗余敏感词元(Redundant Sensitive Tokens):位于敏感片段后部,但不再参与遗忘优化。
这意味着,PALU 并不需要优化整个敏感实体,更不需要优化完整回答,只需干预每个敏感片段最前面的 N 个词元。
词表稀疏性:真正影响解码的只是Top-K候选
**
**
在词表维度上,模型虽然会为整个词表计算概率,但实际生成决策主要由概率最高的一小部分候选决定。长尾词元的概率本身已经很低。即使继续对它们进行熵最大化,也很难改变最终生成结果。因此,PALU 只在冻结参考模型选出的 Top-K logit 上执行局部熵最大化,而不要求整个词表分布趋于均匀。时序维度上的敏感前缀,与词表维度上的 Top-K 候选,共同构成了 PALU 的“双重局部化”设计。
3. 方法设计:在真正重要的位置最大化局部熵
**
**
PALU的整体流程可以概括为三个步骤:首先识别回答中的敏感内容;随后定位敏感片段的起始词元,并在这些关键位置上执行局部熵最大化;最后在非敏感词元上约束模型保持原有预测分布,从而减少遗忘过程对通用能力的影响。
识别回答中的敏感片段
**
**
首先,PALU 需要判断回答中的哪些部分真正包含待遗忘的信息。在一段包含敏感知识的回答中,并不是所有词元都与目标知识直接相关。例如,一个回答可能同时包含人物姓名、身份描述以及大量连接词、介词和通用句式。传统方法通常会对完整回答进行负向优化,从而将这些与敏感知识无关的语言成分一并修改。 PALU 则首先借助语言模型或人工标注识别回答中的敏感跨度,将每个词元划分为敏感词元和通用词元。具体实现中,论文使用 GPT-4o 模型辅助识别敏感片段,并沿用已有的目标词元标注协议进行人工复核。最终,两个实验数据集上的敏感跨度识别准确率均超过98%。 在获得完整的敏感片段后,PALU并不会对其中所有词元进行遗忘,而是进一步选取每个敏感片段最前面的少量词元,将其作为真正需要干预的“起始目标”。其余位于敏感片段后部的词元不参与遗忘优化。原因在于,自回归语言模型的后续输出依赖前面已经生成的内容。一旦敏感片段的生成入口被改变,后续内容通常也会随之偏离原始轨迹。
在Top-K候选上执行局部熵最大化
**
**
确定敏感片段的起始位置后,PALU进一步考虑应该干预词表中的哪些候选词元。大语言模型在每个生成位置上都会为整个词表计算预测分数,但真正影响下一词元选择的,通常只是概率最高的一小部分候选。大量长尾词元的概率本身已经非常低,即使继续调整这些词元,也很难改变最终生成结果。 因此,PALU首先使用冻结的参考模型,找出当前敏感位置上概率最高的Top-K候选词元。随后,方法只对这些高概率候选执行局部熵最大化,使它们之间的预测分数更加接近。这一过程可以理解为:模型原本可能对某个敏感词元表现出极高置信度,PALU则主动削弱这种过度集中的偏好,使模型无法明确决定应该生成哪一个候选。与仅压低目标词元概率的方法相比,Top-K局部熵最大化不仅能够抑制原始答案,还能够同时覆盖同义词、相关实体和语义相近的替代表达,避免模型将概率简单转移到另一个敏感候选上。 与此同时,PALU不会要求整个词表都达到均匀分布,而只处理真正影响解码结果的关键候选。这既保留了原有词表结构,也减少了无效优化带来的计算开销和参数扰动。
保护模型的通用语言能力
**
**
仅在敏感位置执行遗忘仍然可能使模型的整体预测分布发生偏移。为了避免模型在遗忘目标知识的同时损害正常语言能力,PALU还引入了保留约束。对于回答中的非敏感词元,PALU要求遗忘后的模型尽量保持与原始参考模型一致的预测分布。 换言之,敏感位置负责“忘记”,通用位置负责“保持”。这种设计将遗忘目标和能力保护目标明确分离:在敏感片段的起始词元上,模型通过局部熵最大化降低对敏感内容的确定性;在普通词元位置上,模型则通过分布约束维持原有语言知识和生成能力。从优化范围来看,传统方法通常需要处理完整回答中的全部词元,并在每个位置上干预整个词表。PALU 则只在少量敏感前缀位置上处理Top-K高概率候选,大幅缩小了实际需要更新的范围。 因此,PALU 的核心并不是简单地降低遗忘强度,而是将有限的优化集中到真正决定敏感内容生成的位置上,实现更加精准和高效的模型遗忘。
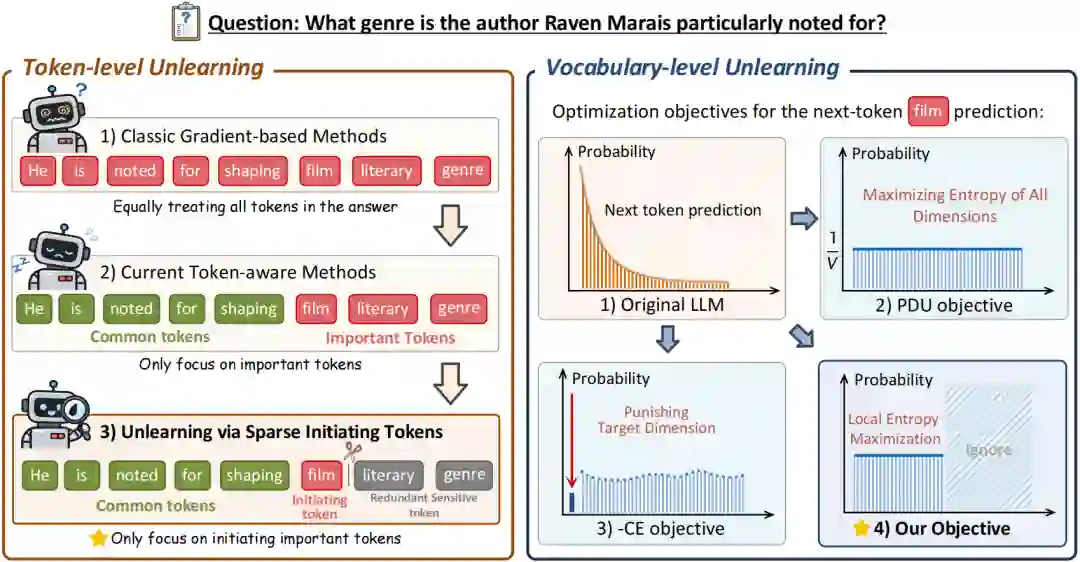
图2 PALU双重局部化对比图 该图可以直观展示PALU在两个维度上的局部化设计:在序列维度上,只选择敏感片段的起始词元;在词表维度上,只优化概率最高的Top-K候选。同时,非敏感词元通过分布约束维持模型原有能力。
4. 实验设置
**
**
研究团队在两个互补的大模型遗忘基准上开展实验。第一个是 TOFU。该数据集包含200名虚构作者及其问答信息,并设置了1%、5%和10%三种遗忘比例,适合细粒度分析模型对指定事实的遗忘程度。第二个是 MUSE。该数据集包含News和Books两个真实文本场景,重点考察模型的逐字记忆、知识记忆和隐私泄露风险。实验使用 Llama-2-7B 和 Llama-3.1-8B 作为主要骨干模型,并与 GA、GD、DPO、NPO、SimNPO、PDU 和 TPO 等方法进行比较。
5. 实验结果:遗忘效果和模型效用能否兼得?
**
**
PALU取得更好的遗忘—效用平衡
**
**
在 TOFU 的 5% 遗忘设置上,PALU 在 Llama-2-7B 和 Llama-3.1-8B 上均取得了最高的 Forget Quality。在 Llama-2-7B 上, PALU 的 FQ 达到 0.7126,相比 TPO 的 0.6284 提升约 13.4%;其 MU 达到 0.6238,接近仅使用保留数据训练得到的理想 Retain模型 0.6266。在 Llama-3.1-8B 上,PALU 的 FQ 达到 0.9238,而 TPO 为 0.7216,相对提升约 28.0%。与此同时,PALU 仍然保持了 0.6162 的 MU。这一结果说明,PALU 并不是通过大幅破坏模型能力来实现遗忘,而是在尽量保留通用能力的同时,使模型行为接近“从未学习过目标数据”的理想状态。
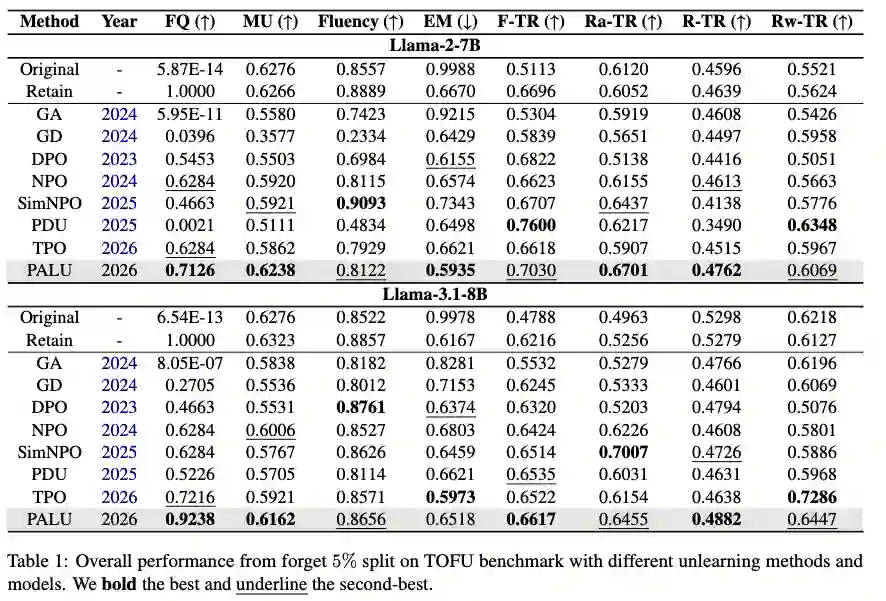
表1 TOFU 5%设置总体实验结果
在不同遗忘比例下保持稳定
**
**
论文进一步在 TOFU 的 1% 和 10% 遗忘设置上比较不同方法。从 FQ 与 MU 的二维分布来看,PALU在不同模型和遗忘比例下都更接近Retain模型。特别是在更具挑战性的 10% 遗忘设置中,NPO、DPO等方法的模型效用或遗忘质量出现明显下降,而PALU仍能维持较稳定的平衡。
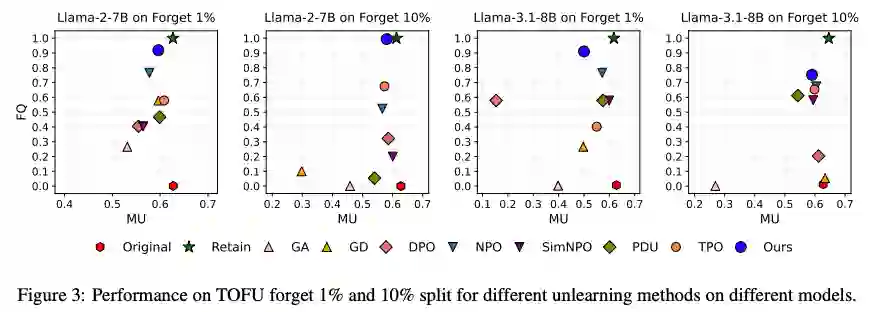
图3 不同遗忘比例下 FQ 与 MU 关系图 6. 为什么“少改一点”反而效果更好?
**
**
Top-1并不足以实现稳定遗忘
**
**
当PALU只优化概率最高的一个候选,即 K=1 时,模型效用出现严重下降。 其原因在于,大语言模型的语义表达具有明显冗余性。压低一个词元后,概率可以迅速转移到同义词或相关候选,迫使优化过程不断进行更激烈的参数更新。随着 K 增大,模型表现快速恢复,并在 K=5000 左右趋于饱和。继续扩大到完整词表并没有带来明显的遗忘收益。这一现象说明,稳定遗忘既不能只压制Top-1,也没有必要处理完整词表。覆盖主要语义候选的关键子空间已经足够。
前缀敏感词元基本足以切断生成路径
**
**
在时序维度上,仅处理一个词元仍然过于激进,难以稳定改变敏感生成轨迹。当起始预算增加到 N=3 时,FQ 和 MU 基本达到稳定。继续扩大到四个词元乃至整个敏感片段,没有获得明显额外收益,反而增加了计算和能力损伤风险。
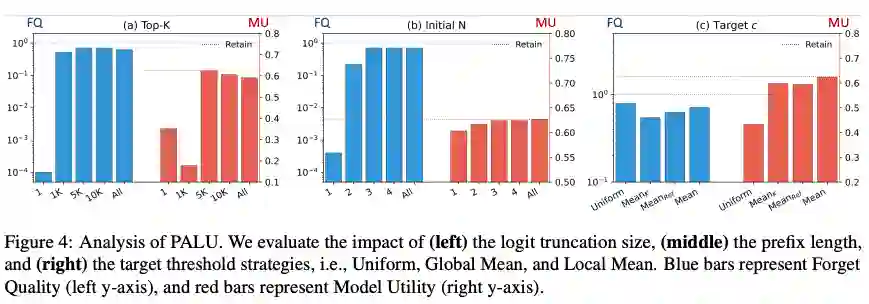
图4 Top-K、Initial-N及目标值c的消融实验
全局均值是更稳定的logit目标
**
**
PALU还比较了均匀分布、Top-K均值、参考模型全局均值和当前模型全局均值等不同目标值。实验发现,直接强制整个局部概率分布达到严格均匀状态约束过强,会破坏logit原有的结构。相比之下,将Top-K敏感峰值拉向稳定的全局均值,可以将敏感信号“埋入”模型的背景分布,同时避免显著扭曲整体概率流形。因此,论文最终采用全局均值作为标准目标值。
7. PALU不仅遗忘得更好,收敛也更快
**
**
在训练效率方面,PALU 与 NPO 呈现出明显不同的收敛行为。PALU的模型效用在约两个 epoch 内快速恢复,Forget Quality 在第五个 epoch 左右趋于稳定。相比之下,NPO 存在较明显的预热阶段,需要接近两倍的迭代次数才能达到较高的遗忘质量。这意味着,除了减少词元和词表维度上的梯度范围外,PALU 还能够通过更明确的优化目标缩短训练周期。
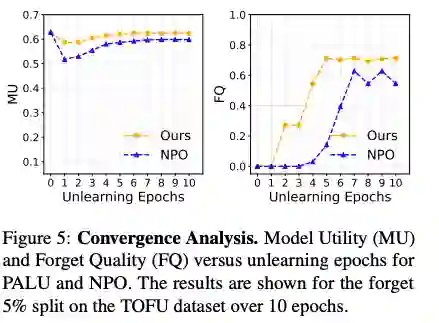
图5 PALU 与 NPO 的收敛曲线 8. 总结与展望
**
**
PALU给出了一个简洁但重要的结论:
有效的大模型遗忘,并不需要在所有位置制造混乱,而应当在真正决定敏感内容生成的位置制造不确定性。
**
**
在时序维度上,PALU只干预敏感片段最前面的少量词元,通过改变生成入口切断后续敏感轨迹。在词表维度上,PALU只平坦化Top-K高概率候选,防止目标概率简单转移到同义词或相关表达,同时保留长尾词元和通用语言结构。 这种“双重局部化”使PALU取得了更好的遗忘质量与模型效用平衡,并表现出更快的训练收敛速度和更强的成员推断攻击防御能力。从更广泛的角度看,该工作也提示我们:大模型行为控制不一定需要大范围参数破坏。通过分析自回归生成中的因果起点和解码关键子空间,可以用更小、更有针对性的干预改变模型行为。 目前,PALU主要针对纯文本大语言模型。对于多模态模型,视觉patch序列中是否存在类似的“敏感前缀”、跨模态词表中的关键候选应当如何定义,仍有待进一步研究。
 Maximizing Local Entropy Where It Matters: Prefix-Aware Localized LLM Unlearning


9月14日,美国空军部长特洛伊·迈因克公开宣布,为应对美国及其盟国太空系统所谓面临的日益增长威胁,美国太空军已部署“太空控制武器”。
这一宣布引发了其他国家的可预见批评,它们指责华盛顿正在加速太空军备竞赛。太空竞争并非始于此次宣布。
乌克兰和中东的战争表明为何这至关重要。太空已不再仅仅是一个支援领域。卫星通信、导航、以及其他天基服务正日益塑造陆战场上的态势。
教训应当明确:在未来的地区冲突中,地球上的军事优势将日益取决于在太空中的行动能力——以及制胜能力。
西方对天基战争垄断的终结
1991年的海湾战争可以说是第一场主要的太空战争。全球定位系统(GPS)、卫星通信和天基情报为美国及其盟国在精确打击、导航以及指挥与控制方面提供了非凡优势。
但战略环境已发生根本性改变。
其他大国花费数十年发展了一套广泛的反太空能力,包括直接上升式反卫星导弹、电子战系统、网络能力、定向能武器以及具备交会逼近操作能力的卫星。
美国及其盟国在太空军事效益方面不再拥有任何形式的垄断。
乌克兰和中东的战争表明,日益复杂的天基能力不仅正变得可为大国所用,也可为较小国家——并可能为非国家行为体——所用。
这对印太地区具有巨大影响。
商业太空改变了军事韧性
乌克兰战争最重要的教训之一,是商业太空在遭受攻击时维护军事效能方面可发挥的作用。
2022年俄罗斯乌克兰战争初期,莫斯科试图破坏乌克兰的通信和指挥控制网络。然而,乌克兰能够保持关键连通性,这在很大程度上得益于“星链”的扩散式低地球轨道卫星架构。
数千个终端提供的通信远比传统地面网络更难摧毁。“星链”并未决定战争结局,但它帮助阻止了俄罗斯实现其最重要的初期目标之一:切断乌克兰有组织防御所需的通信。
这一教训在印太地区应引起强烈共鸣。
在重大地区冲突中,机场、港口、指挥中心和通信节点几乎肯定会遭到攻击。当地面基础设施受损或中断时,扩散式商业卫星通信可提供至关重要的冗余。
但各国政府不能简单地假定这些商业能力在需要时就能获得。它们需要在危机开始前就建立合同安排、技术整合和作战概念。
导航既是一种优势,也是一种脆弱性
第二个教训涉及定位、导航与授时。
全球导航卫星系统——美国的全球定位系统、欧盟的“伽利略”、俄罗斯的“格洛纳斯”和中国的“北斗”——现在支持的远不止导航。它们赋能精确制导武器、无人机、分散的军事行动、通信网络以及日益复杂的无人系统。
乌克兰和俄罗斯都严重依赖卫星导航来引导导弹和无人机。中东冲突同样展示了曾集中于少数技术先进国家手中的精确打击能力的扩散。
与此同时,依赖也创造了脆弱性。
这两场冲突中都出现了广泛的干扰和欺骗。针对卫星导航的电子战可扰乱导弹和无人机,干扰后勤和指挥网络,并为民用航空和海上交通制造重大风险。
印太地区可能面临规模更大的此类挑战。
部队不仅需要更具韧性的卫星导航系统接入,还需要定位、导航与授时的替代来源,以及在卫星信号降级或被拒止时行动的能力。
战场正变得透明
商业卫星的扩散带来了另一个深刻变化。
曾专属于政府和情报机构的高质量天基影像,如今可商业采购。这为国家及其军队提供了非凡益处,但对手也可利用这些相同服务。
商业系统可揭示飞机移动、港口活动、部队部署、后勤枢纽以及前沿基地的活动。
对印太地区而言,这意味着主要军事基地日益被视为可观测目标。
答案不是放弃这些设施,而是重新思考部队如何从中行动。分散、机动、欺骗、隐蔽、加固基础设施和作战安全将变得日益重要。
认为弱势对手缺乏复杂天基情报的旧假设正变得过时。
必须能够阻止对手利用太空
这些发展指向一个艰难但不可避免的结论。
仅保护卫星已不再足够。
如果对手利用太空系统来定位部队、引导导弹、操作无人机或维持军事通信,必须能够在必要时阻止其有效军事利用这些能力。
这并非自动意味着物理摧毁卫星。
实际上,首选工具应尽可能是有针对性的、可逆的,并旨在避免产生长寿轨道碎片。电子战、网络能力和其他非破坏性手段往往比动能反卫星武器更可取。
美国空军部长特洛伊·迈因克的宣布应在此背景下理解。
太空控制并非为了太空冲突本身而追求冲突。它是认识到对手的太空能力可直接影响地球上的军事行动。
对印太而言,太空因此需要成为联合作战规划中更为重要的组成部分。
美国在印太地区的新战略构想
由此产生若干优先事项。
首先,应继续建设更具韧性和分布式的太空架构,同时将商业系统更深入地整合到军事规划中。
其次,应增强定位、导航与授时韧性,包括全球定位系统的替代方案以及在干扰和欺骗下行动的能力。
第三,需要更好的机制,以便在危机期间共享太空态势感知和商业卫星数据。
第四,应发展可信的——不产生碎片的——手段,以在敌对太空服务和天基信息被用于攻击部队时,阻止对手获取这些服务。
第五,应继续外交,以减少最危险的反太空竞争形式——特别是产生碎片的反卫星试验以及在轨道上部署核武器。
据报道俄罗斯正在开发核反卫星能力,这凸显了其中的利害。太空中的核爆不仅威胁军事卫星。它还可能 不加区别地损坏通信、交通、金融和现代经济所依赖的商业和民用系统。
印太的下一个战场延伸至轨道
乌克兰和中东带来的更广泛教训是,太空正变得与地球战争不可分割。
当地面网络遭攻击后,商业星座可维持通信。卫星导航赋能无人机和精确武器。商业影像使战场日益透明。而这些相同能力现在也可为对手所用。
这不是一场遥远的科技辩论。未来的印太冲突几乎肯定会涉及试图破坏、操纵或拒止盟国军事力量所依赖的太空服务。
最快适应这一现实的国家将占据重要优势。
1991年的海湾战争展示了太空如何改变战争。乌克兰和中东正在展示不同的东西:天基战争已经扩散。
不能再假定太空准入将得到保证——或它们的军事优势将独享。
在下一场重大冲突中,对陆战场的控制可能日益取决于保护、利用以及在必要时争夺太空领域的能力。
未来战争不会完全由机器人主导。诚然,在速度、耐力、距离、精度或物理危险等因素压倒性倾向于使用机器的战场环境中,人员将逐渐消失。但在战争需要情境判断、直觉、与平民互动以及对生死决策负责的情况下,人类仍不可或缺。
人工智能与自主系统快速渗透至战争的态势,已在乌克兰和中东战场上显现。两股强大力量正加速这一趋势。
首先,人工智能、传感器、机器人技术、通信和计算能力的进步,使自主系统能够执行仅仅十年前还需要训练有素的人类操作员才能完成的任务。如今,数千架无人机正在执行侦察和打击任务。自主艇巡逻海岸线并攻击敌方船只与港口设施。地面机器人运送补给并清除雷场。人工智能以人类参谋无法企及的速度分析情报。
其次,在发达世界的大部分地区,民主社会对接受军事伤亡的意愿日益降低。政治领导人面临越来越大的公众压力,要求进行“零地面部队”行动。自主系统使政府能够在不付出伤亡攀升的政治代价的情况下维持军事行动。
观察这些趋势,人们很容易得出人类士兵时代即将终结的结论。
然而,这一结论为时过早。
太空战已经变得主要依赖自主系统。卫星持续探测威胁、相互协调,并在有限人为干预下处理海量数据。未来的太空战将要求决策速度远超人类反应极限。然而,人类仍需控制太空行动,在关键时刻介入以防止灾难性后果,并决定是否发动攻击或反击。
空战紧随其后。至少在今后几十年内,人工智能更可能重新定义飞行员的角色,而非完全取代有人驾驶战斗机。随着无人机蜂群变得更快、更廉价且能力更强,未来的战斗机飞行员花在亲自与敌机格斗上的时间可能减少。相反,他们可能花更多时间指挥执行侦察、电子战、压制敌方防空、诱饵作战和精确打击的自主飞机编队。飞行员日益成为战场管理者,而非孤身一空战勇士。无人机也将取代部分直升机任务,但对于复杂任务——如在城市环境中进行低空空中火力支援(一次失误便可能伤及友军或平民)——人类飞行员仍不可或缺。
海战可能遵循类似路径。海洋天然适合自主系统:水面和水下航行器可在不使水兵暴露于危险的情况下连续数月执行任务。它们已日益熟练地执行监视、扫雷、反潜和情报任务。随着传感器、通信和人工智能的改进,自主海上航行器编队最终可能取代体积更大、成本更高的有人战舰。尽管如此,对于复杂任务——如在国际水域搜查商船,或执行两栖登陆并建立滩头阵地——仍需要有人驾驶舰艇。
地面战则呈现截然不同的挑战。开阔地形有利于机器。自主车辆可运送补给、后送伤员、探测地雷,并以日益增强的有效性打击装甲编队。
但现代战场很少类似开阔沙漠或空旷平原。
现代战争日益在密集城市环境、森林、山地和地下隧道网络中展开——这些环境对自主系统极为不利。卫星导航信号可能缺失,通信不可靠,能见度严重受限,地图迅速过时。每一扇门、每一段楼梯、每一个隧道交叉口或坍塌建筑都可能隐藏着新的战术意外。
更重要的是,现代战争日益模糊战斗人员与平民的界限。区分携带杂货的平民与藏匿炸药的恐怖分子,需要的不仅是先进传感器或模式识别算法。它要求情境理解、文化意识、伦理判断,以及对可能决定无辜者生死的决策承担法律责任。
人类必须完成这项任务。
人工智能无疑会进步,自主地面系统将承担越来越多的军事任务份额。但现代军队日益作战的环境,仍然青睐机器难以复制的特质:适应性、直觉、道德判断以及解读模糊人类行为的能力。
因此,在可预见的未来,问题不太可能是机器人是否会取代士兵,而是士兵与智能机器将如何并肩作战,以及军队应如何重新设计其力量结构,以最大限度地发挥各自优势。
https://www.aspistrategist.org.au/not-only-robots-warfare-will-still-need-humans/
美国国防部(DoD)日益依赖非传统国防承包商、风险投资支持的初创企业、两用技术公司、研究型大学以及商业创新生态系统来开发事关国家安全的能力。然而,由于接触机密空间的途径有限,参与机密项目仍受到制约。尽管创新活动已扩展至传统国防中心之外,但机密基础设施仍集中在传统的政府和防务工业所在地周围。因此,许多拥有事关国家安全技术的企业缺乏实际途径来获取参与机密工作所需的安全设施。
认识到这一挑战,美国国会向国防创新单元(DIU)拨款1.45亿美元,以扩大机密基础设施容量并探索“机密基础设施即服务”(CIaaS)解决方案。本论文通过识别未来对共享机密基础设施需求最有可能涌现的地理区域,以及未来机密空间投资可能提供最大战略价值的地方,来支持这一努力。
一个核心挑战在于,目前不存在衡量当前或未来对共享机密工作空间需求的综合数据集。因此,本研究基于创新集群理论和区域经济发展研究的代理指标来估算未来需求。数十年的研究表明,创新在美国并非随机分布。相反,创新活动往往通过集聚效应、知识溢出、劳动力流动、风险投资集中和组织衍生等机制在地理上趋于集中。企业频繁从现有技术领域中涌现,成功的创新生态系统通过人才、创意和资本的流动实现自我复制。以下四项发现为本研究选定的数据集提供了理论基础。
首先,使用了风险投资(VC)投资数据,因为风险投资公司将资源集中在预计会产生未来高增长企业的地区。因此,风险投资可作为未来初创企业形成和技术商业化最有可能发生的区域的指标。其次,纳入了“国家安全100强”和“美国活力”企业,因为它们代表了已在商业创新与国家安全交叉领域运营的现有公司。关于组织繁衍和产业集群的研究表明,成功的企业经常催生由前员工创立的衍生公司。因此,这些企业是未来防务相关初创企业可能涌现区域的领先指标。第三,纳入了大型科技公司的所在地,因为大型科技公司是区域创新生态系统的锚点。研究表明,大型公司产生知识溢出,吸引专业化劳动力,并创造支持创业和新公司形成的条件。员工频繁离开成熟的科技公司去创建新企业,通常仍留在同一地理区域内。最后,纳入了“小企业创新研究”(SBIR)奖项,因为它们代表了防务相关技术知识已经产生的地点。SBIR资金证明联邦资源已经为在特定地理区域开发防务相关专业能力作出了贡献。尽管SBIR活动本质上是回顾性的,但它提供了可能支持未来机密工作的技术能力积累的重要指标。
综合来看,这四个数据集代表了未来创新潜力的不同维度。风险投资反映了融资生态系统,“国家安全”和“美国活力”企业代表了防务相关的创业活动,大型科技公司代表了未来衍生企业和知识溢出的来源,而SBIR奖项则代表了现有防务相关技术知识的集中地。本论文并非试图直接衡量当前的机密空间需求,而是基于历史上产生创新集群的地理驱动因素,估算未来机密基础设施需求最有可能涌现的地点。
为评估这些地点,本研究对来自四个数据集的大约6600个观测值应用了加权空间凝聚聚类。聚类形成基于地理邻近性和加权来源关系。由于数据集规模差异很大,采用了来源归一化技术,以防止任何单一来源——尤其是较大的SBIR数据集——主导结果。随后,使用随机生成的权重组合进行了5000次蒙特卡洛分析,以评估候选地点在广泛合理政策优先级下的稳健性。
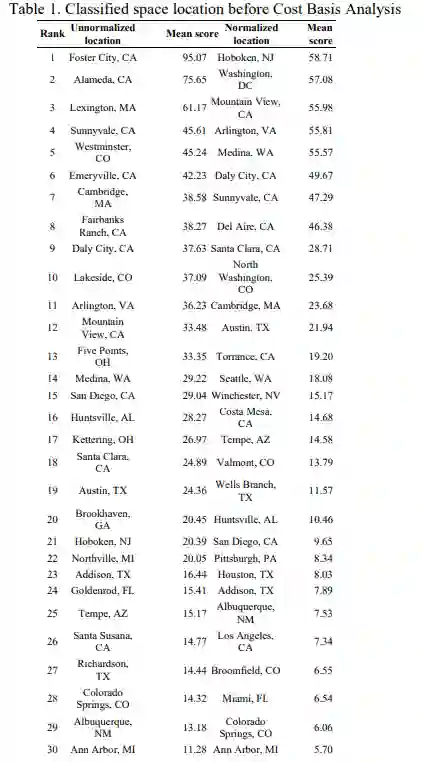
结果表明,归一化实质性地改变了决策空间。在没有归一化的情况下,大型数据集不成比例地影响了结果。归一化后,模型生成了在多种加权结构下持续出现的地点的更平衡表征。有几个地点在平均分、出现率和基于排名的衡量指标上表现强劲,包括华盛顿州梅迪纳、新泽西州霍博肯、加利福尼亚州山景城、弗吉尼亚州阿灵顿、华盛顿特区、加利福尼亚州戴利城和加利福尼亚州德尔艾尔。
随后,研究纳入了国防部区域成本系数(ACF),以估算在1.45亿美元固定预算下可交付的机密空间数量。该分析揭示了需求强度与建设购买力之间的显著权衡。高需求地区,如加利福尼亚州湾区和新泽西州北部,显示出强劲的创新信号,但面临显著的成本惩罚。低成本地区,如阿拉巴马州亨茨维尔、得克萨斯州奥斯汀、新墨西哥州阿尔伯克基和亚利桑那州坦佩,可交付显著更大的设施容量,但总体上需求信号较弱。
当综合评估模型强度、持久性、排名表现和成本调整后的购买力时,华盛顿州普吉特海湾地区成为最强劲的整体候选地。华盛顿州梅迪纳在模型中持续排名靠前,同时保持可接受的建设经济性。新泽西州霍博肯显示出最强劲的整体需求信号,而加利福尼亚州山景城、弗吉尼亚州阿灵顿、华盛顿特区和加利福尼亚州德尔艾尔也保持高度竞争力。其他几个地点,包括亚利桑那州坦佩、阿拉巴马州亨茨维尔、新墨西哥州阿尔伯克基、科罗拉多州科罗拉多斯普林斯、宾夕法尼亚州匹兹堡和加利福尼亚州圣迭戈,在多种加权情景下表现出强劲的持久性,值得考虑用于未来扩展。
与现有及计划中的国防创新单元地点进行比较后发现,与几个已识别的创新走廊存在大量重叠,包括加利福尼亚州湾区、得克萨斯州奥斯汀、阿拉巴马州亨茨维尔、马萨诸塞州波士顿/剑桥、纽约/新泽西以及加利福尼亚州圣迭戈。然而,分析也发现了潜在的基础设施缺口区域,如普吉特海湾地区、华盛顿特区国家首都区部分区域、新墨西哥州阿尔伯克基、科罗拉多州科罗拉多斯普林斯和宾夕法尼亚州匹兹堡。
本研究的主要结论是,未来的机密空间规划应以创新地理而非传统机密基础设施地理为指导。分析表明,未来对机密访问的需求最有可能在多种创新驱动因素汇聚的地点涌现,这些驱动因素包括风险投资、防务相关企业、大型技术生态系统以及积累的技术知识。然而,仅靠创新需求不足以作出投资决策。实际考量,如建设成本、设施容量和现有机密基础设施布局,也必须纳入考虑。因此,以下分析审视了在纳入成本调整后的购买力时,领先的以创新为中心的地点如何变化,以及这些发现与当前及计划中的国防创新单元扩展工作相比如何。总之,这些结果为识别未来机密基础设施投资可能产生最大战略价值的地点提供了一个框架。本研究结果总结于以下三个表格中:(1)成本效益分析前的机密空间候选地点;(2)成本效益分析后的地点排名;(3)与国防创新单元机密空间规划工作重叠的地点。
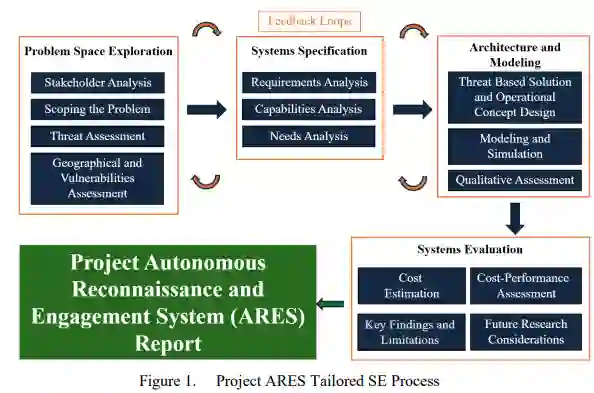
本报告采用系统工程方法,开发并评估一种美新联合机器人、自主系统与人工智能(RAS-AI)系统之系统,以防御关键海上基础设施。报告识别并分析了能力差距、需求、备选方案、采购成本以及性能指标。所提出的解决方案——“自主响应与交战系统”(ARES),通过建模与仿真以及定性分析,针对四种不对称威胁场景进行了评估。ARES初期通过“ARES融合中心”(AFC)整合现有传感器、平台和指挥控制系统,以建立通用作战图并改善决策,随后分阶段扩展能力以解决已识别的缺陷。分析结果表明,在新加坡现有防御架构中,水下探测是主要的能力局限。敏感性分析发现,与同等幅度的探测概率提升相比,增加探测距离能带来更大的性能改进。此外,防御系统在应对蜂群战术时面临重大挑战,这凸显了早期威胁探测和多域协调的必要性。报告估算了系统的实施成本,并用于评估成本与性能之间的权衡。该分析支持系统的分阶段实施,以在适应预算的同时提升能力。
综述|从参数到行为:大语言模型融合的统一框架与实践边界
论文:From Parameters to Behaviors: A Survey of Model Fusion for Large Language Models 作者:Shuo Cai、Yanggan Gu、Zihao Wang 等 来源:arXiv:2609.19553,论文标注为 Findings of ACL: EMNLP 2026 录用稿 原文链接:论文页面|PDF|论文 HTML|配套论文清单 导读:模型融合常被狭义地理解为“合并权重”。这篇综述把问题重新放到一个更完整的坐标系中:给定多个各有专长的源模型,能否得到一个推理时无需调用完整源模型、却尽量保留其能力的目标模型?作者以构建目标模型时使用的主要信号为准,将方法分为参数融合、表示融合、行为融合三层,并贯通定义、方法、评测、实践建议与风险。本文依照论文正文顺序整理,重点解释三层之间的边界及适用条件;图均截取自原文,中文图题为编译说明。
1 Introduction|引言
开源模型及领域微调模型持续积累,重复训练一个覆盖所有任务的模型并不总是经济。模型融合希望把数学推理、代码、对话或垂直领域等分散能力整合到一个可独立部署的目标模型中。论文的核心贡献不是推出某个新算法,而是给出能同时容纳模型合并与知识蒸馏的统一定义,并综述 150 余篇相关研究。 这一统一视角有现实意义:最便宜的权重平均可能遭遇任务向量冲突;能够观察隐藏状态时,可定位并修复层间表示漂移;只能查询外部模型时,则可通过分布、示例或反馈迁移行为。选择方法首先取决于能访问什么信号,其次才是算法名称。作者还强调,模型融合能服务持续学习和能力复用,但平均成绩提升并不保证每项源能力都被保留下来。

图1|模型融合的总体定义。多个源模型向目标模型提供参数、内部表示或可观察行为;融合完成后,目标模型推理不再依赖完整源模型。图内英文为论文原图,图片来源:原文图1。

图2|代表性模型融合方法的发展时间线。颜色对应三类主要融合层级;图中的 2026 年数量只是部分年度快照,不能视作全年统计。图片来源:原文图2。
2 Definition and Formulation|定义与形式化
论文把模型融合定义为:通过组合参数、对齐表示或蒸馏输出行为,从多个源模型构造一个目标模型,整合源模型知识与能力,同时保持高效推理。设源模型集合为 S,可选融合数据为 D,目标模型参数为 θ,则融合过程可写作 θ=Φ(S,D)。这里 D 可以为空,所以无数据的权重合并与需要数据的表示校准、行为蒸馏均在框架内。 关键约束是推理独立性:目标模型一旦构建完成,生成预测不再需要完整源模型。因此,多模型集成、按请求路由至某个源模型的系统,不属于本文定义的融合;单纯用大模型评审输出,也没有构造目标模型。作者还刻意区分行为蒸馏与仅使用标量奖励的强化学习:若教师在学生自己生成的状态上提供密集的 token 级目标或等价的分布约束,可算在策略蒸馏;只返回一个奖励分数、没有迁移教师输出行为,则不算。 形式化目标是减少目标模型在各源任务分布上与相应源模型的输出差异。这是能力保留的统一表述,并不是说所有方法都必须直接优化同一个损失函数。由此可见,分类依据是构建或更新目标模型时的主导信号,而非最后产物是否也是一组参数。
3 Taxonomy of Model Fusion|模型融合分类

图3|论文提出的模型融合分类树。参数层细分为算术规则、子空间、优化和模块;表示层分为加权、闭式求解和反向传播;行为层分为分布、示范、反馈,并另标注在策略学习;最下方是评测资源。图中方法仅为代表,不是穷尽清单。图片来源:原文图3。
3.1 参数层融合
若多个源模型共享参考参数 θ₀,可将第 i 个模型相对参考模型的变化写作任务增量 Δᵢ。参数层方法对这些增量做加权、屏蔽、缩放、置换或子空间投影,再合成目标参数。其优点是通常不必反复查询源模型,也可以完全不依赖训练数据;其前提是参数坐标有可比较性,至少要认真处理结构、初始化和词表兼容性。 论文将参数层方法分为四组。算术规则包括随机权重平均、Model Soups 和 Task Arithmetic;后者把微调前后的参数差看作可加减的任务向量。Fisher Merging 等方法根据参数重要性赋权,而 TIES-Merging、DARE、DELLA-Merging试图通过符号一致性、稀疏化或重标定减少任务增量冲突。子空间方法利用奇异值分解等工具辨别共享方向和任务特有方向,降低不同能力相互覆盖的风险。优化方法如 AdaMerging 学习不同任务或层的融合系数;即便系数是从无标签数据中估计出来,只要它服务于源参数的组合,仍归入参数层。模块方法融合 LoRA、Adapter、投影器等可插拔部件,适合参数高效微调的场景。 这里最容易误解的是“能平均”不等于“平均后能兼顾能力”。源模型虽来自同一底座,微调方向也可能冲突;而来源不同的模型若连参数对应关系都没有,直接求平均通常缺少合理解释。参数层的实际价值是为兼容模型提供低成本基线,再据保留率和干扰程度决定是否需要修复。
3.2 表示层融合
表示层以隐藏状态、注意力、激活统计等中间表示为主要融合信号,目标是在对齐后的层或组件上,缩小源模型与目标模型的表示差异。这里的“对齐”可包含层匹配、归一化、维度投影;距离可采用均方误差、余弦或相关性差异、分布矩等。它比仅看权重更容易发现“参数已经合并,内部特征却发生漂移”的问题,但需要内部访问权限和校准样本。 作者概括了三条路径。第一,表示驱动的加权与匹配:利用激活量级或子空间估计合并权重,或用单元相似度、最优传输建立组件对应关系,代表方法包括 AIM、MAGIC、REPAIR、ZipIt!。第二,局部闭式求解:把线性层的表示匹配化成回归问题,直接求解;RegMean 使用输入协方差,RegMean++考虑层内与跨层依赖,FeatCal 进一步校准沿网络前向传播累积的漂移。第三,反向传播修复:训练目标模型或轻量修复模块,使隐藏状态、注意力等对齐;Patient KD、TinyBERT、TED 将中间层监督纳入蒸馏,Representation Surgery 系列则着重修补初步合并后的表示偏差。 三条路径对应不同开销:加权快,但对校准数据敏感;闭式方法适合可对齐的线性部件;反向传播可处理更复杂失配,却需要更多数据、训练与正则化。论文提醒,融合后表示漂移的诊断、异构模型之间的层对齐,仍是未解决问题。
3.3 行为层融合
行为层不要求拿到源权重或隐藏状态,而是用源模型可观察的输出训练一个目标模型。行为信号可以是 token 分布、logits、完整回答、推理步骤、工具使用轨迹,也可以是有来源可追溯的偏好、批评、纠错或验证器反馈。它适合闭源或异构源模型,但不能把“用了一个外部评分器”一概称为模型融合;必须确有源模型行为向目标模型转移。 论文按信号将其分为三类。分布融合对齐软标签或输出概率,经典知识蒸馏与 FuseLLM 类工作属于此类;细粒度分布信息丰富,但可能需要昂贵的 logits 访问。示范融合使用源模型生成的回答、推理链和轨迹,访问门槛低,却可能复制错误推理、风格偏差与数据噪声。反馈融合利用多源答案的排序、偏好、修正或验证标签来调整目标模型,适合对齐和安全能力迁移,但质量受评估器与反馈可靠性制约。 另一个与上述三类正交的区分是离策略与在策略。离策略方法在固定数据上训练,便于扩展,但学生部署时遇到的状态可能不在训练分布内。在策略蒸馏先让目标模型生成前缀、回答或轨迹,再让源模型针对这些状态给出监督;GKD 等方法由此针对学生真实会犯的错误学习。代价是反复查询教师和训练目标模型,预算、稳定性及多源行为冲突随之成为关键约束。
3.4 评测
指标。 论文首先区分目标模型在任务池上的平均表现与逐任务的归一化能力保留率。如果模型在四项任务上大幅提高、在第五项关键任务上显著下降,仅看平均值会误判融合成功。还应观察干扰程度、未见任务泛化、对齐、安全性,以及融合和推理成本。 基准。 一个有效的融合基准不仅是排行榜,还应给出统一的源模型池、任务池与评测协议。FusionBench 支持多种参数层方法在共享设置下比较;MergeBench 侧重领域源模型的能力保留、泛化和成本。当前可复用资源仍偏重参数层,表示层常在具体论文中评测漂移,行为层多借用蒸馏或安全任务基准。论文因此建议未来统一报告源模型设置、逐能力保留、最差任务退化、行为迁移与融合开销。
4 Practical Takeaways|实践启示

图4|三种融合层级的典型信号与实践权衡。图中的数据需求和源模型访问条件表示常见相对要求,并非绝对门槛;完整流水线可以组合多个层级。图片来源:原文图4。 第一,按可用信号和失效模式选方法。 同架构、同初始化、同词表且可获取权重时,可先试参数合并;若融合后出现明显层表示漂移,并能访问隐藏状态,可做表示校准;当只有回答可用或源模型高度异构时,行为蒸馏更现实。这个顺序是工程筛选路径,不是性能排名。 第二,跨层级排名随数据与预算变化。 论文只采用同一研究内的对比以减少条件混杂:在 M2RL 的五领域设置下,TIES 与 TA+DARE 的均分分别为 61.00、60.99,行为层 MT-OPD 为 60.46,但后者报告约 967.9 GPU 小时训练;在 MergeBench 的另一组任务中,RegMean 为 46.3,介于 TIES 的 46.8 与 DARE 的 45.2 之间。ProDistill 在 16、32 样本下落后于 Task Arithmetic,在 64 样本下以 0.2496 略高于其 0.2448。这些数字属于不同实验设置,不能互相横比或推出统一优胜者。
第三,跨层级流水线有互补性。 先用低成本参数合并得到目标,再以表示校准修复内部漂移,仍有缺失能力时增加行为监督,是论文归纳出的实用路线。原文所引同论文对比中,FeatCal 将 Task Arithmetic 六任务均分从 63.5 提升至 65.8;Patient KD 将 RACE 准确率从 58.74 提升至 60.34。它们说明“增加第二种信号可能有效”,并非保证所有融合任务都会获益。
5 Challenges and Future Directions|挑战与未来方向
理论基础与适用条件
目前仍难在构建目标模型前可靠预测:哪些源模型可兼容、目标容量是否足够、何时会损失某一源能力。针对相近参数盆地或特定平均策略的理论,尚不能直接推广到表示对齐与行为蒸馏。研究需要把源模型差异、数据覆盖、目标容量与能力保留联系起来,给出可检验的适用条件。
异构源模型的对齐
不同架构、参数化、词表、模态接口,会同时破坏权重坐标、隐藏状态对应与输出空间的可比性。最优传输、投影和跨模型翻译提供了探索方向,但对齐错误会让源能力相互干扰,甚至形成表面上均分提高、实则重要能力丢失的结果。
多源能力保留的评测
应围绕“每个源模型的优势是否仍在”建立评测,而不只报告目标平均分。论文主张共享源设置,检查最差任务退化、跨能力干扰、成本和单模型推理条件,并把表示漂移与行为迁移纳入可复现协议。对于持续融合,还须记录新知识加入后旧能力的遗忘曲线。
融合中的风险转移
恶意参数更新、后门、不安全回答和隐私信息可能随参数合并或行为蒸馏进入目标模型;源模型移除后风险也可能仍然存在。作者建议对源模型与贡献进行筛查、溯源和归因,融合后再做专门安全测试。原论文指出已有攻击与防御研究,但尚没有一套保证所有融合设置安全的通用机制。
6 Conclusion|结论
这篇综述最重要的判断是:模型融合的共同目标是形成可独立推理的单一目标模型;参数、表示、行为是按主要融合信号划分的三层,而非互斥的工艺流程。 三层各有优势与代价,现有研究不支持“某一层始终最佳”的结论。面向实际应用,应该先检查可访问性与兼容性,再用逐能力评测发现退化,必要时叠加表示修复或行为监督,并始终计入安全与部署成本。
Limitations|论文局限
作者承认领域更新迅速,最新预印本或细节未公开的工业系统可能未被覆盖;一些方法横跨多个层级,按主导信号归类存在边界争议。论文中的跨研究数字只用来说明条件依赖,模型规模、数据、调参和硬件成本没有统一控制,不能视为严格的跨方法排行榜。读者引用具体效果时,应回查相应原论文的设置与方差报告。
Appendices|附录导览
原文附录 A 给出符号定义;附录 B 讨论持续学习、多任务与领域能力整合、安全控制、模型压缩四类应用;附录 C、D、E 分别扩展参数层、表示层、行为层方法表;附录 F、G 对照融合基准与评测指标;附录 H 补充持续融合的遗忘问题和大规模部署成本。本文为控制篇幅未逐表翻译,具体方法与基准细节可从上方论文链接核对。
综述|从模型到系统:高效多模态学习的全栈路线图
论文:From Models to Systems: A Comprehensive Survey of Efficient Multimodal Learning 作者:Pan Wang、Siwei Song、Hui Ji 等 15 位作者 来源:Transactions on Machine Learning Research(TMLR),2026;arXiv:2609.19445 原文链接:论文页面|PDF|网页版|持续更新的资料库
导读:多模态模型同时处理图像、文本、语音、视频和传感器数据,瓶颈不只在参数量。即使模型 FLOPs 下降,视觉编码等待、显存中的 KV 缓存、不同模态的内存带宽与设备调度,仍可能让实际延迟居高不下。本文整理 Pan Wang 等人的综述,依原文 1—9 节展开:先建立模型—算法—系统(MAS)三级框架,再讨论多模态大模型、应用基准、跨层协同与开放挑战。论文汇集 300 余项研究;本文的图均截取自论文,图内保留原英文,中文图题为阅读说明。研究综述中的复杂度和方法效果须结合具体任务、硬件与测量条件理解。
1 Introduction|引言
多模态效率问题
多模态学习不只是把几条单模态流水线拼起来。图像是高密度空间信号,视频与语音带有不同时间尺度,文本则是离散且语义密集的序列。理解任务可能输出一个类别或答案,生成任务还要持续解码;数据又可能成对、弱配对乃至彼此分离。因此,单纯缩小某个编码器,不能保证整套系统高效。 论文将高效多模态学习(EML)的目标归纳为:在能力与泛化不被不合理牺牲的前提下,压低计算、显存、延迟、能耗及部署成本。作者没有把来自不同硬件和任务的加速数字排成统一榜单,而是追问“效率注入在计算栈的哪里,层间如何相互作用”。
模型—算法—系统分类
MAS 框架给出三个相互关联的答案:模型层决定算什么,例如采用双塔还是统一编码器、是否使用专家稀疏路由;算法层决定怎么算,例如压缩 token、剪枝、量化、蒸馏、缓存与自适应退出;系统层决定何时何地算,例如显存管理、边云协作、流水线调度及软硬件协同。一个多模态应用通常同时跨越三层,效率收益也不能只归功于某个孤立模块。
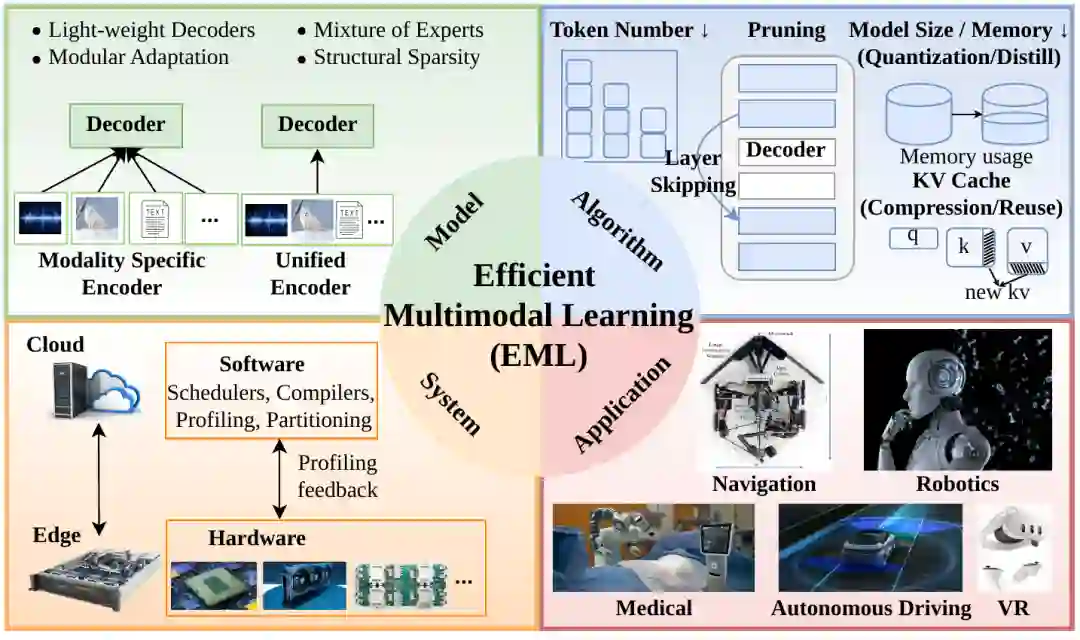
图1|高效多模态学习的总体图景。模型结构、算法压缩与系统执行三层共同支撑自动驾驶、机器人、医疗、虚拟现实等应用。图内英文保留自原文;图片来源:原论文图1。
综述范围与贡献
作者梳理 2020—2026 年间 300 余项工作,优先收录能说明 FLOPs、推理延迟、内存或能耗变化的研究;纯粹追求准确率提升的工作不作为本综述主线。论文的贡献是统一分类、分析纵向协同,以多模态大模型(MLLM)为案例观察演进,并为应用与未来研究提供路线图。它是一篇方法和系统视角的文献综述,不是在统一实验平台上重测所有方法的比较论文。
2 Model|模型层
模型层改变架构拓扑,核心是减少不必要的处理,同时保留模态对齐、交互和表达能力。
2.1 模态专用编码器
视觉、文本、语音等先各自抽取特征,再做跨模态交互,是传统且有效的设计。视觉侧从轻量 CNN、层次化视觉 Transformer 到状态空间模型,分别压低局部计算、全局注意力或长序列成本;视频需要处理大量相似帧,采用掩码建模、时序分层或轻量时空模块。音频从卷积声谱图编码器走向自监督预训练与离散语音 token,重点是把高采样率连续信号变成语言模型可消费的紧凑表示。 这类架构能利用各模态成熟的归纳偏置,但专业编码器越多,跨模态接口、存储和调度也越复杂。对低照度图像、稀疏深度数据或不规则时间序列,保留特定前端仍可能比强行统一更稳妥。
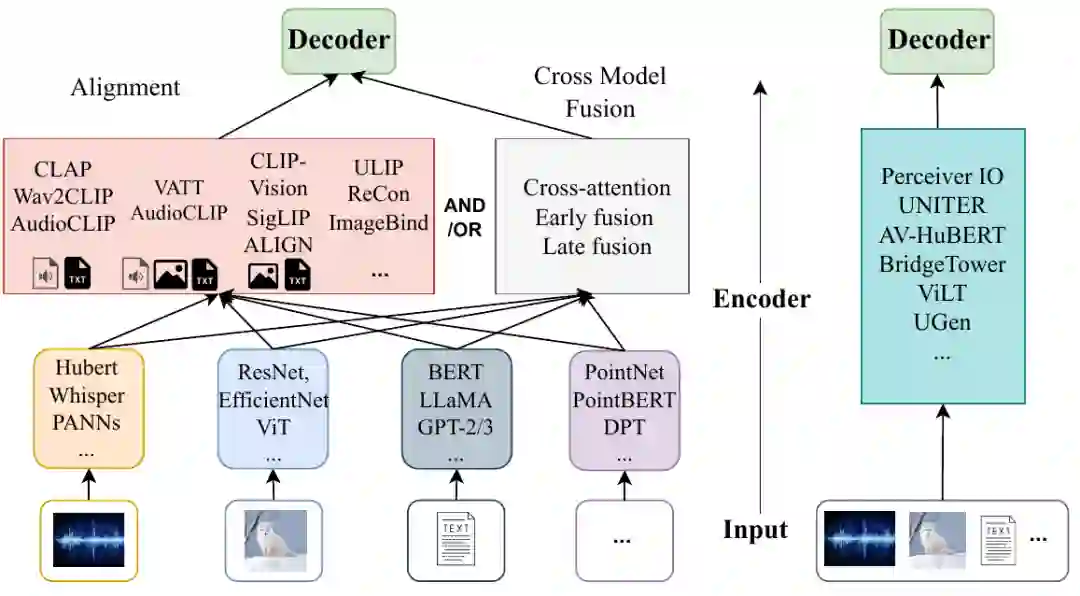
图2|模态专用流水线与统一编码器的结构对照。左侧通过独立编码与后期对齐/融合处理异构信号;右侧让多模态输入进入共享参数核心。图片来源:原论文图3。
2.2 统一多模态编码器
统一编码器试图让异构输入共享一个主干或潜在空间,减少并行分支的重复参数与基础设施。Perceiver 类方法用固定大小的潜变量承接不同长度输入;统一自回归方案则把图像、音频、视频转换为可混排的表征或 token,在共享序列目标下学习。这样有利于通用推理与跨模态生成,但前端编码、离散化误差、极长序列成本仍需单独处理。 论文强调两类结构不是“新旧优劣”的简单替换:模态专用编码器适合需要高保真局部细节的场景;统一核心更适合通用任务与跨模态交互。关键是把昂贵的感知流压缩到足够的信息密度,而不是仅仅减少模块数量。
2.3 结构稀疏
混合专家(MoE)通过路由只激活部分参数,使总容量与每次前向的活跃计算脱钩。多模态模型可按模态分派专家,也可按 token 内容、难度和预算动态分派。它适合视觉 patch 大量冗余、文本 token 相对密集的非对称输入。不过,路由偏斜可能造成专家失衡和表示碎片化,迁移到新模态时也未必保持零样本泛化。结构稀疏内嵌在模型设计中,区别于训练后直接剪去权重。
2.4 结构化解码
高分辨率感知特征若全部交给自回归语言模型,跨模态注意力与生成成本会快速上升。Flamingo 的重采样器和 BLIP-2 的 Q-Former 代表了“有限查询接口”思路:先用少量潜在查询从密集视觉特征提炼信息,再接入语言解码器。它能把计算规模与原始输入长度部分解耦,却也可能像信息瓶颈一样滤掉细粒度定位、文字识别等任务所需的高频细节。
2.5 模块化适配
投影层、Adapter 与 LoRA 把跨模态连接或新任务适配放到小模块中,使大骨干保持冻结。LLaVA 式投影器负责把视觉特征映射到语言空间,低秩更新则降低微调与存储成本。好处是快速扩展能力、部署多个任务版本;局限是过窄的适配空间可能无法吸收与原有表征正交的新知识。论文因此把模块化适配视为能力扩展与骨干维护解耦的手段,而非无损替代全量训练。
2.6 本层要点
模型层的演进主线是:从独立感知分支走向共享潜在核心,并以结构稀疏、受限接口和轻量模块管理不同模态的信息密度。最终评判仍应包括语义保真与泛化,不能只报参数量或理论复杂度。
3 Algorithm|算法层
算法层通常不彻底重画架构,而是调整信息流的长度、精度、稀疏性和复用方式。论文按原文分为七类。
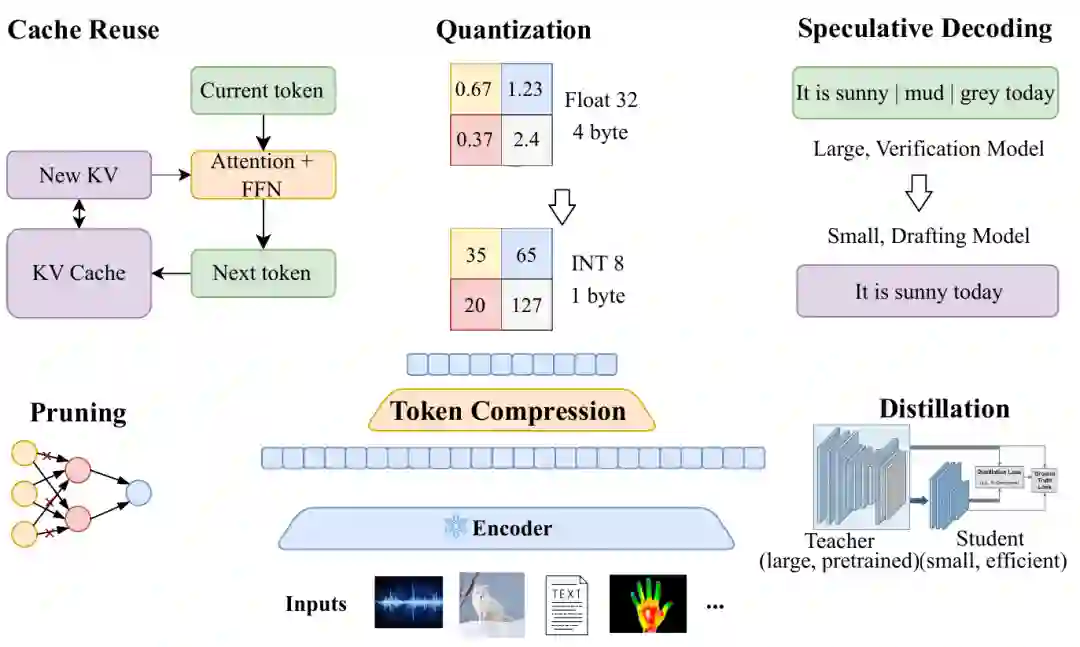
图3|算法层效率方法示意。原文列出的七条主线包括 token 压缩、剪枝、量化、蒸馏、提示与推测解码、缓存复用、运行时稀疏;图中用若干代表机制辅助理解。图片来源:原论文图4。
3.1 令牌压缩与选择性计算
视觉、视频和音频流常含大量相邻冗余,压缩目标应是保留任务相关的证据,而非机械地删去固定比例。免训练方法依据注意力、特征相似度或层间变化筛选和合并 token;训练式方法用可学习评分器、池化或聚类,在任务损失下学习保留哪些区域或片段。对于图表识别、细粒度目标或语音短瞬态,错删的代价远高于一般背景 patch。综述所引部分系统可大量删除视觉 token 并保持其设定下精度,但这一比例不能迁移为所有任务的默认阈值。
3.2 剪枝
参数剪枝删除权重、神经元、注意力头或层。非结构化稀疏可在理论上压低乘加次数,却常因不规则访存而没有对应的真实加速;结构化剪枝更容易映射到 CPU/GPU 的连续数据布局。多模态的难点是不同分支与对齐层敏感度不同,因此应按模态与组件分配剪枝率,并用跨模态任务检查是否破坏语义对应。
3.3 量化
量化把权重或激活映射到较低位宽,降低模型存储与内存带宽压力。多模态场景中,视觉、语音、文本特征的数值范围和离群点不同,统一位宽可能让某一模态失真,进而发生对齐漂移。后训练量化(PTQ)部署便捷;量化感知训练(QAT)在更激进低比特时通过训练适应量化噪声。方法如 Q-VLM、MBQ 采用模态敏感或混合精度策略。位宽变低不必然带来速度提升:还要看设备是否原生支持该格式,以及反量化和混合精度重排的成本。
3.4 知识蒸馏
大教师向小学生转移知识,论文进一步区分预测、表示和行为三类信号:对齐输出概率;匹配中间特征、注意力和关系结构;或迁移推理轨迹、偏好与决策过程。多模态蒸馏尤其需要保住视觉定位与语言推理之间的联系。只压缩最后答案,可能得到会模仿结论却不会可靠辨认图像证据的学生;加入空间或过程监督可缓解这一问题,但训练与教师查询也会增加成本。
3.5 提示与推测解码
连续提示或前缀微调只更新少量任务参数,降低适配存储和训练开销。推测解码则针对自回归生成的串行瓶颈:小模型先提出候选,大模型批量验证。在多模态情境中,共享视觉编码结果或缓存,可避免草稿模型与验证模型重复计算昂贵感知前缀。实际收益取决于候选接受率、验证批量与缓存共享,不能只看生成 token 数。
3.6 缓存与复用
KV 缓存随序列和并发量增长,长视频或连续语音尤其容易触及显存上限。算法层可根据重要度淘汰/合并 token,对静态背景跨帧复用,对重复前缀或相似请求复用历史状态。删除冗余视觉 patch 时,必须保护承载指令和关键语义的锚点;跨会话复用还要考虑位置编码、隔离与隐私边界。
3.7 运行时稀疏
与永久剪枝不同,运行时稀疏按输入难度决定执行深度和连接密度:容易样本提前退出,稳定的视频帧跳过部分层,复杂目标再动用完整路径。它能让计算资源跟随样本而非固定最坏情况分配,但需校准退出置信度,防止“看似容易”的高风险输入被过早终止。
3.8 本层要点
算法层的共同逻辑是尊重各模态的冗余不对称性:稀释冗余视觉/音频信息,同时保护稠密文本语义和跨模态锚点。理论 FLOPs、模型体积和真实服务延迟是不同指标,最终必须回到硬件和任务上测量。
4 System|系统层
当模型进入持续对话、实时视频或边缘设备,主要瓶颈会从算术运算转为显存、I/O、调度和数据移动。系统层把“可计算”变成“可交付”。
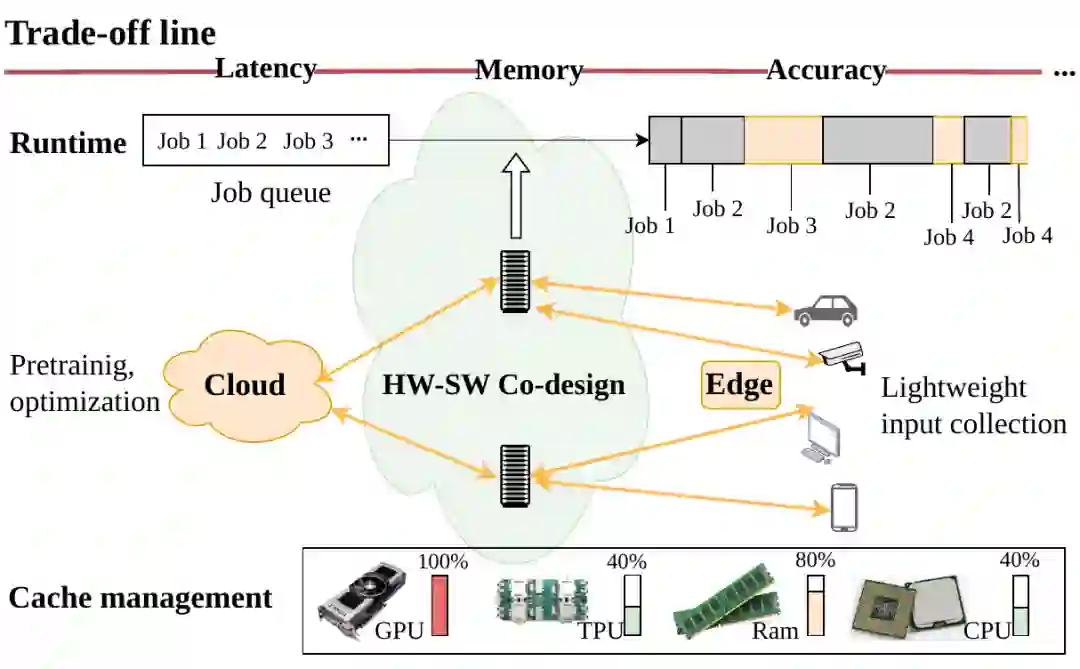
图4|系统层弹性资源编排。围绕 KV 缓存与服务、边云协作、延迟敏感调度、软硬件协同四条主线,将模型与算法层的理论收益转为实际吞吐和响应速度。图片来源:原论文图5。
4.1 缓存管理与服务
多请求并发时,KV 块的物理布局、碎片与冷热迁移直接影响最大批量和响应时间。动态缓存池按请求生命周期管理显存,跨会话共享前缀则避免重复预填充。论文提及面向长上下文的分层缓存与持续状态方案,重点不只是“把 KV 压小”,而是让它成为可调度、可复用的资源。评估时应同时报告峰值显存、吞吐、首 token 延迟及长尾延迟。
4.2 边云协作
边缘设备贴近传感器、响应快,却受功率和计算限制;云端推理强,但上行带宽与隐私约束更严。典型做法是边端先筛帧、提特征、处理简单样本,再把不确定或复杂请求上送;云端更新能力后回传轻量适配。这里的效率包含通信量、断网可用性和数据暴露,不只是两台设备上的 FLOPs 相加。
4.3 延迟感知调度与流水线
视觉编码和语言预填充往往耗时不同,串行执行会让某一计算单元等待另一模态。异步流水线可交错不同请求的编码、预填充和解码;按任务复杂度分层路由可满足服务等级约束。综述引用 RServe 的同设置实验说明并行编排可提升吞吐,但加速倍率不能脱离硬件、负载和批量条件复用。
4.4 软硬件协同设计
算子需求不同:某些大矩阵乘法受计算单元限制,高分辨率特征与注意力则可能受带宽限制。软硬件协同把不同模态的算子映射到合适处理器,尽量减少数据搬运;也可把实际延迟、能耗和峰值内存纳入架构搜索。若某个 3-bit 格式或非规则稀疏在目标设备上没有原生支持,论文里的理论压缩就未必是部署收益。
4.5 本层要点
系统层不是前两层做完后的“工程收尾”。它反过来约束模型拓扑和算法形式:能被融合的核、规则的数据布局、可共享的缓存,往往比纸面上更低的运算量更重要。
5 Efficient MLLMs|高效多模态大模型
5.1 从模型到系统的演进
论文以高效 MLLM 为 MAS 的综合案例。早期 BLIP-2、LLaVA 等聚焦冻结骨干与轻量接口,解决跨模态对齐训练成本;随后关注视觉 token、KV 与生成延迟,通过压缩和动态执行控制运行成本;近年更强调端云分工、缓存共享、服务调度与硬件适配。这个时间线反映研究焦点的迁移,不是说早期模型已过时,也不等于每个新方法仅属于一个层级。
图5|代表性高效 MLLM 的时间线。原图按主要优化层级标色:绿色为模型层、蓝色为算法层、橙色为系统层。它用于观察研究主题变化,不代表完整模型清单或统一性能排名。图片来源:原论文图6。
5.2 纵向协同
稀疏专家使总容量与活跃计算分离;紧凑视觉编码需要能接住它的算子与调度;缓存复用必须与 token 筛选、位置处理相容。作者把这类架构—执行—系统联合设计视作下一阶段重点。所谓自调节计算,是根据输入难度、实时预算与设备状态动态决定“算什么、怎么算、在哪里算”的研究方向,而非已经普遍实现的产品能力。
6 Applications and Benchmarks|应用与基准
6.1 情感计算
语音、表情与文本共同提供情绪线索,响应必须及时,还涉及敏感个人数据。轻量适配、动态片段筛选、端侧推理应一起评估;常用基准包括 CMU-MOSI、CMU-MOSEI、IEMOCAP。对短促情绪变化不能过度压缩。
6.2 具身智能与机器人
视觉—语言—动作闭环受感知到执行延迟约束。应优先保持动作相关的视觉细节,并把高成本编码与动作解码流水化;R2R、ALFRED、Ego4D 等分别覆盖导航、指令执行或视频活动理解。真实机器人还需关注功率和安全失误,不应只看离线准确率。
6.3 媒体理解与生成
长视频和连续音视频的瓶颈是时空冗余与上下文显存。关键帧/片段选择、缓存复用和冷热状态分层尤其重要。Video-MME、MVBench 等能测理解能力,但完整服务评测仍应补上输入时长、峰值显存和流式延迟。
6.4 医疗健康
医学影像、报告、语音和传感器数据要求细节保真、可解释与隐私保护。过激量化或 token 筛选可能漏掉微小病灶;本地部署与联邦协作降低原始数据集中风险,但不能替代诊断校验。MIMIC-CXR、IU-Xray 等只覆盖部分任务情境。
6.5 空间理解
自动驾驶和三维场景处理相机、雷达、点云及定位信号。把稀疏 3D 点云组织成鸟瞰图等紧凑结构,可改善计算布局,但同步和几何精度必须保留。nuScenes、Waymo Open Dataset 等基准应与车载硬件的端到端延迟、能耗共同看。
6.6 多模态推理
图表、视觉问答、数学和科学问题不仅要“看见”,还要逐步验证。模块化感知与程序化工具调用可把昂贵推理留给真正困难的子问题;VQAv2、ScienceQA、MathVista、ChartQA 关注能力侧,部署侧还要核算每题延迟及错误路径代价。
6.7 联邦学习
多医院或多设备合作训练时,可只同步提示、适配器等小参数,而非上传原始数据或完整模型。缺失模态与设备异构会影响对齐;本地保存数据也不自动等于隐私安全,仍需差分隐私、安全聚合和攻击测试。论文以 FedMultimodal、Med-MMFL 等作为相关评测资源。
7 Holistic Discussion|整体讨论与应用策略
7.1 纵向协同机制
跨层收益并非三项单独加速的简单相加。统一编码器改变了量化、剪枝面对的特征分布;结构化稀疏便于硬件核利用;算法压缩只有与内存布局、缓存生命周期匹配,才可能变成真实壁钟时间优势。这也是论文最有实践价值的判断:把 FLOPs 优化置于完整执行链中验证。
7.2 面向应用的策略
对机器人、自动驾驶等延迟优先任务,重点是边端感知过滤、流水线重叠和稳定的最坏情况时延;对医学影像等保真与隐私优先任务,应保护关键通道精度、审核压缩引起的细节损失,并用受控协作降低敏感数据流动;对云服务等吞吐优先任务,稀疏专家、共享状态与显存池有更大价值。最优方案是具体约束下的效率—效用—隐私折中,而非一套固定技巧。
7.3 走向自调节智能
论文展望系统把成本和设备状态纳入自身决策,按不确定性动态调节输入粒度、计算深度和执行位置。要从愿景走向可靠部署,还需要成本可观测、策略可校准,并对高风险样本设置不随意退出的约束。
8 Open Challenges and Future Directions|开放挑战与未来方向
8.1 跨模态统一表征
图片、声音、视频和文本不必全部强行转成同一种离散词元,但它们需要可共享的语义接口和可控的序列长度。未来方向包括连续潜空间、共享码本、可变速率压缩,以及让分词/切片策略与缓存调度共同设计。
8.2 多任务泛化与稳健性
在视觉—语言任务上省算,不代表缺失音频、换传感器或跨领域时仍有效。需要检查模态缺失、分布偏移和任务切换条件下的能力与资源曲线,避免优化只适配某个数据集。
8.3 软硬件协同与部署
交叉注意力、动态模态切换和稀疏路由,对编译器和加速器提出不同于纯文本模型的要求。亟须硬件友好的稀疏模式、融合算子及端云弹性编排,让算法节省真正落到设备上。
8.4 以人为中心的效率
用户感知的首响应时间、交互流畅性和延迟尖峰,与平均吞吐同样重要。对某些任务,轻微且不可察觉的精度退让可能换来更好的实时体验;但公平性和可解释性不能被纯资源指标掩盖。
8.5 隐私与安全
端侧部署减少数据上云,不代表免于模型提取、侧信道或物理篡改。压缩也可能改变攻击面。效率、效用与隐私应共同建模;医疗影像和声纹等敏感模态尤其不能把“本地运行”直接等同于“合规安全”。
8.6 标准化评测
FLOPs、参数量只能描述局部成本,还应报告真实端到端延迟、首 token 时间、尾延迟、峰值显存、带宽、每次推理能耗、跨模态同步开销和任务质量。不同应用要在共享任务协议下给出硬件、批量与流式条件,避免把不可比数字当成统一榜单。论文希望形成类似多模态效率版 MLPerf 的部署感知评测。
9 Conclusion|结论
这篇综述把高效多模态学习从“压缩某个模型”的问题扩展为完整计算栈设计:模型层规定结构,算法层管理信息流,系统层兑现性能。MLLM 演进、应用差异及挑战都指向同一个结论:只有跨层协同,才能在实际设备和隐私约束下取得可靠效率。它提供的是分类与设计路线图;具体方法是否优于另一方法,仍需在同一任务、硬件和预算下实测。
Broader Impact and Appendices|影响与附录
原文的社会影响讨论同时指出两面性:效率研究可降低高能力模型的使用门槛与能耗,但也会降低滥用成本;边缘智能减少传输,却增加本地攻击暴露。附录 A 给出边缘系统案例,附录 B 汇总近期高效多模态模型,附录 C 比较已有综述。本文为控制篇幅不逐表转录,完整文献与附录请查阅文首 PDF 和项目资料库。
综述 | 具身智能世界模型:从可信预测、可控干预到行动效用
导读
当人伸手拿起杯子时,通常不会在脑海中生成一段高清操作视频,而是预估重量、抓取阻力和接触结果,据此调整动作。这个例子提示我们:世界模型的价值,在于预测能帮助智能体做什么,而不只在于画面看起来有多真实。
《World Models for Embodied Intelligence: From Plausible to Controllable to Actionable》提出一条面向决策的能力阶梯:模型首先要保持任务相关状态的一致性,其次要正确预测不同干预的影响,最终要把预测转化为可测量的行为或学习收益。本文将三层分别表述为“可信预测”“可控干预”和“行动效用”。这里的“可信”限定于被测试的状态、时域与条件,并非对模型整体可靠性的保证。 综述进一步用几何、物理、动作三个落地维度,与数据、奖励、策略、模型自身四种改进闭环组成一个三乘四矩阵,分析预测内容如何进入机器人系统。它覆盖操作、自动驾驶、导航、运动控制及跨机器人迁移,并提出与能力声明相匹配的评测要求。 下面沿用原文 11 个主体章节和小节顺序展开。配图截取自原文,保留图内文字,图注采用中文。本文介绍的是作者提出的综述框架;文献在分类中的位置不代表所有能力均已验证,也不构成统一条件下的性能排名。 论文信息
英文题名:World Models for Embodied Intelligence: From Plausible to Controllable to Actionable 作者:Nanjie Yao、Hao Wang、Chong Cheng、Zhikang Chen、Wenzhe Li、Jiafei Lyu、Li Shen、Peilin Zhao、Zongqing Lu、Gao Huang、Steven Hoi、Dacheng Tao、Deheng Ye。 作者单位包括香港科技大学(广州)、牛津大学、普林斯顿大学、腾讯、中山大学、上海交通大学、北京大学、清华大学、阿里巴巴、新加坡管理大学和南洋理工大学。论文为 arXiv 预印本,首次提交于 2026 年 9 月 15 日,PDF 共 51 页,含参考文献。 论文主页:https://arxiv.org/abs/2609.16697 原文 PDF:https://arxiv.org/pdf/2609.16697 项目页面:https://3dagentworld.github.io/EmbodiedWM/
1. Introduction | 引言
视觉—语言—动作模型让机器人能够从多模态观测和指令直接产生动作。但直接映射没有自动提供维护隐藏状态、预见延迟后果和比较候选干预的机制。这些能力在部分可观测、接触丰富和长时序环境中尤其重要。 世界模型连接感知与决策:保持任务相关信息,预判行动后果,并在执行偏离预期时支持修正。既有综述常按架构、输出模态或应用领域整理研究;本文则追问,各种预测能力是否足以支持更好的具身行为。 作者提出三个逐步增强的要求:保存正确的状态;对干预作出正确响应;使预测产生下游收益。这个视角允许潜在动力学、视频生成、三维预测、物理建模和世界—动作模型在同一框架下比较,同时把几何、物理、动作接口与实际改进路径联系起来。
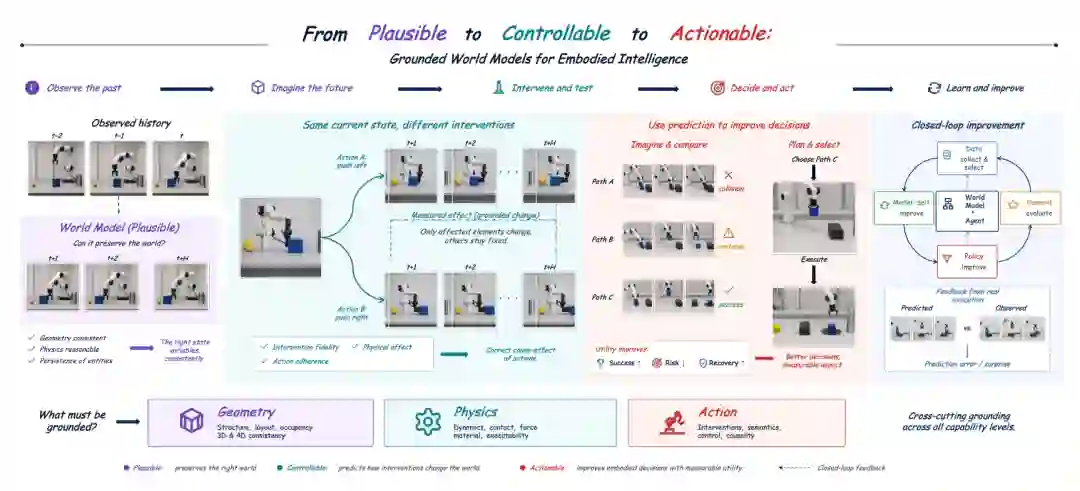
图1|综述总览。从历史观测出发,模型保持任务相关状态,比较同一初始状态下的不同干预,再通过预测改善决策;真实执行反馈进入数据、奖励、策略和模型自身闭环。几何、物理与动作落地贯穿三层能力。来源:原文图1。
2. Foundations, Definitions, and Boundaries | 基础、定义与边界
2.1 从学习动力学到世界模型
早期视觉前瞻研究将机器人动作与未来像素预测连接,并在模型预测控制中反复规划。PETS 引入概率集成与轨迹采样处理不确定性,PlaNet 将规划转向紧凑潜在状态,Dreamer 系列进一步在想象轨迹中训练策略。 另一条路线强调决策等价性。MuZero 等模型无需重建观测,而是保留搜索和价值估计所需的内部结构。由此,世界模型不必复现完整外部世界,只需保持与预测和决策相关的信息。短想象时域、保守目标和真实数据校准则用于限制策略利用模型错误。
2.2 世界模型的定义与范围
本文将世界模型定义为学习式或混合式的智能体—环境动力学预测模型:给定交互历史及可选候选动作,预测任务相关环境变量如何变化。预测状态可以是像素、特征、对象、几何、物理量、符号状态,或奖励与价值等决策相关量;解码回图像并非必要步骤。 学习仿真器是通过可重复轨迹接口暴露的世界模型;世界—动作模型则通过级联、共享表示或联合生成紧密连接预测和动作。纯反应式 VLA 不在本文操作性定义范围内,只有当可识别的未来预测机制影响动作、学习或执行时,才进入分类。奖励与评论家模型也仅在评价预测转移、想象轨迹或模型不确定性时纳入讨论。
2.3 预测表示
表示选择有三组独立维度:预测空间是观测、潜在状态还是结构化对象;预测内容是外观、几何、物理还是任务量;时间与动作接口是单步、动作块、子目标或长轨迹,以及显式动作、潜在动作或高层技能。 这些选择决定模型如何被查询,却不决定能力强弱。三维输出不自动可靠,高清像素预测也可能服务规划。应分别验证状态一致性、干预准确性与决策收益。
3. Unified Taxonomy | 统一分类框架
3.1 以落地对应关系为条件的能力阶梯
“落地”指预测与可测量具身属性之间明确、可检验的对应。几何维度关注对象身份、位置、遮挡和跨视角一致性;物理维度关注接触、碰撞、摩擦、力和材料响应;动作维度关注命令身份、时序、幅度、组合、坐标系和机器人平台。 可信预测层要求未来与历史和相关环境结构一致。最低证据是,在离线或开环测试中,至少一种任务相关状态属性随时间保持一致。应报告误差随预测时域的曲线,让漂移可见。 可控干预层要求改变动作时,模型预测的变化与实际执行变化一致。需要同一初始状态下的配对或分支干预,而不是仅改变提示词后得到不同画面。记录动作上的条件预测仍可能存在混杂,不能直接证明因果响应。 行动效用层要求预测改变决策或学习更新,并在匹配控制器及计算预算下改善结果,如成功率、安全、恢复、策略排序或真实数据效率。定性想象视频不足以支持这一层。 三层在要求上累积,但实际论文可能展示高层用途、却未检验某项低层能力。下游成功不能反推对象恒存或动作因果效应已被完整验证,应明确列出未测试部分。
3.2 落地维度与改进路径矩阵
矩阵行表示预测的内容,列表示预测改变的系统环节。它描述可能的接口,不是互斥类别,也不是能力等级。 | 落地维度 | 数据闭环 | 奖励闭环 | 策略闭环 | 模型自身闭环 | | --- | --- | --- | --- | --- | | 几何 | 采集新视角、遮挡与拓扑变化 | 评价碰撞、可见性与可达性 | 选择可行路径与对象关系 | 修正地图、身份和持久场景状态 | | 物理 | 采集接触、滑移、形变和罕见失败 | 评价稳定性、能耗与力限制 | 避免物理不可行或危险行为 | 修正局部动力学并检查退化 | | 动作 | 采集时序、幅度或平台不同的干预 | 评价命令遵循、进展与风险 | 从有支持的反事实结果选择动作 | 修正动作语义、延迟与转移偏差 | 一项方法可以跨多个单元格。进入某条改进路径只说明预测被使用;是否带来行动效用,仍需与匹配基线比较。
4. Plausible World Models | 可信预测世界模型
4.1 紧凑潜在状态与对象中心状态
C-SWM 用对象表示和关系网络描述状态,SlotFormer 在对象特征上预测动力学。联合嵌入预测路线则保留特征预测原则,不必显式拆分对象或重建像素,代表性研究包括 V-JEPA 等。 这一阶段减少预测目标的规模,并保留实体、关系或任务特征。但对象槽位不是场景中的度量位置,紧凑表示仍可能难以区分位置漂移与对象丢失。
4.2 度量场景状态:占用、点与渲染
OccWorld、MUVO 等将未来放入三维占用空间;鸟瞰、点云和高斯表示进一步使深度、占用或位移成为可量化目标。几何约束还能通过中间特征对齐和跨视角监督进入视频模型。 PointWorld 等把状态和动作关联到三维点流,便于检验空间变化。代价是表示随空间范围和预测长度增长;邻近视图一致也不代表离开场景后重访仍保持同一世界。
4.3 物理落地动力学与交互保真度
几何一致的场景仍可能出现穿透、失去支撑或不合理材料响应。IntPhys、PHYRE、CLEVRER 和 Physion 等提供将物理事件与画质分开检验的资源。 方法可以通过方程约束、对象局部动力学、粒子表示或物理相关辅助任务限制状态演化。PhyDNet、ParticleFormer 等体现不同归纳偏置。关键是把接触、摩擦、力和材料响应变成可评价变量,而非仅把物理合理性留给观看者判断。
4.4 持久记忆与长时序稳定性
持久场景或空间记忆存储并检索过去内容;长上下文状态空间模型和蒸馏则延长可承载时域。两类机制可以互补,但生成更长视频与保持状态一致是不同结论。 真正的检验是:对象离开视野后再出现,是否仍为同一身份、同一位置,并保留无法确定部分的不确定性。仅出现一幅类似旧画面的新图像,不等于记忆恢复。
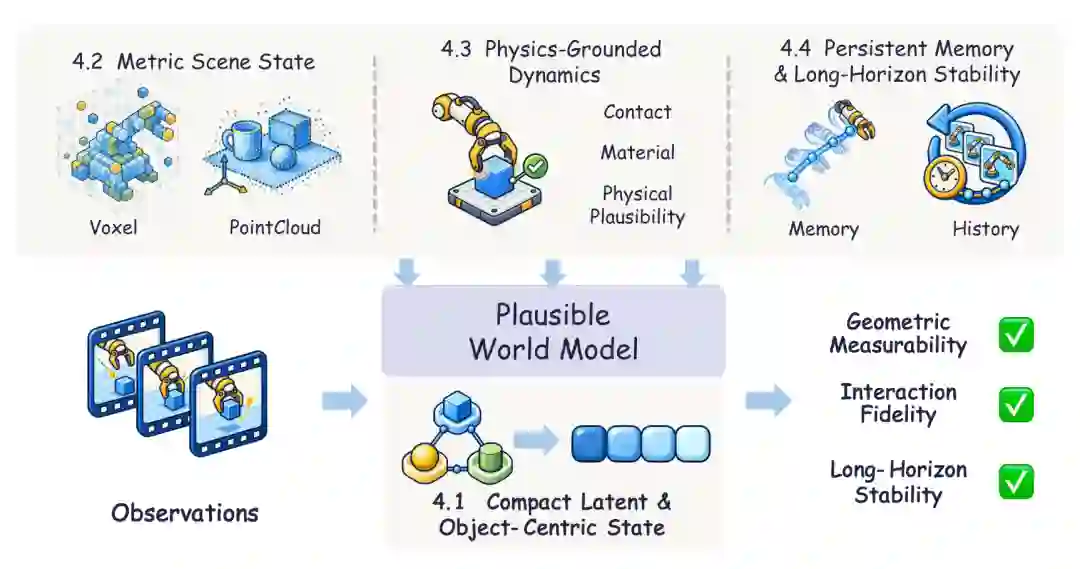
图2|可信预测层。从紧凑潜在/对象状态,到度量几何、物理交互约束和持久记忆,逐步扩展可测试的状态内容。该图是概念组织方式,不是所有模型必须具备的组件清单。来源:原文图3。
5. Controllable World Models | 可控干预世界模型
5.1 动作条件预测
模型接收电机命令、末端轨迹或驾驶动作,再预测后续状态。SAVP、FitVid、IRASim,以及驾驶领域的 GAIA-1、DriveDreamer 等展示不同接口。ACT-Bench 则将动作遵循单独作为测量目标。 接受动作输入不代表使用动作,更不代表正确执行其语义。模型可能忽略命令,仍输出自然流畅的视频,因此必须把场景真实感与命令响应分开评测。
5.2 开放、潜在与语言指定干预
Genie、LAPA、AdaWorld 等从无动作标签视频恢复潜在控制变量;其他方法用键盘、语言或目标图像指定干预,降低对平台专属标签的依赖。 语言组合和潜在动作扩大了控制集合,但命令进入模型内部单位后,实际效果更难直接测量。仍需建立潜在变量或语义意图与真实状态变化、机器人动作之间的对应。
5.3 结构落地控制:几何、轨迹与接触
相机位姿、对象路径、三维流、关节构型和接触力等变量可由外部传感器或标注测量,让请求变化与实现变化处于相同单位。MagicDrive、3DFlowAction、PIN-WM 和视觉—触觉方法体现这些方向。 对象运动接口还可以将命令与特定硬件分离,但获取几何、力或重建监督需要成本。一个可迁移的接口也仍需验证其在目标平台上的执行可达性。
5.4 交互式展开与联合世界—动作模型
交互式展开让策略根据模型生成的观测继续选择动作。Ctrl-World、iVideoGPT 等提供这样的预测环境;GR-1、PAD、UWM、WorldVLA 等进一步连接未来与动作输出。 新要求是,模型必须在策略自行访问的状态分布上保持忠实,而不只是预测数据集中记录的命令。联合训练也不必意味着推理时生成完整视频,部分设计可以直接解码动作。
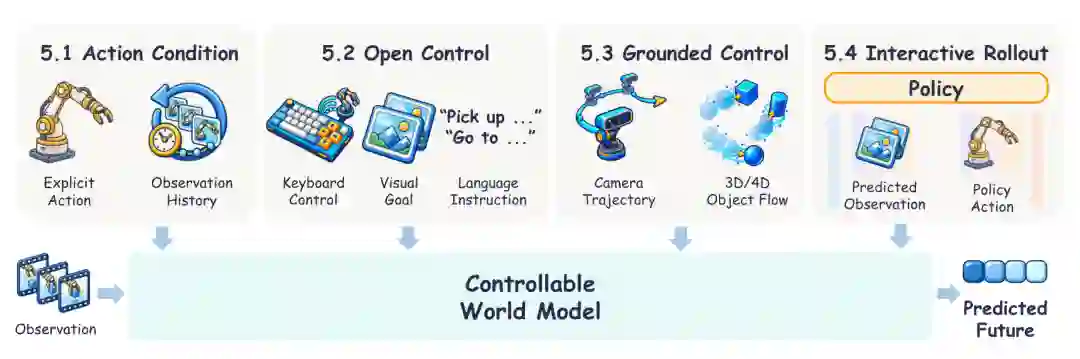
图3|可控干预层。控制从显式动作扩展到潜在、语言和目标接口,再落到可测量几何/物理变量,最终支持策略交互与动作生成。可控性要求实现变化匹配干预,同时未受影响的状态保持一致。来源:原文图4。
6. Actionable World Models | 具有行动效用的世界模型
6.1 规划、搜索与基于价值的选择
外部策略或提议器生成候选行为,世界模型预测后果,评分机制决定选择。搜索对象可以是动作、子目标、位姿或符号状态。WorldPlanner、STORM、DINO-WM 等分别探索搜索、候选策略和特征空间规划。 效用不只取决于平均预测误差,还取决于是否保留了决定候选排序的关键差异。每个候选都会消耗模型调用,因此必须在固定预算下报告成功、规划遗憾和延迟。
6.2 从想象中学习策略与解码动作
预测可以作为预训练目标提升样本效率,也可以把生成未来转换为动作,或通过未来嵌入约束策略内部表示。FLARE、JEPA-VLA 等体现无需显示未来的预测策略;DreamZero 等世界—动作模型连接两种输出。 ForeWAM、Fast-WAM 等研究进一步追问,收益来自训练时的预测结构,还是运行时显式想象。能否省去渲染未来,应由行为收益与延迟共同决定。
6.3 用于策略训练与评估的学习仿真器
在训练用途下,策略进入想象环境并依据奖励更新,要求模型对策略实际访问的状态保持可靠。在评估用途下,模型需要给出与真实执行一致的策略排序和结果估计。 WorldEval、WorldGym、WorldArena 等探索生成式评估与功能测试。重要边界是:训练策略的同一个模型不能单独为该策略提供独立认证,因为策略可能已经优化到模型误差上。需要真实结果、固定审计或独立验证信号。
6.4 运行时验证、纠正与恢复
论文区分四种逐渐增强的声明:诊断失败原因;在执行中检测失败;修改尚未发出的动作;回到可以继续任务的状态。只有报警不等于成功纠正,更不等于恢复。 CheckVLA 等比较预测与观察转移,FAWAM 等以末端力/力矩捕捉图像难以显现的接触错误。VLA-Corrector 等截断过时动作并生成后缀,CycleVLA 等则回退到早期子任务。预测残差因此成为控制信号,但必须及时到达,并统计误报、额外动作和恢复代价。
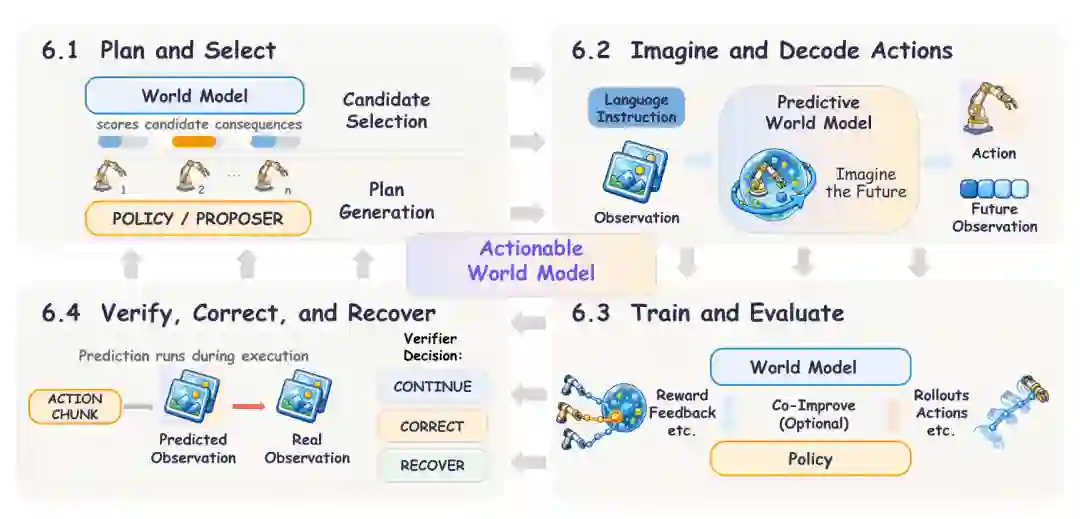
图4|行动效用层。预测可支持候选选择、动作解码、策略训练/评估,以及运行时验证、纠正和恢复。四个区域代表替代性的功能位置,不是必须串联执行的固定流程;箭头表示阅读顺序。来源:原文图5。
7. Four Improvement Loops | 四种改进闭环
7.1 数据闭环
世界模型通过获取、生成和筛选轨迹改变训练经验。DreamGen、GigaWorld-0 扩展合成覆盖,Dream2Fix 等生成配对失败与纠正轨迹,帮助补充成功示范缺少的监督。 一次生成数据不等于持续误差驱动采集。闭环应证明后续样本针对预测盲区,并用独立检查验证覆盖。典型失败是数据逐渐收缩到当前模型擅长生成的场景;有效性应按单位真实交互带来的留出能力提升衡量。
7.2 奖励与评论家闭环
预测被压缩为进展、可行性、回报或风险分数,用于提供密集反馈。RISE 将动力学和进展价值联系起来,世界模型式评论家则利用未来结构支撑价值估计。 危险在于策略学会满足评分器,而非完成真实任务。平均评分准确也可能颠倒最重要的两个候选,因此要在策略生成动作上检验预测评分与真实结果的排序和校准。
7.3 策略闭环
想象轨迹用于标注、练习、筛选或规划行为。World4RL、WoVR 和 WorldSample 等讨论如何使用不完美动力学,并选择哪些合成经验进入训练。 模型支持范围的门槛过严会丢弃有用经验,过松会接受不可信状态。应报告被接受的想象数据比例,并在匹配采样和计算预算下测量目标环境回报,避免只在模型内部改善。
7.4 模型自身闭环
预测误差或验证结果触发参数、状态、记忆或不确定性的修正。更强架构本身不是闭环,更新必须针对诊断出的弱点。RLVR-World、World Action Verifier 和 World-VLA-Loop 展示不同反馈路径。 模型与策略交替更新会让归因困难:模型看似更准,可能只是策略避开难预测状态;策略看似更好,也可能利用了新偏差。应同时检查诊断失败上的增益和固定审计集上的退化,持续改进需要多个更新周期的证据。
8. Embodiments and Domain Transfer | 具身平台与领域迁移
8.1 机器人操作
接触、摩擦、抓取位姿和力轨迹决定操作成败。触觉、点云和末端力预测使视觉难以表达的错误显现。长任务还要求诊断失败并找到可恢复状态。 测试应覆盖刚体与可形变物体、单臂与双臂、正常与扰动执行,并记录子任务进展,以区分规划失败、执行失败和恢复失败。
8.2 自动驾驶
道路几何、多智能体意图、交通规则和自车控制必须共同保持。多个安全未来都可能成立,因此单条记录轨迹的偏差不宜成为唯一标准,概率应覆盖可行未来并保留关键风险。 闭环报告应包括路线完成、碰撞、舒适度、违规、人工干预和延迟,罕见事件单独统计。生成式仿真器与真实道路行为的一致性,也是评测可信度的一部分。
8.3 导航与探索
导航要求地点和对象离开视野后,空间信念仍然稳定,并能处理回环和视觉混淆。未来可见性、可通行性和目标进展比地图画得多完整更直接影响行为。 基准应将地图准确度与导航效用分开:完整地图不一定带来更好选择,紧凑信念也可能足够支持目标到达和探索。
8.4 运动与控制
运动控制受控制时钟约束,关注短时域身体动力学、地形接触和稳定性。紧凑状态常比视频解码更合适,效用由回报、跌倒率、约束违反和地形适应衡量。 慢速视觉预测可服务高层规划,快速动力学模型负责底层反馈。分层系统需对齐状态时间戳和不确定性,并分别报告感知、预测、规划与控制频率。
8.5 哪些能力能够跨平台迁移
表示、动力学、动作语义和决策逻辑是不同迁移对象。对象恒存和自由空间可能较易共享,接触动力学需要考虑材料、工具和执行器差异;同一语言目标也不代表相同动作实现。 可采用三个协议:固定任务换机器人;固定机器人换对象、场景或动力学;同时改变二者。每项都应说明冻结和适配模块,以及消耗的真实转移数量。共享接口与测得迁移效果是两个声明。
9. Data, Benchmarks, and Evaluation | 数据、基准与评测
9.1 数据要求
轨迹应连接初始状态、观测、动作、时间及结果,还可包含目标、相机标定、深度、本体状态、力、声音、奖励、失败起点与恢复结果。RoboNet、Open X-Embodiment、BridgeData V2 和 DROID 提供不同动作对齐资源。 跨平台使用必须保留控制频率、坐标系和原始动作定义,归一化向量不自动构成共享干预。成功示范不足以训练恢复,应补充失败原因、可恢复状态、纠正动作和最终结果。可重置仿真器支持同状态不同动作的分支数据。
9.2 与能力对齐的评测协议
可信预测测试固定上下文下的未见轨迹,结合画质与对象、位置、深度、占用、接触等状态指标,报告漂移曲线、遮挡后记忆和不确定性校准。 可控干预测试从同一状态改变动作、时序、力或路径,并比较预测与执行。应保留未受影响区域的一致性,加入无动作、掩蔽、打乱和错误动作对照,以检验模型是否真正使用命令。 行动效用需要匹配基线。规划报告成功、遗憾、调用次数和延迟;强化学习报告真实回报、交互量和约束成本;策略评估报告真实结果排序相关性;验证报告精确率、召回率、误报与检测延迟;恢复报告条件成功、保留进展、耗时和安全违反。
9.3 基准设计原则
预测状态应尽可能在可执行环境中验证;同起点开放动作分支;画质与功能分开报告;扰动可重复;记录墙钟时间与模型调用。额外相机、特权状态和额外计算都应计入资源条件。 不确定性需按时域和动作检验,并报告固定覆盖率下风险。生成样本的多样性不等于可信不确定性:样本必须覆盖可行结果,并保留其风险关系。
10. Open Problems | 开放问题
10.1 持久状态与漂移
挑战是构建可修正的持久状态,在加入新观测时不重写已经一致的历史,并在隐藏信息无法确定时保持不确定性。遮挡—重现测试应同时追踪对象身份、位姿及质量、摩擦等物理属性,记录错误何时出现和能否修复。
10.2 动作的因果效应
专家会根据环境选择合适动作,使动作与结果存在混杂。模型可能复现常见结果却忽略命令。需要固定初始状态、单变量动作扰动和失败分支,并在跨机器人时同时检验高层意图与平台特定实现。
10.3 预算约束下的决策效用
动作响应正确的模型仍可能太慢,或错过改变候选排序的小差别。未来应研究保留价值、可行性和安全信息的决策压缩,并在固定计算预算下测试规划遗憾,比较视频、潜在、对象和三维接口何时有效。
10.4 联合落地
几何、物理和动作模块需要在状态、时间与不确定性上保持一致,而非仅拼接特征。应测试轴间冲突:空间可达但抓取不稳,物理可行但违反指令,或坐标系改变后动作失效。这比单独验证每个模态更能揭示接口问题。
10.5 不确定性与稳定闭环
策略更新会改变访问状态,让旧校准失效。低置信度时,系统需要明确采取缩短预测、保守评分、采集数据、切换策略或停止等行为。 四种闭环也可能让错误循环传播:合成数据带入伪影,评分器奖励伪影,策略进一步寻找伪影。应经过多个更新周期测量收益、退化、多样性和真实交互成本,并保留生成器不能查看的动力学与失败审计集。
10.6 评测、可获取性与可复现性
共同评测层可测状态稳定、干预一致、决策遗憾、校准与闭环效用,领域层再加入接触力、跌倒、地图或驾驶指标。真实实验应报告足够试验和不确定性,覆盖变异与罕见失败。 异步系统还需明确时间戳、已提交动作前缀、取消规则和延迟契约,测试可变推理时间与传感器延迟。复现材料应包含动作接口、数据过滤、计算预算、种子和失败案例;仅发布权重不足以复现能力声明。
11. Conclusion | 总结
世界模型对具身智能的价值,取决于预测如何改善行为。本文提出的三层能力,将状态一致性、干预保真度与下游效用分开;三乘四矩阵进一步说明预测内容如何进入持续学习与执行。 这套框架支持能力声明的定性比较,但不同文献的异质评测限制了直接性能比较。未来进展需要在明确的数据、计算与延迟预算下,证明落地预测能够改善闭环行为,并通过独立测试维持改进闭环的稳定性。 论文主页:https://arxiv.org/abs/2609.16697 原文 PDF:https://arxiv.org/pdf/2609.16697 项目页面:https://3dagentworld.github.io/EmbodiedWM/
综述 | 生成式物理人工智能:五类模型、系统架构与落地挑战
导读
生成式人工智能正在从生成文本和图像,走向生成机器人动作、连续轨迹和环境未来。但这一步并非简单地给大模型接上机械臂:物理系统需要同时处理感知误差、接触动力学、执行延迟、硬件约束和安全反馈。模型“理解了指令”,与机器人“可靠完成任务”,之间仍有完整的系统链条。 《A Comprehensive Review of Generative Physical Artificial Intelligence》围绕生成式物理人工智能(GPAI)整理这一链条。作者提出五类模型:机器人基础模型、视觉—语言—动作模型、大行为模型、扩散策略模型和世界基础模型,并从系统组件、跨领域应用、挑战与未来方向分析它们如何协同。 这篇综述的阅读价值在于将不同研究放进感知—认知—执行闭环:世界模型可以提供预测和合成数据,扩散策略负责动作生成,行为模型提供运动先验,通用机器人与视觉—语言—动作模型连接任务理解和控制。五类并非五套互不相关的机器人,而是可在同一系统中组合的功能路线。
本文沿用原文七个主体章节及小节顺序,配图截取自论文,图内保留原文,图注使用中文。对原文产业示例,区分应用背景、机器人辅助与生成式自主控制,不将企业产品或演示本身视为通用自主能力已被验证;不同来源的性能数字也不作横向排名。 论文信息
英文题名:A Comprehensive Review of Generative Physical Artificial Intelligence 作者:Satyam Gaba、Krutiksinh Rana、Siva Sai、Vinay Chamola、Dusit Niyato。 作者单位涉及 Qualcomm Research、University of the Cumberlands、BITS Pilani、新加坡国立大学和南洋理工大学;论文注明 Satyam Gaba 的工作在其 Qualcomm 职务之外完成。PDF 共 25 页,包含 8 幅图。arXiv 首次提交于 2026 年 9 月 16 日。 论文主页:https://arxiv.org/abs/2609.18111 原文 PDF:https://arxiv.org/pdf/2609.18111 期刊来源链接(arXiv 页面所列):https://doi.org/10.1109/JIOT.2026.3671268
I. Introduction | 引言
1. 从传统系统演进
原文将 GPAI 描述为利用大规模生成模型,为自主物理系统合成动作、轨迹与环境预测。研究目标是以多模态预训练和交互学习减少任务专属工程,扩大跨对象、跨任务和跨机器人适应能力。 传统机器人架构可分为层级式、反应式与混合式。层级式按感知—规划—执行顺序处理任务;反应式强化感知与动作的快速耦合;混合式让任务规划与即时执行并行。现代生成式系统延续这种分层思想,以语言或多模态模型承担任务理解,用动作模型及反馈控制负责物理执行。 这不意味着传统控制被替代。关节限制、逆运动学、执行器动态和高速反馈仍是落地基础,生成式模型需要通过这些接口才能作用于真实环境。
2. 市场采用与产业影响
论文引用市场预测和仓储自动化案例,说明劳动力、效率和柔性生产需求推动了物理 AI 的产业兴趣。此类市场预测具有条件性,机器人部署规模也不等于 GPAI 技术覆盖规模。 更具体的落地问题包括系统集成成本、操作流程改造、安全验证和人员适应。商业价值应从目标场景的可靠性、生产效率和维护成本判断,而不能仅凭模型参数量或行业预测推断。
3. 相关综述
既有研究分别关注生成式操作、物理感知、机器人基础模型、世界模型或具身学习。本文尝试将架构、数据、应用及部署风险放在同一视角下,补充只讨论单个模型领域的综述。 这种综合组织有助于了解功能关系,但分类中的模型范围存在交叉,部分案例来自不同发展阶段。需要把作者提出的组织框架与领域已有统一定义区分开。
4. 贡献与范围
原文的主要工作包括:整理端到端系统组件;提出五类 GPAI 模型;介绍代表架构与基准;覆盖驾驶、制造、医疗、人形、物流、智慧基础设施和消费/研究应用;分析数据、硬件、迁移、推理和安全风险;提出数据高效、模块化、边缘计算与治理方向。 论文属于综合文献综述,不提供一套覆盖所有领域的新统一实验。因此,其案例用于说明研究和部署问题,不应解释为所有路线已具备同等成熟度。
II. Components of GPAI | 系统组成
1. 具身载体
系统由认知、感知、执行与反馈共同组成,机器人形态可以是机械臂、移动平台、无人机或人形机器人。载体决定可访问的传感信息和可执行的动作,也决定模型需要满足的动态与机械约束。 真实与仿真数据参与训练,执行结果被记录并用于评价,反馈重新进入感知或数据处理。这里的“闭环”既包括控制中的在线修正,也包括部署数据驱动的后续模型更新,二者的时间尺度不同。
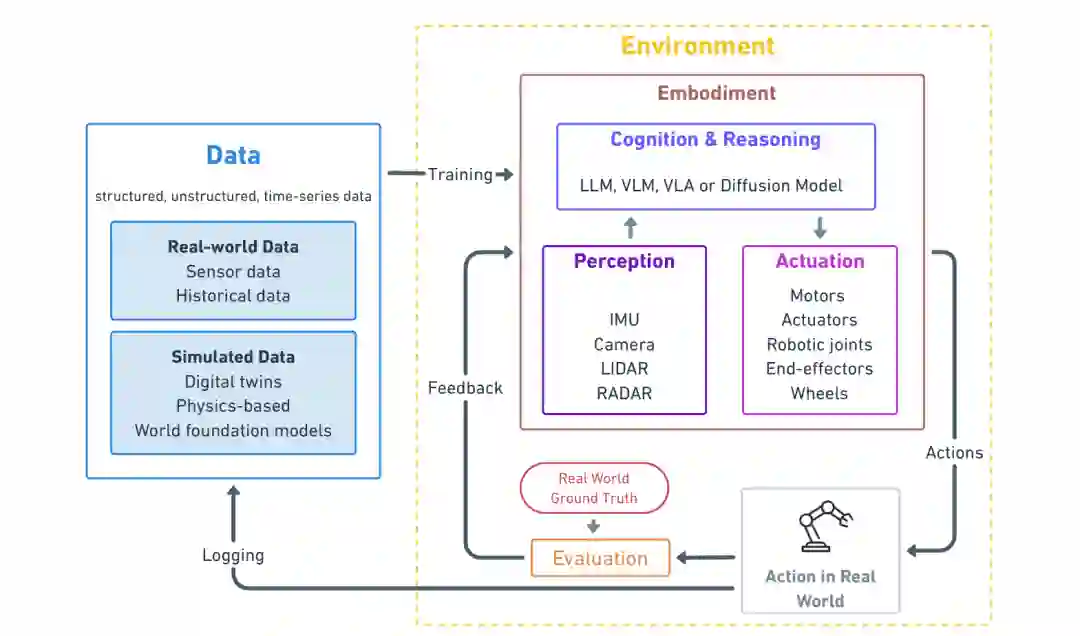
图1|系统闭环。真实与仿真数据支持训练;感知、认知推理和执行构成具身系统;执行结果与参考信息比较后形成反馈,并通过日志回流到数据层。来源:原文图1。
2. 认知与推理
语言模型负责解析任务、拆分步骤和表达高层意图,视觉—语言模型将对象和空间关系与图像对齐。以“拿起桌子左侧的红杯子”为例,系统需识别动作、目标描述与位置,再联系现场感知和执行约束。 视觉—语言—动作模型尝试在统一策略中生成动作,扩散模型则可以用于计划或动作候选的迭代生成。但语义理解不自动保证正确轨迹,还需通过可执行接口和反馈检验。
3. 执行
高层意图经过轨迹处理、逆运动学和底层控制,转换成位置、速度或力矩指令。工作空间、碰撞、关节限位、奇异点、运动平滑性和能耗都可能影响可执行性。 对于直接输出末端或关节动作的学习策略,底层控制同样需要处理扰动、机械柔顺性和执行器误差。模型输出与真实运动之间的接口是系统可靠性的重要边界。
4. 感知
相机、深度、激光雷达、惯性和雷达等提供环境观测,本体编码器描述机器人状态,触觉与力信号补充接触、表面和抓取稳定性。 视觉可支持避障和跟踪,本体信息支持姿态与协调,触觉使系统在抓持易碎物体时调整力度。多模态价值来自互补信息,也要求时间同步和一致的状态解释。
5. 数据基础
数据包括传感流、人类或遥操作示范、状态—动作轨迹、仿真与数字孪生数据,以及连接文字、视觉和动作的多模态记录。真实数据保留噪声、失败和物理复杂性,但采集依赖硬件与人工;合成数据可扩展场景,却受仿真和模型误差影响。 结构化记录便于监督精确技能,视频和语言等非结构化资料拓展表示,实时流支持上下文反馈。数据规模应与任务、平台、对象和动态多样性共同考虑;合成标签也需验证与实际动作后果一致。
6. 学习范式与反馈机制
强化学习通过交互奖励优化策略,层级强化学习将长任务分解为不同时间尺度的子任务。人类或 AI 反馈可以补充偏好信号,但评价者本身也可能存在偏差。 监督与示范学习更直接地获取技能,却受训练覆盖限制;无监督学习发现表示结构;自监督学习从未来状态和跨模态预测构造训练信号。物理仿真、数字孪生与域随机化支持训练和扰动测试,但最终仍需真实反馈确认迁移效果。
7. 基础设施与评测框架
LIBERO、RLBench 等提供操作任务协议,Open X-Embodiment 等提供跨机器人数据,二者用途不同。基准成功率有助于比较,但不能完整代表现实鲁棒性。 除任务完成,还需要评估扰动、失败预测、接触限制、恢复和实时性。对于联网传感器、执行器和边缘设备组成的系统,计算与通信基础设施也是性能条件的一部分。
III. Taxonomy of Generative Physical AI | 生成式物理人工智能分类
原文按功能将五类模型归入生成式控制、动作策略生成和数据生成三组。分类强调互补:策略可以包含扩散动作头,也可以用世界模型提供训练数据或规划上下文。
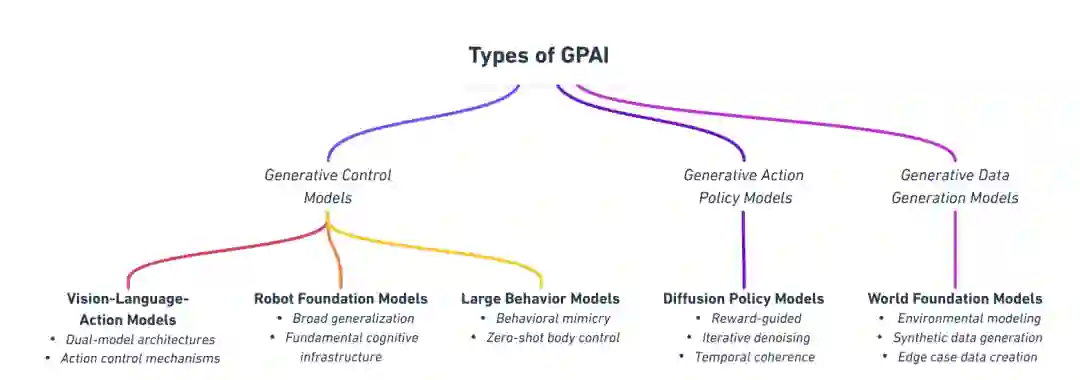
图2|五类模型与功能分组。机器人基础模型、视觉—语言—动作模型和大行为模型连接控制功能;扩散策略关注动作生成;世界基础模型关注环境建模与数据合成。来源:原文图2。
1. 机器人基础模型
# 多模态架构框架
机器人基础模型(RFM)从跨任务和跨平台数据中学习通用能力。原文架构由视觉、语言、传感和动作相关编码器提取特征,经时间对齐、投影与注意力融合为统一表示,再由动作接口服务不同载体。
# 模型类别与方法
作者对比专用模型与通用模型:前者在固定场景和技能上优化,计算与数据要求相对可控;后者扩大共享表示和能力范围,但需要更多数据及适配。跨平台迁移始终受动作空间、形态和传感配置差异限制。
# 代表性通用模型
PaLM-E 将具身观测引入语言模型表示,用于多模态理解和高层规划,其文本计划仍需外部执行接口。Gato 将不同任务转为序列建模,在同一网络中处理多种输入输出。语言模型也可以作为任务分解和代码生成模块,但高层规划模型不应直接等同于底层机器人控制器。
2. 视觉—语言—动作模型
# 架构定义
视觉—语言—动作模型(VLA)将视觉、指令与机器人状态连接到动作策略。原文突出视觉—语言模块加动作生成模块的结构;实际架构可采用统一标记生成或独立动作专家,不宜将“双模型”视为所有 VLA 的必要条件。
# 多模态处理流程
图像、语言和本体状态分别编码并投影到可交互的表示空间,融合后由动作解码器产生离散动作标记或连续控制。输出可以对应末端运动、夹爪状态、关节动作或技能接口,训练和部署需与真实控制语义对齐。
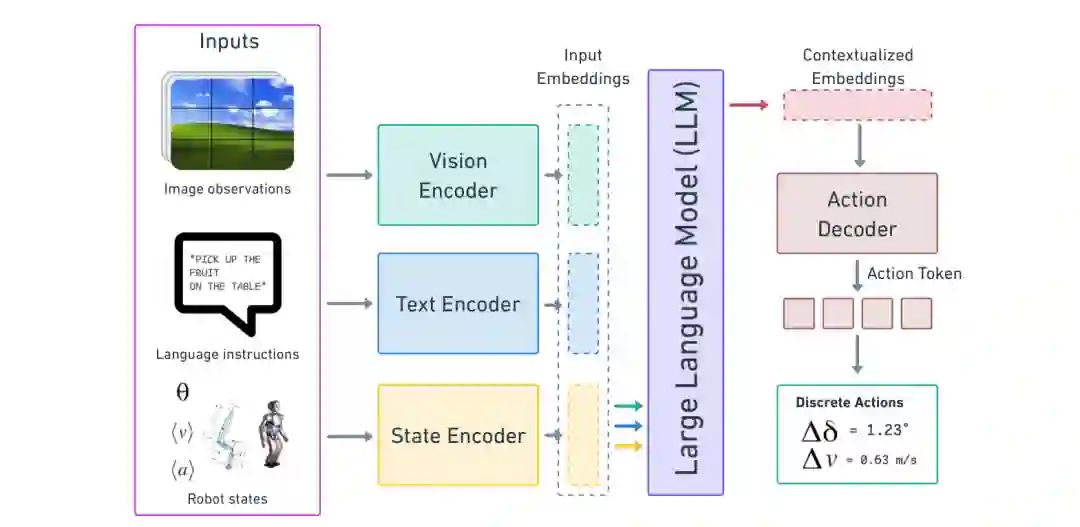
图3|原文展示的视觉—语言—动作流程。图像、指令和机器人状态先编码为输入嵌入,再生成上下文化表示,并由动作解码器转换为控制标记。该图是离散动作接口示意,并不覆盖所有连续动作实现。来源:原文图4。
# 机器人变换器一型:大规模机器人序列学习
RT-1 将语言条件视觉特征压缩后交给 Transformer,通过离散化动作产生机器人命令。其重要性在于将多任务示范、大规模训练和统一动作接口连接起来,而不是依赖每个任务独立设计策略。
# 机器人变换器二型:将动作表示为语言
RT-2 用类似文本标记的表示连接机器人动作与预训练视觉—语言知识,并结合机器人数据进行适配。这样可以把对象语义和语言先验用于动作选择,但语义迁移并不消除运动精度、硬件执行和新场景可靠性问题。
# 其他视觉语言动作实现
OpenVLA 强调开放模型、视觉特征融合和平台适配;Gemini Robotics 等研究进一步面向复杂双臂交互。它们展示不同的数据、参数和接口选择,评估时必须注明测试平台、任务与微调条件。
3. 大行为模型
# 定义与学习机制
大行为模型(LBM)关注复杂身体动作和行为序列,借助示范、运动数据和交互反馈学习行为先验。目标不仅是到达位置,还包括运动自然性、协调和行为可适配性。
# 架构与学习框架
原文示意包括行为嵌入、演员网络、经验缓存和反馈网络,分别评价运动真实性和状态转移合理性。推理阶段根据状态及潜在行为变量产生动作。运动“像人”与物理可行、任务正确是不同属性,需要分别检查。
# 代表性零样本全身控制
Meta Motivo 采用前向—后向表示和条件策略正则化等机制,从状态和潜在变量生成全身动作,并结合价值及判别反馈。此类研究展示仿真中的行为适配潜力,不应直接推断任意真实人形平台都能免适配部署。
4. 扩散策略模型
# 迭代动作细化框架
扩散策略模型(DPM)以观测为条件,将噪声动作逐步去噪为动作序列。视觉、本体状态和历史提供上下文,去噪网络学习示范动作分布,而不是对多个可能动作简单求平均。
# 架构与优势
模型常采用去噪网络生成动作块,再执行其前段并重新规划,即滚动时域控制。这有助于利用时间关联、表达多种有效策略,并在新观测到来后修正动作。但采样成本和动作块的反馈间隔需要共同设计。
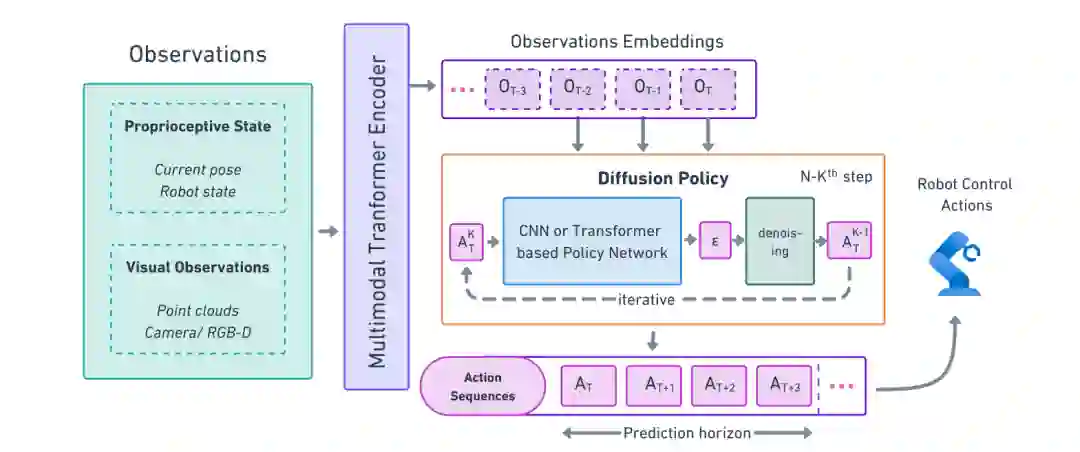
图4|扩散策略结构。历史观测嵌入作为条件,网络迭代预测噪声并细化动作候选,最终得到预测时域内的动作序列。来源:原文图6。
# 训练与评估
示范轨迹构成主要训练来源,RoboMimic、CALVIN、LIBERO 和 Push-T 等覆盖不同操作与时间结构。除成功率,应检验多种有效动作模式、序列平滑性、扰动鲁棒性、跨平台适配和推理延迟。 多步动作生成不自动证明长任务推理或安全稳定,模型也不会仅因使用扩散就避免所有分布偏差。评测需要把生成优势落实到指定任务和条件。
# 近期进展与集成
三维扩散策略将点云用于空间条件,扩散策略强化学习探索在奖励下进一步微调,通用机器人策略也可使用扩散动作头。与 VLA 的结合说明模型家族并非互斥:同一个系统可以同时具备语义条件和扩散动作生成。
5. 世界基础模型
世界基础模型(WFM)根据观测表示和可选动作预测未来图像、视频、潜在状态或传感变量。预测表示通常不是完整物理状态,因而要考虑部分可观测和误差累积。 训练流程包括时间同步、分段、过滤、编码与条件预测。自回归和扩散是两类生成机制,各自在序列组织、采样质量和成本之间取舍;不能仅凭机制名称判断效率。 控制中,规划器提出候选动作,模型预测结果,成本、奖励及约束帮助选择执行动作。随后重新感知和规划;也可把规划结果蒸馏成策略,或利用想象经验优化策略。
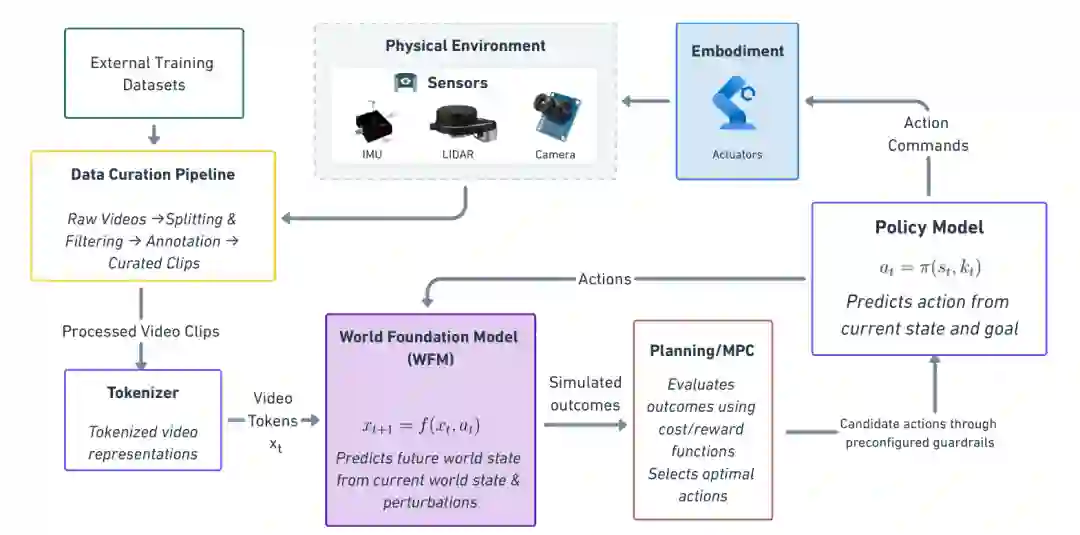
图5|世界基础模型的训练与控制。传感数据经整理和标记化用于预测学习;规划器比较候选动作的想象后果,策略与执行器实施选中动作,真实反馈回流到数据层。来源:原文图7。
# 环境仿真与数据生成
数字孪生提供结构化、可解释的虚拟系统及物理约束,世界模型补充学习式观测或残差动力学。二者可以结合,但视觉真实感不等于接触、摩擦和执行延迟已经准确建模。 物理相关损失和约束可以减少不合理预测,仍需通过任务与真实系统验证。合成数据可扩展稀有场景,但应检查动作后果、事件有效性与分布覆盖,防止模型偏差进入下游策略。 原文以 NVIDIA Cosmos 为平台案例:Predict 面向未来预测,Transfer 将结构化条件转换为可控场景,Reason 支持分析、整理和标注。不同组件在数据与控制流程中承担不同角色。
# 评估与基准
评测需同时考虑生成质量、时间稳定、条件遵循、物理合理性和下游效用。WorldScore 组织可控性、质量与动态评价,WorldModelBench 强调指令与物理遵循,WorldSimBench 结合感知评价和视频到动作的功能测试。 这些维度不能被单一画质分数替代。对规划或数据生成用途,还应检验模型是否改善实际决策和策略,而不是只给出令人信服的样例视频。
6. 分类综合与讨论
机器人基础模型与 VLA 追求更广泛的任务连接,大行为模型、扩散策略和世界模型提供行为、动作或环境方面的专门能力。综合趋势是通用理解与专业控制协同,而不是所有功能交给同一种网络。 数据组成、动作接口、机器人形态、学习目标和算力共同决定系统范围。模型家族名称可以帮助定位功能,却不足以说明泛化强度和部署可靠性。
IV. Applications of GPAI | 应用
1. 自动驾驶与辅助驾驶
应用涉及多模态交通理解、轨迹生成、风险预测及稀有场景合成。论文讨论 Wayve 等世界模型与驾驶案例。辅助驾驶、预测研究和完整自主驾驶具有不同操作边界,评估需结合真实交通闭环、延迟和风险,不能仅靠离线预测。
2. 工业机器人与制造
柔性装配、分拣、协作和质量检查需要在变化工件与环境下维持精确控制。语言条件和基础表示可降低任务配置负担,世界模型与数字孪生支持预先测试。 原文的 KUKA、ABB 等案例说明工业机器人应用背景,并不自动证明具体产品采用了某种生成式基础模型。生产评估应同时关注节拍、良率、停机与人机协作条件。
3. 医疗与医疗机器人
多模态与示范学习研究有望支持手术辅助、康复和个性化交互。原文列举 da Vinci、Hugo 和外骨骼等作为医疗机器人背景。 机器人辅助手术不能等同于生成式自主手术;平台临床使用也不能直接证明大模型控制可靠。医疗场景要求把专业监督、操作权限、组织接触精度与系统验证条件讲清楚。
4. 人形机器人与人机交互
人形系统连接语言理解、身体状态、全身协调和动作生成。GR00T 等模型探索语义与动作模块配合,运动控制研究则关注动态稳定和仿真迁移。 人与机器人交互还涉及语言、手势和用户偏好。演示、遥操作、仿真结果和现场自主运行应分开判断,不能由少数展示推断开放环境的持续自主能力。
5. 物流、仓储与供应链
拣选、搬运、包装和动态调度要求处理多种对象及变化需求。基础模型可能改善操作适应,系统规划则优化任务和路径分配。 论文引用 Amazon 等自动化案例作为规模化需求背景。仓储效率来自流程、设备和软件共同作用,不宜将综合效率数字全部归因于 GPAI 模型。
6. 数字基础设施与智慧系统
数字孪生支持工厂、仓库和城市场景的规划、维护及测试,生成模型可以扩展视觉条件和罕见事件。BMW 虚拟工厂等示例说明虚拟—物理流程的潜力。 这类系统的作用可能是规划和检验,而不直接控制执行器。应明确仿真、建议、操作决策和物理执行之间的边界及数据回流机制。
7. 消费服务与研究应用
家务、生活辅助、零售服务和实验室自动化需要自然交互与多步骤执行。原文讨论 RoboRXN 等 AI 与机器人实验平台,体现任务规划、实验执行和结果反馈的连接。 从实验流程自动化走向开放式自主发现,还需要验证计划的可执行性、异常恢复和结果可追溯性。服务场景也必须处理对象和用户行为的不确定性。
V. Challenges | 挑战
1. 数据稀缺与需求
物理数据不仅要量大,还要涵盖动作后果、多步交互、精细动力学和失败事件。采集依赖昂贵硬件、专业操作与标定,罕见危险事件尤其难覆盖。自监督、迁移和合成数据可减少负担,但不能替代所有真实验证。
2. 偏差与伦理问题
训练分布偏斜会影响对不同环境、对象和使用者的响应,偏差可能从识别进入物理行动。论文主张结合数据多样性、可解释、人类信任和包容性评测,而非只追求成功率。人类或 AI 反馈也需检查一致性与偏差。
3. 硬件与实时约束
大视觉—语言骨干和多步去噪与边缘设备的存储、功耗及延迟预算存在冲突。量化、剪枝、蒸馏和边缘—云协同提供优化方向,但压缩后要重新检查精度、泛化和动作稳定性。通信开销与最坏延迟也是系统成本。
4. 仿真到真实迁移与不确定性
质量、摩擦、接触、柔顺性、传感噪声和执行器误差难被完全建模。仿真中的优秀策略可能在真实条件下失败。域随机化、物理约束和校准能够缩小差距,仍需真实执行与持续监测,尤其不能将模拟人形动作直接视作硬件能力。
5. 泛化、提示敏感性与推理
新机器人存在关节限制、传感与动力学差异,新任务则要求理解对象关系和长期后果。指令表达变化可能引起动作不一致,持续微调还可能遗忘旧技能。多任务、元学习与持续学习需要配合保留任务和分布外测试。
6. 扩展性与系统复杂度
规模扩展不是只训练更大网络,还需协调感知、推理、规划和控制的表示、时间尺度及接口。局部错误可能跨模块传播。模块化和层级化帮助隔离问题,但需要清晰的数据与执行契约,并验证整体闭环。
7. 鲁棒性、安全与失败模式
动作离散化可能降低精细控制分辨率,随机动作生成的经验成功也不等于形式化稳定保证。原文讨论控制屏障函数等运行时过滤方向,其保证依赖模型、可行性和控制假设,不能自动覆盖基础模型所有行为。 评测需包含接触力、约束违反、恢复时间和失效保护。规划与监控失败可能叠加,安全措施应能及时限制或停止执行,并记录失败原因。
8. 透明性与可解释性
复杂模型不易诊断,既要知道输出了什么,还要定位失败来自感知、语义、计划、动作接口还是硬件。可追溯日志和模块级评价可以支持审计,但自然语言解释不自动构成真实决策依据。
9. 能源效率与环境影响
训练和推理消耗计算资源,移动系统还受电池与散热限制。效率评估需要兼顾计算、执行能耗与可靠任务完成,避免仅优化生成吞吐量。更小模型、复用表示和有针对性的采样有助于降低成本。
VI. Future Directions | 未来方向
1. 数据效率与学习方法
自监督、迁移和少样本方法有望降低标注与示范需求,数字孪生和仿真提供可控覆盖。研究应衡量在减少真实交互后是否仍保持能力,并检查合成数据在新动态条件下是否有效。
2. 基础模型与模块化架构
未来系统需要在共享表示基础上适配不同机器人,而不是假设所有形态拥有相同控制空间。可替换传感、任务和动作模块有助于复用通用知识,同时保留专用约束。跨模块因果与时间对齐将影响真正的泛化能力。
3. 计算效率与硬件进展
边缘模型优化、专用硬件和分层计算支持实时推理,触觉及执行器技术补充模型无法仅靠视觉推断的精细状态。应联合设计感知频率、规划周期和底层控制,而不是分别优化网络延迟与机械性能。
4. 安全协议
原文强调持续监控、外部验证与明确治理。安全测试应针对语义错误、接触精度和失败恢复,在模型或数据更新后检查回归。长期交互学习可以支持适应,但更新后的策略仍需保持可审计的执行边界。
VII. Conclusion | 总结
生成式物理人工智能将多模态理解、动作生成和世界预测连接到真实载体。五类模型提供一张功能地图:通用表示支持任务与平台适应,视觉—语言—动作策略连接语义与控制,行为先验与扩散动作改善运动生成,世界模型扩展预测和数据能力。 真正的落地取决于这些功能能否形成可靠闭环。物理约束、数据覆盖、仿真迁移、时间预算和失败恢复共同决定系统边界。未来进展应以真实任务中的可靠性和资源成本证明,而不只依赖生成样例、参数规模或行业热度。 论文主页:https://arxiv.org/abs/2609.18111 原文 PDF:https://arxiv.org/pdf/2609.18111
在乌克兰,价值500美元的第一人称视角无人机正以极高精度摧毁价值数百万美元的坦克,而传统战机则因密集的防空火力而被边缘化(Zafra等,2024)[1]。数千英里外的红海,美国战斗机正使用成本仅为传统导弹一小部分的激光制导火箭击落胡塞武装的无人机,选择精确性与成本效益而非蛮力(Epstein,2025)[2]。这些实例凸显了一个关键问题:无人机有朝一日是否会取代有人驾驶军用飞机,成为现代空战的主要手段?
这些进展显示了一种近期趋势:无人机正成为当代战争中不可或缺且至关重要的武器。然而,尽管无人机技术进步迅速,无人机不太可能完全取代有人驾驶军用飞机。更为现实的可能是,一种将有人与无人平台相结合、各自发挥优势并相互融合的混合模式,或将成为空中力量的未来发展方向。
本文首先回顾无人机(UAV)在军事应用中的历史,从冷战时期至今。随后,评估无人机对战斗机、轰炸机、电子战(EW)和情报、监视与侦察(ISR)系统等各类作战飞机构成的威胁与可能性,并评估无人机整合或替代的可能性。最后,审视这一转变带来的更广泛影响,包括人类判断的重要性、成本以及将无人机纳入国家安全战略所面临的政策挑战。
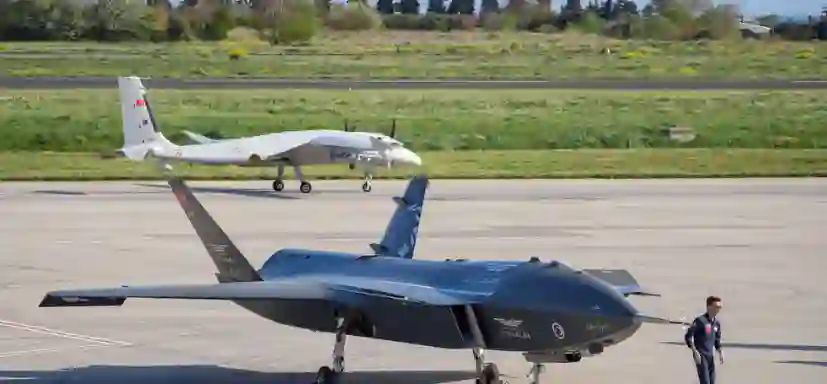
无人机的崛起:演进与当前能力
要理解无人机如何塑造未来空中力量,首先有必要简要回顾其历史演进。无人机在军事中的首次使用可追溯至第一次世界大战,但直到冷战时期才开始投入实战。尽管当时无人机技术存在局限,美国仍开始研发无线电遥控侦察无人机,以期在不危及飞行员的情况下收集情报,并于20世纪50年代末最终部署。“火蜂”是当时最著名的无人机之一,它在东南亚执行了数百次监视任务,成为冷战时期空中间谍活动的象征(Piesing,2024)[4]。由于“火蜂”及类似平台依赖无线电信号,其航程受限且易受干扰(调查新闻局,未注明日期)[5]。然而,它们能够在不引发全面冲突的情况下获取敌方领土上的图像,这使其成为无声但至关重要的情报武器(Tyagi,2023)[3]。
21世纪初,无人机战争从监视平台向武装精确打击工具转变。MQ-1“捕食者”于20世纪90年代首次研发,配备“地狱火”导弹以打击高价值恐怖分子头目,在美国阿富汗和伊拉克行动中发挥了关键作用(Marino,2024;McNeil,2025)[6][7]。这扩大了对敌区域的覆盖范围,并通过使军队能够远程打击而降低了飞行员风险。MQ-9“死神”作为更大、更具杀伤力的替代品,可携带更多弹药并在更高高度维持更长时间的打击行动(大英百科全书,未注明日期)[8]。到2010年代中期,无人机已完全融入美国反恐战略,但也开始引发关于伦理、监督责任以及战争中自主水平的辩论(Vyas,2020)[9]。
如今,无人机日益自主化,并具备多角色能力,远胜于早期的监视平台。这些新能力正成为当代军事行动的关键。新一代无人机,如MQ-28“幽灵蝙蝠”和XQ-58“女武神”,被设计为与战斗机并肩飞行的“忠诚僚机”,能够执行精确打击、电子战和监视等任务——所有这些都独立进行,以降低飞行员风险(Marino,2024)[6]。为许多此类系统提供动力的人工智能正逐步提升其实时判断、飞行中数据分析、目标识别、避障、任务计划变更以及适应对抗性环境的能力,且只需最少的人为干预(Oledcomm,2024;Surender,2024)[10][11]。
无人机蜂群和巡飞弹药正日益被用于以数量压倒对手,并制造持续的威胁存在。美国陆军宣布了“效果计划”并投资“未来战术无人机系统”(FTUAS),旨在部署模块化无人机直接支援旅级作战(Lima,2024)[12]。这些平台正在改变各域部队的作战方式。能够干扰雷达、破坏通信和欺骗敌方防御系统的无人机在电子战中的作用日益增强,尤其是在支援有人作战方面(Surender,2024)[11]。它们还越来越多地用于争议环境中的医疗后送、补给和通信中继任务(Lopez,2017;Keller,2024)[13][14]。这表明,这些技术进步正在影响当代空中力量的构成与运用方式(Caspi,2024)[15]。
当前的作战规划严重依赖执行电子战、情报收集、精确打击和通信任务的现代军用无人机;情报、监视与侦察仍是核心战略能力。诸如RQ-4“全球鹰”等系统可在6万英尺以上高度飞行超过30小时,提供持续的大面积监控,而无须使人员面临危险(Marino,2024)[6]。MQ-9“死神”和“弹簧刀”600等无人机提供精确打击能力;后者还作为巡飞弹药,可根据请求悬停、定位并摧毁时效性目标(Caspi,2024)[15]。
按平台分类的风险评估
鉴于无人机能力的快速进步,评估其对不同飞机类别潜在影响至关重要:本文将讨论战斗机、轰炸机、电子战和情报、监视与侦察飞机。该评估基于两个不同标准。整合风险衡量无人机作为有人系统的补充被纳入某平台作战的深度,而不一定取代它们。相反,替代风险衡量无人机完全取代该角色中有人平台的可能性。由于深度整合并不一定意味着最终替代,反之亦然,特定平台类别在两个轴上的得分可能不同。
1. 战斗机:低风险替代,高风险整合
美国空军正通过“协同作战飞机”(CCA)计划等举措,将无人机整合到战斗机作战中,该计划将F-35和F-22等有人平台与XQ-58“女武神”和MQ-28“幽灵蝙蝠”等半自主无人机配对(Ross,2023;Frias,2025)[16][17]。这些“忠诚僚机”执行情报、监视与侦察、电子战和打击任务,从而延伸飞行员的作战范围,同时减少暴露于敌方火力。无人机蜂群也正被测试用于压制敌方防空(SEAD)任务,以多种廉价威胁饱和对手雷达。
然而,无人机缺乏近距离格斗所需的态势感知能力,且在实时威胁优先级排序方面存在困难,尤其是在混乱的空战场景中(Ross,2023)[16]。尽管人工智能擅长快速计算和自适应机动,但人类飞行员在判断力、创造力和压力下的领导力方面仍表现更优。正如玛丽·卡明斯等专家所指出的,无人机在航程、覆盖范围和支援方面最具价值,而非用于传统格斗角色(Ross,2023)[16]。
未来,无人机将通过提供延伸航程、降低风险和实时协调等战术优势,日益支援战斗机中队,但人类飞行员仍将在复杂作战中实现空中优势和提供任务指挥方面发挥不可或缺的作用。
2. 轰炸机:中低风险替代,高风险整合
无人系统正稳步成为轰炸机作战的固定组成部分,尤其是在常规打击角色中。X-47B和乌克兰远程可重复使用无人机等平台已证明,无人平台能够深入争议领土、实施打击并返回基地,在将机组风险降至最低的同时倍增出击率(Axe,2025;Skove,2023)[18][19]。此外,无人机蜂群正被用于在有载人轰炸机任务前中和敌方防空,有效为后续打击软化战场(Skove,2023)[19]。美国军队的B-21“突袭者”专为有人和无人任务设计,不仅用于隐秘核打击,还可作为互联的“天空传感器”控制无人机(Osborn,2025)[20]。
然而,尽管取得这些进展,无人机在核威慑等角色中仍存在根本性局限,这些角色需要灵活性、监督和问责,而只有人类机组才能提供。如前所述,即使在轰炸职责中,人工智能在需要解读模糊信号或作出瞬间决策的适应性环境中也表现挣扎(Pickrell等,2024)[21]。这种能力的缺失使其不太适合执行全部范围的轰炸任务。尽管无人机未来可能主导战术和常规轰炸任务,但有人轰炸机仍将对战略威慑、核打击以及敏感环境中的任务领导至关重要。
3. 情报、监视与侦察飞机:高风险替代
无人机因其续航能力、成本效益以及在高风险环境中无须危及飞行员即可运行的能力,已成为情报、监视与侦察任务的首选平台。RQ-4“全球鹰”等平台可滞空超过30小时,提供持续监视和广域情报收集,配备光电、红外和合成孔径雷达等高分辨率传感器(A&D市场报告,2023)[22]。无人机正日益配备多传感器融合能力,并能够将实时情报输入网络化指挥系统,使其在覆盖范围和飞行持续时间上优于许多有人情报、监视与侦察飞机(MAG航空航天,2024;Caspi,2024)[23][15]。
然而,技术局限依然存在。大型情报、监视与侦察无人机易受电子战影响,包括全球定位系统干扰和欺骗,且它们缺乏分析人员带来的解读智能和灵活性(MAG航空航天,2024)[23]。虽然自主性正在提高,但当前系统在模糊条件下综合多源情报时仍表现困难,而人类判断在此仍至关重要(Molloy,2024b;MAG航空航天,2024)[24][23]。
随着情报、监视与侦察日益转向无人机主导,在未来十年内,完全取代RC-135“铆钉”联合等有人系统似乎很可能,尤其是对于常规监视任务。然而,至少在可预见的未来,人类主导的平台可能仍会存在于高度敏感或政治紧张的行动中(Harper,2022)[25]。与战斗机、轰炸机和电子战飞机不同,情报、监视与侦察领域几乎没有证据表明存在有人-无人协同,因为该类别的无人机独立运行,而非延伸或配合有人平台。这使得整合极不可能,使替代成为该类别的决定性动态。
4. 电子战飞机:中风险替代,高风险整合
电子战飞机,如EA-18G“咆哮者”和EC-130“罗盘呼叫”,执行涉及电子攻击、干扰和信号情报的任务(Ellis,2025;Ross,2023)[26][16]。鉴于争议空域的风险,无人机正成为潜在替代品或补充,降低了机组危险(Molloy,2024a)[27]。无人机非常适合压制敌方防空和电子侦察,无人机蜂群能够以较低成本饱和敌方雷达和通信(Marino,2024;Surender,2024)[6][11]。它们还可自主执行长时间任务,提高作战韧性和灵活性(MAG航空航天,2024;Ross,2023)[23][16]。
然而,技术和操作局限阻碍了完全替代有人电子战飞机。无人机通常缺乏复杂电子战任务所需的功率、有效载荷和天线(Ross,2023;MAG航空航天,2024)[16][23]。在动态电子环境中,它们也难以适应,而人类操作员在此方面表现出色(Osborn,2025;Molloy,2024b)[20][24]。政策与伦理关切进一步要求对敏感行动进行人类监督,限制了完全自主(Perrin,2025;Stambamkadi,2025)[28][29]。
在未来10至15年内,无人机很可能补充而非取代有人电子战平台。无人机蜂群和自主系统将承担高风险任务,提升有人飞机的效能和生存性。混合行动将占主导,在新技术与人类判断及监督需求之间取得平衡(Osborn,2025;Surender,2024)[20][11]。
影响与挑战
考虑到这些针对特定平台的评估,显然必须应对更广泛的战略、伦理和作战影响。尽管无人机能力取得显著进步,这些系统仍易受电子战影响,包括全球定位系统干扰、欺骗和网络入侵,这些威胁已在乌克兰得到证实(Stambamkadi,2025)[29]。人工智能引导系统在快速移动、不可预测的战斗场景中表现挣扎,而这些场景需要高级态势感知和伦理判断。与人类飞行员不同,无人机依赖传感器数据和固定算法,限制了其在高风险情况下的认知灵活性和适应性(Ross,2023;MAG航空航天,2024)[16][23]。这种依赖增加了误解风险,引发了严重的法律和伦理问题,特别是关于遵守国际人道法以及区分和 proportionality 原则(Davison,2018;Stambamkadi,2025)[30][29]。因此,在争议空域,人类监督对于伦理问责和可靠决策仍至关重要(Perrin,2025)[28]。
无人系统常被视为具有成本效益,但其长期财务影响更为复杂。MQ-9“死神”等无人机单价约3200万美元,看似比有人平台便宜(Hambling,2020)[31]。然而,由于软件更新、网络安全需求和专业维护,生命周期成本上升(Surender,2024)[11]。考虑到训练、基础设施和支援,操作单架MQ-9的成本可超过1亿美元(Carter,2026)[32]。兰德公司研究表明,无人机采购和飞离成本与有人飞机规模相似,强调维持一支有能力的无人机机队仍需大量资本投入(Light等,2024)[33]。
全球对无人机日益增长的依赖正促使对手发展反无人机能力。俄罗斯等正大力投资电子战、定向能武器和先进防空系统以中和无人机(Stambamkadi,2025;Molloy,2024b)[29][24]。这种不断演变的威胁态势要求无人机设计和作战条令持续创新,以保持有效性。
将生死决策委托给机器引发了关于问责和道德责任的未解问题。随着自主性的进步,政策制定者面临越来越大的压力,要求修订既不具备全面性也不具备应对新兴挑战能力的监管框架(Davison,2018;Perrin,2025)[30][28]。使问题复杂化的是,现有的国际军备控制制度,如最初为限制导弹扩散而设计的“导弹技术控制制度”,并未预见到无人机的崛起(Davenport,未注明日期;美国国务院,2025)[34][35]。缺乏专门的、有约束力的法规使全球安全暴露于国家和非国家行为体带来的不稳定风险中(Davenport,未注明日期)[34]。
展望空中力量未来十年
讨论过去和现在的无人机时,一个自然的问题是:十年后空中力量的格局 realistically 会是什么样子?在未来十年,空中力量的塑造将较少依赖于有人飞机的替代,而更多依赖于有人和无人系统的整合。无人机预计将承担日益增长的情报、监视与侦察、打击和支援角色,而有人平台仍将对任务指挥、复杂决策和核威慑至关重要。美国空军的“协同作战飞机”计划已在开发混合中队,战斗机飞行员与“忠诚僚机”无人机协同飞行,增强在争议空域的航程、生存性和性能(Ross,2023;MAG航空航天,2024)[16][23]。到2035年,大多数先进空军可能会在前线角色中部署无人机,由人类操作员保持监督和指挥。
这种混合模式反映了现代战争的实际现实。无人机在高风险、长续航和可消耗角色中表现出色,但它们仍缺乏复杂作战所需的适应性、伦理判断和态势感知。随着人工智能的进步,这些系统将变得更强大,但长期指挥可能仍由飞行员掌握。未来,半独立无人机蜂群可能以最少监督执行大规模任务。
尽管无人机正在革命化空中力量,但它们不会取代有人飞机。相反,未来属于混合空中力量,无人机增强而非取代人类能力。关键结论很明确:人类判断在作战中仍不可替代。无人机是强大的力量倍增器,但飞行员将继续领导任务,尤其是在生命、法律和战略交汇之处。
建议
将这种平衡转化为政策,要求积极投资重塑空中力量的技术,同时保护仍必须支配它的人类判断。除此之外,大国竞争,要求加速。
为跟上步伐,应大幅增加对国防科技初创企业的投资,这些企业已展现出比传统主要承包商更快、更具成本效益的开发周期。
美国安杜里尔工业公司体现了这一转变:该公司在2026年5月以610亿美元估值完成了50亿美元的H轮融资,据报道目前正在谈判新一轮融资,估值可能接近1000亿美元,并于2026年3月获得了一份为期10年、价值高达200亿美元的美国陆军企业合同(Sacra,未注明日期;Iyer,2026)[40][41]。其“晶格”软件平台和俄亥俄州的“兵工厂-1”制造设施反映了更广泛的行业转向廉价、“可消耗”自主系统,以替代高端、难以替换的硬件。该领域还有多家公司:Shield AI(估值127亿美元)和建造自主战舰的Saronic(估值12亿美元),以及已部署定向能反无人机系统的Epirus,都是国防科技行业的一部分,该行业从2018年每年不足10亿美元的风险投资增长到2025年的超过150亿美元(ValueAdd VC,未注明日期)[42]。这些公司通过利用其他交易授权更快赢得合同,证明硅谷式的速度可以超越传统的环城采购。
无人机投资也提供了一条更快的途径来抵消另一个脆弱性。在针对伊朗的39天轰炸和防空战役(“史诗怒火”行动)后,美国导弹库存的消耗。根据战略与国际研究中心分析师马克·坎西恩和克里斯·帕克的说法,美国军队在战役期间消耗了1060至1430枚“爱国者”拦截弹,全面补充预计到2029年中期才能完成,而“萨德”系统使用量在190至290枚之间,交付将延续到2029年底(Cancian和Park,2026)[43]。另一份报告从相对角度说明了同样的消耗:估计美国消耗了战前“爱国者”库存的约65%和“萨德”库存的约38%,剩余“爱国者”拦截弹不足1000枚,“萨德”拦截弹仅234枚(Oliverio,2026)[44]。坎西恩和帕克直言不讳地总结道:“对于弹道导弹防御,没有‘爱国者’和‘萨德’的良好替代品”,并警告这些耗尽的库存为潜在的西太平洋冲突创造了脆弱窗口,因为一旦资金获批,复杂拦截弹需要三年或更长时间才能恢复到战前水平(Cancian和Park,2026;Oliverio,2026)[43][44]。相比之下,成本较低、可消耗的无人机和巡飞弹药可在数月而非数年的时间内生产和部署,在顶级拦截弹库存缓慢恢复的同时,提供了重建威慑能力的更直接方式。
即使这种整合加速,也必须坚定秉持本文的核心警示:最终致命决策权应仍以人为中心。保持这种判断,在军队与这一建设旨在威慑的对手之间保持清晰的伦理和法律区别。犯错的代价是严重的。红十字国际委员会警告,人工智能决策支持系统可在数秒内处理大量目标数据,但其速度和规模因自动化偏见而恶化,风险在于成为对机器建议的简单盖章,而非真正的人类判断(Droege,2025)[45]。分析人士同样警告,算法错误可能未被察觉地级联,将幻觉或错误情报输入目标建议,该建议在数秒内获得批准,并可能由自主无人机蜂群执行,最近伊朗一所学校发生的爆炸造成近200名儿童和教师死亡,这一风险凸显了这一点,该事件主要归因于人为错误,但被引为关于依赖未经核实的错误情报的危险的警告(Hehir,2026)[46]。这些案例说明了为什么在生死决策中,速度和规模永远无法完全替代负责任的人类监督。
最终,世界创新的速度快于公共部门传统采办周期所能吸收的速度。正如达尔文对自然选择的描述,生存青睐最能快速适应变化环境的生物体,无论其大小或初始力量如何。在空中力量领域如同在进化中一样,决定性优势属于能以最快速度将愿景转化为实际能力的力量。
A&D Market Reports. 2023. "Are Small Drones Set To Replace Traditional Airborne ISR Platforms?" A&D Market Reports, March 6. https://aviationanddefensemarketreports.com/are-small-drones-set-to-replace-traditional-airborne-isr-platforms/
Army Recognition. 2025. "US Lockheed Martin F-35 Fighter Jet Controls Drone in Flight Using AI Technologies." Army Recognition, January 24. https://www.armyrecognition.com/archives/archives-aerospace-defense/defense-news-aerospace-2025/exclusive-us-lockheed-martin-f-35-fighter-jet-controls-drone-in-flight-using-ai-technologies
Axe, David. 2025. "Ukraine's Reusable Drone Bomber Flies 1,200 Miles With a 550-lbs Bomb." Forbes, January 31. https://www.forbes.com/sites/davidaxe/2025/01/31/ukraines-new-drone-bomber-flies-1200-miles-with-a-550-pound-bomb-and-returns-to-base/
Britannica. n.d. "Military Aircraft - UAVs, Drones, Autonomy." Encyclopaedia Britannica, last updated April 18, 2026. https://www.britannica.com/technology/military-aircraft/UAVs-drones-autonomy
Cancian, Mark F. and Chris H. Park. 2026. "Rebuilding U.S. Missile Inventory: A Multiyear Project." Center for Strategic and International Studies, May 27. https://www.csis.org/analysis/rebuilding-us-missile-inventory-multiyear-project
Carter, Alex. 2026. "How Much Does An Mq-9 Reaper Cost? (And Why Losses Sting)." Military Machine, July 10. https://militarymachine.com/mq-9-reaper-cost
Caspi, Ido. 2024. "Drones in Defense: Reshaping Modern Warfare and Its Economics." Global X ETFs, November 4. https://www.globalxetfs.com/articles/drones-in-defense-reshaping-modern-warfare-and-its-economics
Davenport, Kelsey. n.d. "The Missile Technology Control Regime at a Glance." Arms Control Today, last updated March 2021. https://www.armscontrol.org/factsheets/missile-technology-control-regime-glance
Davison, Niel. 2018. Autonomous Weapon Systems under International Humanitarian Law. Geneva: International Committee of the Red Cross. https://www.icrc.org/sites/default/files/document/file_list/autonomous_weapon_systems_under_international_humanitarian_law.pdf
Droege, Cordula. 2025. "UN Security Council: We Cannot Let AI Be Deployed on the Battlefield Without Oversight and Regulation." International Committee of the Red Cross, September 26. https://www.icrc.org/en/statement/we-cannot-let-AI-be-deployed-on-battlefield-without-oversight-and-regulation
Ellis, Harper. 2025. "Electronic Warfare – Why It's the Game-Changer in Modern Warfare." DefenseFeeds, May 21. https://defensefeeds.com/analysis/weapons/electronic-warfare/
Epstein, Jake. 2025. "US Jets Destroy Houthi Drones with Rockets Cheaper Than Top Missiles." Business Insider, March 19. https://www.businessinsider.com/us-jets-destroy-houthi-drones-rockets-cheaper-than-top-missiles-2025-3
Frias, Lauren. 2025. "See the US Air Force's First Uncrewed Fighter Jets." Business Insider, March 7. https://www.businessinsider.com/air-force-first-uncrewed-fighter-jets-photos-2025-3
Hambling, David. 2020. "Why The Air Force Needs A Cheaper Reaper." Forbes, June 20. https://www.forbes.com/sites/davidhambling/2020/06/10/why-the-air-force-needs-a-cheaper-reaper/?sh=21e021c946ff
Harper, Jon. 2022. "Special Operations Command Looking to Ditch Some of Its Drones, Buy New ISR Capabilities." DefenseScoop, May 17. https://defensescoop.com/2022/05/17/special-operations-command-looking-to-ditch-some-of-its-drones-buy-new-isr-capabilities%EF%BF%BC/
Hehir, Anna. 2026. "AI Warfare Is Outpacing Our Ability to Control It." Tech Policy Press, April 3. https://www.techpolicy.press/ai-warfare-is-outpacing-our-ability-to-control-it/
Iyer, Ram. 2026. "Anduril reportedly in talks to raise funding at $100B valuation, more than 3x last year's mark." TechCrunch, July 24. https://techcrunch.com/2026/07/24/anduril-reportedly-in-talks-to-raise-funding-at-100b-valuation-more-than-3x-last-years-mark/
Keller, John. 2024. "Army surveys industry for small, unmanned aircraft with communications relay payloads to protect command posts." Military Aerospace Electronics, March 28. https://www.militaryaerospace.com/uncrewed/article/55000276/unmanned-communications-relay-command-posts
Light, Thomas, Fred Timson and Obaid Younossi. 2024. Parametric Flyaway Cost Estimating Relationships for Manned and Remotely Piloted Military Aircraft. RAND Corporation. https://www.rand.org/pubs/research_reports/RR1618z1.html
Lima, Michael K. 2024. "Munitions Modernization: The Family of Drone Munitions." U.S. Army, October 17. https://www.army.mil/article/280364/munitions_modernization_the_family_of_drone_munitions
Lopez, C. Todd. 2017 "Army Looking into Unmanned Medevac, Medical Resupply." U.S. Army, October 13. https://www.army.mil/article/195268/army_looking_into_unmanned_medevac_medical_resupply
MAG Aerospace. 2024. "The Evolution and Impact of Manned/Unmanned ISR Operations." MAG Aerospace, May 15. https://www.magaero.com/isr-operations/
Marino, Cheryl. 2024. "Send in the Drones." U.S. Army, October 17. https://www.army.mil/article/280609/send_in_the_drones
McNeil, Taylor. 2025. "How Drones Are Changing Warfare." Tufts Now, January 21. https://now.tufts.edu/2025/01/21/how-drones-are-changing-warfare
Molloy, Oleksandra. 2024a. "How Are Drones Changing Modern Warfare?" Australian Army Research Centre, Land Power Forum, August 1. https://researchcentre.army.gov.au/library/land-power-forum/how-are-drones-changing-modern-warfare
Molloy, Oleksandra. 2024b. Occasional Paper No 29 - Drones in Modern Warfare: Lessons from the War in Ukraine. Australian Army Research Centre. https://doi.org/10.61451/267513.
Oledcomm. 2024. "Explore the Future Military Drone Technology." Oledcomm, November 24. https://www.oledcomm.net/blog/future-military-drone-technology/
Oliverio, Natalie. 2026. "Iran War Depleted US Patriot Missile Stockpiles, Creating Readiness Challenges, Experts Say." Defense News, July 30. https://www.defensenews.com/news/your-military/2026/07/30/iran-war-depleted-us-patriot-missile-stockpiles-creating-readiness-challenges-experts-say/
Osborn, Kris. 2025. "B-21 Stealth Bomber Will Control Drones & Operate as 'Sky Sensor.'" Warrior Maven, January 26. https://warriormaven.com/news/air/b-21-stealth-bomber-will-control-drones-operate-as-sky-sensor
Perrin, Benjamin. 2025. "Lethal Autonomous Weapons Systems & International Law: Growing Momentum Towards a New International Treaty." ASIL Insights 29, no. 1. January 24. https://www.asil.org/insights/volume/29/issue/1
Pettyjohn, Stacie and Molly Campbell. 2025. "Countering the Swarm: Protecting the Joint Force in the Drone Age." Center for New American Security, September 10. https://www.cnas.org/publications/reports/countering-the-swarm
Pickrell, Ryan, Mia Jankowicz and Jake Epstein. 2024. "Musk Says Jets Like F-35s Are Obsolete. Drone Tech Isn't There Yet." Business Insider, November 26. https://www.businessinsider.com/elon-musk-crewed-fighter-jet-f-35-obsolete-drone-technology2024-11
Piesing, Mark. 2024. "The Secret History of Drones." National Air and Space Museum, Air and Space Quarterly Fall 2024, September 23. https://airandspace.si.edu/air-and-space-quarterly/issue-12/secret-history-of-drones
Ross, Philip E. 2023. "Has AI Spawned the Ultimate Loyal Wingman?" IEEE Spectrum, September 2. https://spectrum.ieee.org/military-drones-us-air-force
Sacra. n.d. "Anduril Overview." Accessed August 14, 2026. https://sacra.com/c/anduril/
Skove, Sam. 2023. "Army Moves Ahead on Ukraine-Style Bomber Drones." Defense One, October 4. https://www.defenseone.com/technology/2023/10/army-moves-ahead-ukraine-style-bomber-drones/390918/
Stambamkadi, Rohith Narayan. 2025. "Limitations of Drones and the Future of American Air Superiority." Institute for Security and Development Policy, February 6. https://www.isdp.eu/limitations-of-drones-and-the-future-of-american-air-superiority/
Surender, Shweta. 2024. "AI in Military Drones: Game-Changing Capabilities." Markets and Markets, September 24. https://www.marketsandmarkets.com/blog/AD/ai-in-military-drones-game-changing-capabilities
The Bureau of Investigative Journalism. n.d. "History of Drone Warfare." Accessed August 14, 2026. https://www.thebureauinvestigates.com/explainers/history-of-drone-warfare
Tyagi, Richa. 2023. "History of Drones in Conflict Zones." Geospatial World, April 3. https://geospatialworld.net/prime/business-and-industry-trends/history-of-drones-in-conflict-zones-2/
U.S. Department of State. 2025. "Missile Technology Control Regime (MTCR) Frequently Asked Questions." Bureau of International Security and Nonproliferation. https://www.state.gov/bureau-of-international-security-and-nonproliferation/releases/2025/01/missile-technology-control-regime-mtcr-frequently-asked-questions
ValueAdd VC. n.d. "Defense Tech Startups Live Tracker." Accessed August 14, 2026. https://valueaddvc.com/defense-tech
Vyas, Kashyap. 2020. "A Brief History of Drones: From Pilotless Balloons to Roaming Killers." Interesting Engineering, June 29. https://interestingengineering.com/innovation/a-brief-history-of-drones-the-remote-controlled-unmanned-aerial-vehicles-uavs
Zafra, Mariano, Max Hunder, Anurag Rao, and Sudev Kiyada. 2024. "How Drone Combat in Ukraine Is Changing Warfare." Reuters, March 26. https://www.reuters.com/graphics/UKRAINE-CRISIS/DRONES/dwpkeyjwkpm/
海军在海上为舰船补给的能力是一项关键能力,它赋予了海军维持全球前沿存在的优势。因此,海军后勤人员和规划人员有必要制定计划,确保补给船在穿越高海执行军舰补给任务时的安全。海军规划人员目前使用“海上补给规划器”(RASP)来生成补给船的优化时间表,以实现这一目标。然而,当前的“海上补给规划器”模型未考虑环境条件,也未考虑附近交战国和对手构成的威胁。海况和云层覆盖等环境条件可能影响航行期间的燃料消耗、执行海上补给的可行性以及被对手探测到的可能性。本论文扩展了先前将环境条件纳入“海上补给规划器”的研究工作,改进了用于模拟对手可探测性的计算方法,并在确定执行海上补给的给定位置和时间窗口的适宜性时考量了环境条件。纳入天气因素会产生不同的时间表,从而在燃料成本与隐蔽性之间取得平衡。
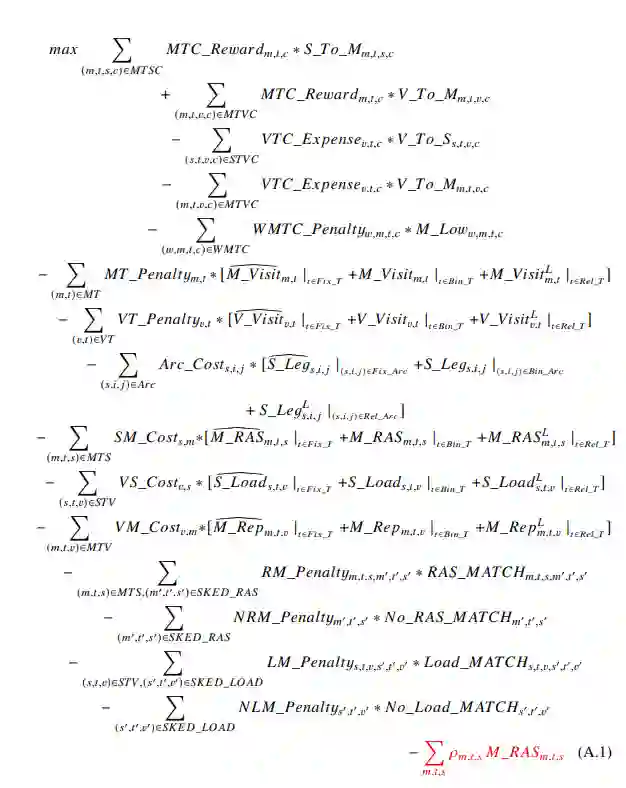
本研究探讨了在俄罗斯对乌克兰战争中,特种作战部队(SOF)如何产生战略(超常)效果。当代高强度战争表明,有限规模的作战能够产生超出其直接战术结果的影响,但现有学术研究并未充分解释此类效果是如何产生的。本研究采用定性比较案例研究设计,通过过程追踪和模式匹配对四个案例进行分析:巴赫穆特战役、黑海舰队总部打击、库尔斯克突袭和伏尔加格勒炼油厂打击。研究结果表明,战略(超常)效果并非由任何单一因素孤立产生,而是通过迫使对手适应这一机制,由预先筹划的作战设计、技术整合和效果类型三者结合而成。当作战行动迫使俄罗斯重新分配资源、调整防御态势、加强后方区域安全、改变指挥部署以及转移作战优先事项时,便产生了最为显著的效果。本研究得出结论:当作战行动迫使对手以适应方式产生更广泛的作战和系统性后果时,战略效果便随之产生。这些发现为理解有限作战如何在当代战争中产生不成比例的影响提供了一个框架。
本研究按照从概念发展到实证分析与阐释的结构化进程展开。基础部分(第二和第三节)确立了理论框架,界定了关键概念,并概述了用于审视有限规模作战如何产生战略(超常)效果的研究设计。实证部分(第四和第五节)将该框架应用于俄乌战争中的选定案例,并进行比较分析以识别模式并评估所提出的机制。最后部分(第六节)综合了各项发现,探讨了其理论意义,并考量了这些发现对于理解特种作战部队在当代高强度战争中作用的相关性。
量子技术与人工智能(AI)均正以迅猛的速度发展。这两个变革性领域之间日益共生的关系,已在科学界和技术界引发了对其融合潜力的广泛期待。人工智能在量子研发中的作用日益显著,它促进了实验开展与系统优化。反过来,量子技术的进步也有望通过提升计算性能来增强未来的人工智能能力。除了潜在机遇之外,这种融合还可能带来新的复杂性和挑战,这些复杂性和挑战会超出技术领域,延伸至国际安全范畴。
尽管量子—人工智能融合的相关军事应用在很大程度上仍停留在概念阶段或早期开发之中,但审视这一新兴的安全维度,为前瞻性地识别潜在风险并为早期政策应对提供参考提供了契机。本入门报告基于联合国裁军研究所2025年11月举办的量子—人工智能融合网络研讨会系列的讨论以及补充案头研究,提供了量子—人工智能融合的技术概述,评估了新兴及未来的国防应用案例,并审视了潜在的国际安全影响。
人工智能在量子研发中的作用。 人工智能正日益成为推进量子计算、量子传感和量子通信能力的关键力量。在量子计算领域,人工智能驱动的工具为高效且大规模地解决长期存在的技术难题(包括量子纠错)提供了一条充满前景的路径。在量子传感领域,人工智能算法可被集成到数据处理流水线中,以帮助过滤背景噪声、增强信号清晰度并促进数据分析,人工智能增强的量子磁导航便是例证。在量子通信领域,人工智能可提升量子网络的性能和可靠性,包括减少长距离信号损耗和支援网络优化。
量子在人工智能研发中的作用。 量子技术反过来也能增强人工智能本身。通过新兴的量子机器学习(QML)领域及其他量子赋能的增强手段,人工智能模型或许能够应对更复杂的问题,提高运行效率,并拓展可行应用的范围。尽管量子机器学习有望为某些机器学习任务带来潜在优势,但预计它未来不会取代经典机器学习。量子系统预计在特定的计算密集型问题以及涉及相对小数据集的场景中最为有效,而对于大规模、数据密集的应用,经典系统已经能够高效运行。
军事领域的潜在应用。 在量子科学与人工智能交叉点涌现的技术大多处于早期开发阶段,这使得其军事影响具有高度推测性。本入门报告审视了三个高潜力的应用领域:1)不依赖卫星的导航,鉴于人工智能增强的量子导航相对成熟,这可能属于最早的军事应用之一;2)网络作战,量子机器学习可能同时强化网络进攻与防御能力;3)无人机,量子增强算法或可改善飞行路径建模与集群协调。
对国际安全的新兴影响。 随着量子技术和人工智能的持续成熟,两者的融合可能会产生一类新的能力,这是任一技术单独所无法实现的,这将对未来战场能力和战略竞争产生影响。与此同时,量子—人工智能系统可能带来诸多挑战,这些挑战会加剧围绕人工智能军事应用的现有关切,例如不可预测性加剧、决策过程不透明,以及与问责和法律合规相关的结构性困难。因此,持续的风险监测与评估工作——需要技术、政策、军事和法律领域的跨学科专业知识予以支撑——对于预判新兴风险、引导负责任的发展,并确保量子技术与人工智能的融合对国际安全作出积极贡献至关重要。
综述 | 世界—动作模型:从预测未来到机器人闭环控制
导读
机器人不仅需要理解“现在看到了什么”和“人希望做什么”,还要判断:如果执行某个动作,环境将怎样变化,这种变化是否有利于完成后续任务?视觉—语言—动作模型推动了通用机器人策略的发展,但在长时序操作、遮挡、接触交互和延迟效应场景中,仅根据当前观测生成动作仍然面临局限。 《World-Action Models for Robot Learning and Control: A Survey》围绕世界—动作模型(World-Action Models,WAMs)梳理这一问题。作者将其核心概括为:**把未来世界预测与可执行动作生成连接起来,使预测能够服务于真实控制。**文章依次讨论技术背景、架构分类、应用、数据与评测,以及开放挑战。 这篇综述值得关注的地方,不只是汇集视频生成与机器人策略方法,而是明确区分“预测看起来合理”与“预测有助于控制”。读者可以据此判断一个系统究竟在学习视觉先验、生成行动计划、合成训练轨迹,还是通过想象交互改善策略;这些用途需要不同的接口和验证证据。 本文按原论文七个主体章节组织,配图截取自原文,图内文字保留原样,图注采用中文。论文为 arXiv 预印本,以下介绍不将其中不同来源的方法结果视为统一条件下的性能排名。 论文信息
英文题名:World-Action Models for Robot Learning and Control: A Survey 作者:Zuxing Lu、Hongjia Zhai、Guanzhi Wang、Huajian Zeng、Jiaqi Yang、Jingyu Liu、Lei Cheng、Yuantai Zhang、Yuheng Qiu、Zezhou Cheng、Ivan Laptev、Danfei Xu、Benjamin Riviere、Giuseppe Loianno、Eric Xing、Xingxing Zuo。 作者单位包括 MBZUAI、Caltech、Amazon FAR、弗吉尼亚大学、佐治亚理工学院、纽约大学和加州大学伯克利分校。首次提交日期为 2026 年 9 月 13 日,论文共 19 页。 论文主页:https://arxiv.org/abs/2609.16074 原文 PDF:https://arxiv.org/pdf/2609.16074 项目资源:https://rcl-robotics.github.io/Awesome-World-Action-Models
I. Introduction | 引言
传统机器人系统通常将感知、状态估计、规划与底层控制分开实现。模块化设计便于诊断和替换,在目标、动力学和环境结构能够明确建模时仍然有效。然而,面对开放世界操作和多任务交互,手工表示可能难以适应分布变化,模块之间也可能传递和放大误差。 视觉—语言—动作模型(VLA)将视觉观测、语言指令和动作输出纳入统一策略。RT-1、RT-2、Octo、OpenVLA 等工作展示了大规模预训练与跨任务数据聚合的价值。但许多 VLA 仍主要学习“当前观测或短历史加指令到下一步动作”的映射,没有显式比较不同动作所导致的未来。 世界模型补充了这部分能力:学习环境状态如何随动作演化,从而支持想象、规划、反事实评估和策略训练。问题是,世界模型本身不等于控制系统。预测模型、规划器和策略若独立设计,可能出现预测质量与控制价值之间的错位;显式搜索也会带来计算开销和模型偏差。 WAM 试图把这些环节连接起来,可以联合生成未来状态与动作,也可以先预测未来,再通过逆动力学将状态变化转换为动作。综述因此强调四项任务:澄清概念边界,建立多轴分类,分析不同机器人领域的用途,以及整理能够验证控制价值的评测方法。
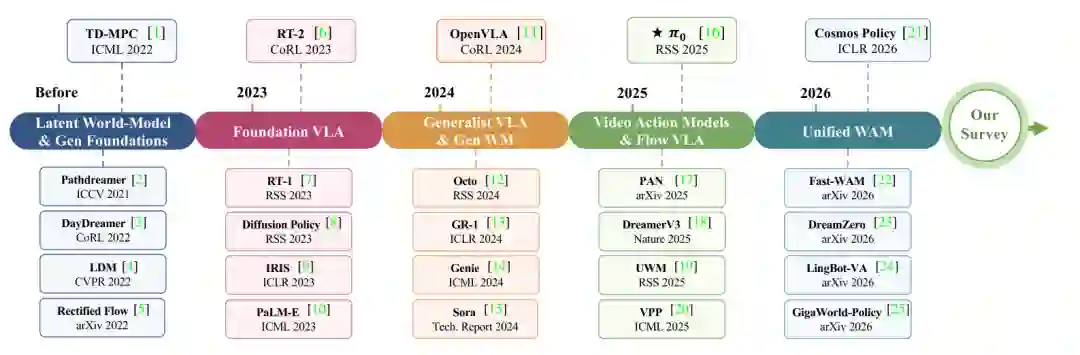
图1|世界—动作模型的发展脉络。原论文将潜在世界模型强化学习、基础视觉—语言—动作模型、视频—动作模型及近期统一模型置于同一时间线,展示预测与动作生成逐步汇合的过程。来源:原文图1。
II. Background | 从世界模型到世界—动作模型
1. 定义与概念边界
论文用部分可观测马尔可夫决策过程描述机器人与环境交互。机器人获得的是图像、本体状态和历史等有限观测,不能直接读取完整环境状态,因此需要从历史中构建可用于预测的表示。 世界模型根据当前状态表示和动作预测下一状态。它回答“执行这个动作之后会发生什么”,其输出可以是潜在状态、图像、奖励或其他任务相关变量。 视觉—语言—动作模型根据观测历史和语言任务生成动作序列,主要回答“现在应该怎么做”,不必显式生成未来状态轨迹。 世界—动作模型把未来轨迹与动作序列放入共享的学习或推理过程。它关注动作与后果的连接,而不是简单地给策略附加一个与控制无关的视频生成器。未来世界也不必以完整 RGB 视频呈现,可以在潜在特征或结构化状态空间中建模。
2. 四条基础研究路线
第一条是世界模型与基于模型的强化学习。PlaNet、Dreamer、TD-MPC 等方法学习状态转移并支持规划或策略优化。循环状态空间模型通过确定性与随机性状态共同表示历史和不确定性,既可预测观测,也可预测奖励。 第二条是视频生成模型。它们从视频历史、图像或文本生成未来视觉序列,为机器人提供丰富的场景演化先验。但视觉未来不自动构成准确的物理动力学,更不自动提供对应的机器人控制量。 第三条是潜在动作预训练。大量互联网视频没有关节、速度或末端位姿标签,潜在动作模型因此从相邻视觉状态的变化中推断抽象行为。这样的表示可能跨场景或跨机器人复用,之后仍需与目标机器人的真实动作空间对齐。 第四条是视觉—语言—动作模型。动作可以通过离散标记的自回归预测产生,也可以通过扩散或流匹配在连续空间生成。它们提供任务条件下的动作接口,与世界预测形成互补。
3. 统一生成视角
综述将相关功能拆为四项:策略生成、正向动力学、逆动力学和视觉规划。策略生成根据历史与指令预测动作;正向动力学根据动作预测未来;逆动力学根据当前与目标未来推断动作;视觉规划根据任务生成目标未来。 这四项功能不要求全部由同一个网络承担。两条主要实现路径分别是:联合建模未来观测与动作的条件分布,以及先生成未来视觉计划,再通过逆动力学推断可执行动作。这一差别贯穿后续架构、训练和部署讨论。
III. Architecture Design & Model Taxonomy | 架构设计与模型分类
1. 模型组件
论文将 WAM 分解为语言接口、视觉编码器、预测骨干和动作解码器四个功能模块。 语言编码器决定任务条件如何进入模型。CLIP 提供全局语义表示,T5 提供细粒度序列特征,自回归大语言模型则可以引入任务理解与推理能力。选择取决于任务所需的语义粒度和计算预算。 视觉编码器决定模型在什么空间预测。二维 VAE 可压缩单帧图像,但时间一致性有限;视频 VAE 联合编码时空结构;DINO、CLIP、SigLIP、视频联合嵌入表示等可用于特征空间预测。点云、占用网格和鸟瞰特征则显式表达几何结构。部分系统直接复用视觉—语言模型的骨干表示。 预测骨干可以从头训练统一 Transformer,也可以借助预训练视频生成模型。后一类方法继承丰富时序先验,但研究重点随之转向如何把生成式视觉动力学与特定机器人的控制空间对齐。 动作解码器包括三类:离散动作标记便于序列建模,但可能损失精度;潜在动作将行为与硬件控制分离,便于使用无动作标签视频;扩散与流匹配动作头直接生成连续控制,能够表达多种行为模式,但通常存在采样开销。
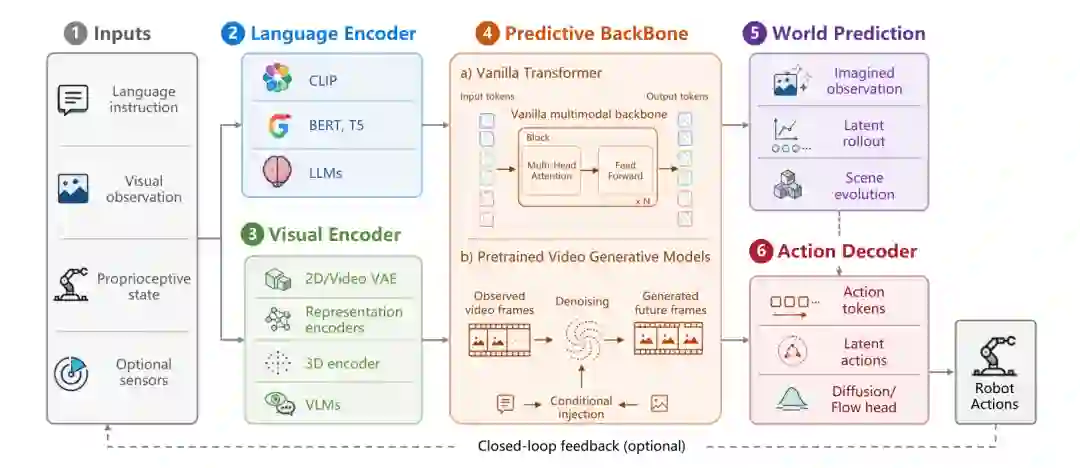
图2|世界—动作模型的组件级框架。语言接口提供任务条件,视觉编码器构建预测状态,预测骨干学习动态变化,动作解码器输出机器人控制。来源:原文图3。
2. 状态转移建模范式
联合预测在共享过程中生成动作与未来观测。GR-1、GR-2 采用序列建模,UWM 等采用视频与动作的扩散建模,WorldVLA 等探索统一标记空间。未来预测既可能用于执行时的前瞻,也可能作为训练辅助信号改善动作表示。 这一范式的关键是平衡不同模态:视频生成占用的计算量和学习信号可能远大于动作输出,视觉改善也不一定带来动作精度提升。因此需要核对预测任务是否真正约束了可执行行为。 逆动力学范式先预测未来状态,再由当前状态与预测状态推断动作。它使任务级未来规划与底层控制接口相对分离。Pathdreamer、Seer、DreamZero 等体现不同程度的“先预测、后行动”设计。 论文还讨论隐式逆动力学变体。Fast-WAM、GigaWorld-Policy 等可以在训练时使用预测结构,而在推理时直接解码动作,减少在线视频生成开销。目标条件模型进一步从“下一步状态”转向更远的目标状态。由此可见,训练中引入未来预测,并不意味着部署时每次都要生成完整未来视频。
3. 架构结构
端到端系统让语言、视觉、本体状态与动作共享骨干,强调统一表示和共同优化。它便于继承大规模预训练先验,但必须处理异构标记之间的对齐,防止某种模态主导训练。 双系统将世界预测与动作生成交给不同模块,通过中间表示连接。接口可以是混合 Transformer 中的模态专属投影和共享注意力,也可以是向动作专家注入预测特征的交叉注意力。模块化有利于调整不同计算频率和平台接口,但增加了接口设计与误差协调的复杂度。 这与联合预测、逆动力学是两个独立维度:统一骨干可以实现两种转移范式,双系统也可以采用联合或分解式建模。不能把“端到端”等同于“联合预测”,或把“双系统”等同于“逆动力学”。
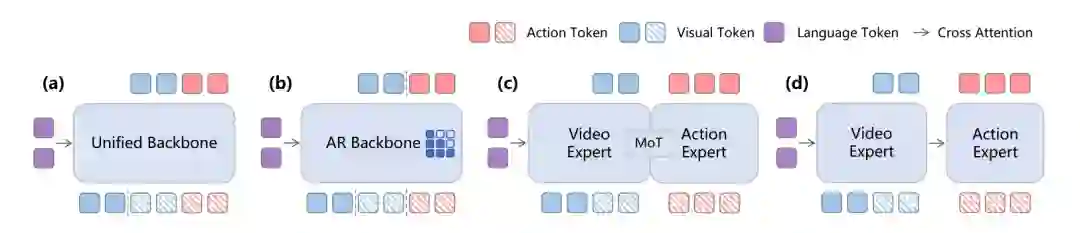
图3|架构与转移范式的交叉分类。图中分别展示统一骨干与视觉/动作专家分离,以及联合预测与预测后动作生成的不同组合。来源:原文图5。
4. 策略训练流程
预训练包括时空表示、动作表示以及视频—动作对齐。大规模视频提供对象交互与场景变化先验,多视角预训练进一步提供几何约束。动作表示可通过离散化、频率分解或潜在动作学习获得。对齐则可以同时利用正向动力学、逆动力学、动作生成和视频生成目标。 后训练包括策略微调、数据增强和强化学习。微调将通用表示适配到目标机器人的传感器、动作空间与部署条件,LoRA、轻量适配器和残差动作头可以降低调整成本。逆动力学路线还需控制预测计划与真实执行之间的偏差。 数据增强有两种不同用途。一种改变原轨迹的外观、照明或风格,同时保留任务语义及有效动作对应关系;另一种生成新轨迹,再用逆动力学或潜在动作接口恢复伪动作标签。后一种会引入额外的动作推断误差,不能仅凭视频逼真度判断合成数据质量。 强化学习可在物理仿真、真实机器人或学习到的世界模型中进行。真实交互直接面对执行条件,但成本高;物理仿真存在迁移差距;想象交互减少物理采样,却可能让策略利用模型错误。World4RL、World-VLA-Loop 等代表预测环境与策略改进的连接方向,其可扩展性仍有待研究。
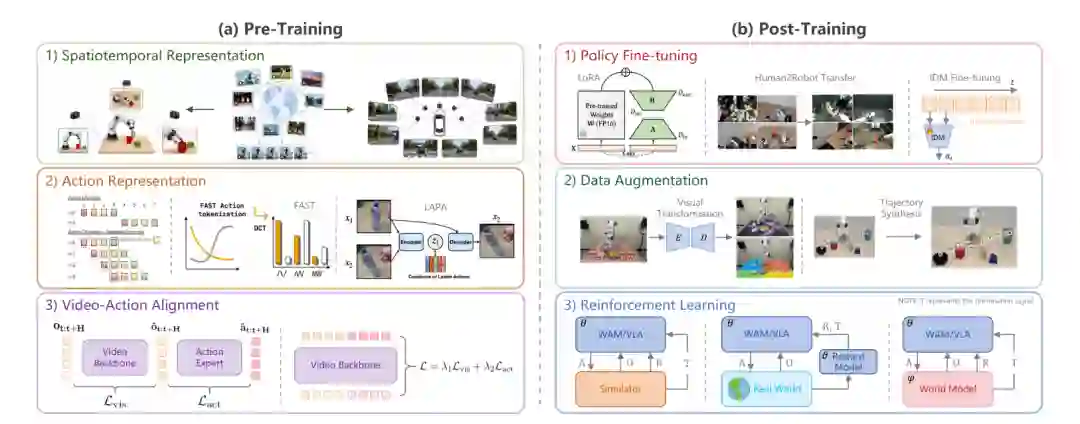
图4|预训练与后训练流程。前者学习时空先验、动作表示及二者对齐;后者通过微调、数据增强和不同环境中的强化学习适配策略。来源:原文图6。
5. 数据模态、规模与混合
语言描述高层意图;多视角视频提供环境线索;三维结构支持空间推理;触觉和声音揭示接触、柔顺性与事件;本体状态提供关节和末端等直接物理信息。模态选择会决定模型能否识别视觉难以辨认、却直接影响动作的状态。 数据来源形成一个金字塔:大量互联网视频提供宽泛世界先验,第一人称人类示范提供更接近任务的运动与交互信息,规模较小的机器人轨迹提供精确动作监督。DROID、BridgeData、Open X-Embodiment 等因此是将视觉知识落到可控执行的重要资源。 扩展数据不能只增加视频数量。无动作标签视频、任务相关示范和具身轨迹的混合比例,以及视觉变化与控制标签的对应质量,会直接影响模型学到的是一般运动规律,还是可执行的动作后果。
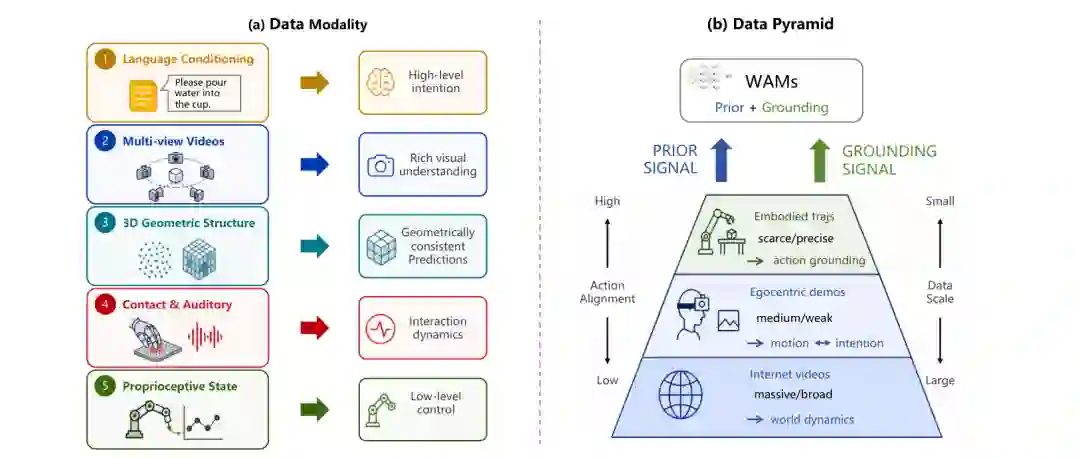
图5|数据模态与数据金字塔。左侧列出语言、多视角、三维、接触/声音及本体状态的互补作用;右侧强调大量无动作标签视频与少量具身轨迹分别贡献先验和动作落地监督。来源:原文图7。
IV. Applications | 应用
1. 机器人操作
操作任务要求预测对象状态、遮挡、接触动力学和任务进展。论文按三组介绍方法。 第一组是视频—动作与统一策略,通过未来预测塑造轨迹级动作表示,或在推理时使用预测目标。第二组是结构化状态模型,如点云、粒子和高斯表示,将预测空间向几何与物理控制变量靠近;触觉与声音进一步补充接触和材料交互。第三组将世界模型视为想象环境,用于策略优化、评估及合成失败恢复轨迹。 三组方法的共同检验标准是:预测是否改善了真实可执行控制,特别是在接触丰富、分布变化和长时序任务中。训练辅助预测有效与在线规划有效是不同结论,需要分别验证。
2. 导航
导航相对少受细粒度接触影响,却更依赖部分可观测条件下的长距离空间推理。世界模型可预测未来第一人称视图、语义地图或潜在状态,帮助选择路点。 前瞻规划方法让世界模型产生候选未来,再交给搜索或规划器选择动作。潜在规划与世界模型强化学习则减少显式图像生成,用紧凑表示支持实时命令或想象训练。腿式机器人还需要结合地形、本体状态和候选速度,预测运动结果与失败风险。 这一领域的价值体现在路点选择、长时序一致性和遮挡条件下的鲁棒性。是否输出精美图像并非判断导航能力的必要条件。
3. 自动驾驶
驾驶同时受到实时性、安全和多智能体交互约束。综述首先讨论可控视频生成及结构化场景预测:前者支持交通场景合成、数据增强与策略条件评估,后者使用占用表示预测自由空间、动态主体和潜在碰撞。 其次,统一驾驶模型连接场景预测与轨迹/动作生成,世界模型强化学习则通过想象交互改进策略。对稀有危险事件,这种能力具有吸引力,但前提是模型对动作后果及其他交通参与者反应保持可信。 因此,驾驶评测必须将视频真实感、交通一致性和闭环安全结合。记录数据上的轨迹拟合不能替代反馈执行中的碰撞、违规和舒适度评估。
V. Datasets, Benchmarks, and Evaluation Metrics | 数据集、基准与评测指标
1. 指标家族与评测协议
任务级指标包括成功率、路线完成度、驾驶分数、回合回报与任务链长度,最接近最终控制目标。但成功率提高仍需分析来自更好的预测、更强的模仿先验,还是额外训练数据。 轨迹指标包括平均/最终位移误差、导航误差、路径长度加权成功率、归一化动态时间规整,以及绝对/相对位姿误差。它们描述路径一致性,但不能单独保证闭环安全。 生成指标包括 FID、FVD、LPIPS、PSNR 和 SSIM,衡量图像或视频质量。语义、语言和占用指标用于结构化输出。延迟、碰撞、舒适度和违规次数则反映部署约束。最有解释力的报告应同时呈现预测质量、动作对应关系和下游控制效果。
2. 机器人示范与人类视频语料
DROID、BridgeData V2、Open X-Embodiment 和 AgiBot-World 主要提供动作落地监督,支持预训练和平台适配。它们与单独定义测试协议的基准并不是同一类资源。 Something-Something v2、Ego4D、EgoDex、Kinetics-700 和 HowTo100M 扩展了运动、交互与语言先验,但没有直接指定目标机器人的控制动作,其贡献通常要在动作对齐和下游微调之后衡量。不同资源以轨迹、小时、片段或类别统计规模,不能直接按数字大小比较。
3. 仿真操作任务套件
LIBERO、CALVIN、MetaWorld、RLBench、ManiSkill、RoboTwin、RoboCasa、SimplerEnv、Push-T 等覆盖语言条件、长任务链、双臂、厨房场景泛化和接触行为等不同设置。CALVIN 强调长时序任务链,Push-T 等则提供更聚焦的交互测试。 这些任务并不可互换。短时序单物体成功不等于跨场景泛化或长链可靠性。对于视频式 WAM,还需将任务成功与预测质量共同报告,避免仅展示其中一项。
4. 自动驾驶数据与仿真器
nuScenes、Waymo Open Motion、BDD100K、KITTI、Argoverse、OpenDV 等记录数据支持视觉生成、轨迹、占用和感知评估。CARLA、Bench2Drive 等用于反馈执行;NAVSIM 则采用数据驱动的非反应式/伪仿真协议,应与完整交互式仿真区分。 选择指标决定结论的含义。视觉距离改善说明生成分布更接近参考数据,轨迹误差改善说明结构预测更准确,而驾驶分数、碰撞、违规和舒适度才能进一步说明执行效用。应同时注明测试环境和协议边界。
5. 导航环境、数据与基准
Matterport3D 提供空间扫描,Habitat 提供具身仿真环境,R2R、RxR 及连续环境变体定义语言导航协议,ScaleVLN 扩展训练轨迹。真实轨迹资源则补充平台与环境差异。 成功率需要结合路径效率、目标距离与参考路径一致性解读。模型既要到达正确目标,也要在未见环境和有限观测下合理选择路径,才能体现预测规划的价值。
6. 基础强化学习基准
DMControl、Atari、Craftax、Procgen 和 BSuite 等帮助检验预测模型是否支持规划、价值学习及策略改进。但它们简化了真实机器人的传感器、接触、硬件和安全约束,不能替代具身评估。FMB 等真实操作资源通过成功率与周期时间,把方法验证重新连接到物理执行。
VI. Open Challenges and Future Directions | 开放挑战与未来方向
1. 运动意图与动作对齐
“希望发生什么变化”与“机器人怎样完成变化”是两项任务。互联网视频充足,而精确动作标签稀缺,适合先学习运动意图,再用具身数据对齐执行接口。但分阶段训练必须防止计划不可达或动作解码不准确。 同时,动作对齐可能破坏预训练视觉先验。冻结参数、对齐层和残差动作头可以限制控制相关更新,更强的抗遗忘机制仍值得研究。关键是让有限机器人数据补充执行知识,同时保留通用视觉动力学。
2. 世界与动作的因子分解
世界模型学习动作条件下的环境转移,策略学习能够提高累计收益的动作选择,两者目标不同。论文因此讨论分别训练和推理的价值:世界模型可持续改进并复用于离线强化学习、运行时规划或模型预测控制。 共同优化也可能产生问题:模型生成过于乐观的未来,策略利用这些错误而在真实环境失效。因子分解提供了控制和诊断接口,但并不自动消除模型偏差,还需要协调世界模型与策略的数据覆盖和更新过程。
3. 空间与多视角一致性
视频骨干可能在单视角上合理,却无法保持对象恒存、遮挡关系与跨视角几何一致性。这会同时破坏状态估计、规划及逆动力学解码。 点云、占用场和三维高斯等显式表示有助于把预测约束到空间结构,但要与大规模生成骨干及高效动作解码连接。第一人称示范提供手物交互线索,固定相机外参也有助于施加跨视角约束。未来方向是让不同视图描述同一个可行动的三维世界。
4. 长时序记忆
长任务需要保留进展、过去交互和暂时被遮挡的信息。简单扩大视觉窗口会增加成本并引入冗余,因此需要紧凑、选择性的记忆。 模型内记忆可以组合视频短期记忆、文本长期记忆或关键事件存储,并同时影响未来预测与动作解码。另一条路线在策略外部维护执行记录、成功规则和失败模型,支持验证与恢复。前者通常需要专门训练,后者强调模块化组织,二者都必须检验记忆是否改善长链执行。
5. 神经仿真器与闭环策略学习
模仿学习擅长拟合专家行为,却可能缺少纠偏和从失败中改进的能力。神经仿真器通过学习动作条件动力学提供想象环境,使策略在不增加同等真实交互成本的情况下接受评估和优化。 困难在于想象误差随步数累积,以及奖励和长时序信用分配是否可靠。真实强化学习受样本成本约束,物理仿真受迁移差距约束,神经仿真则受模型偏差约束。利用任务奖励、目标条件和学习奖励模型改善闭环策略具有潜力,但大规模无奖励与离线学习仍是开放问题。
6. 推理延迟与计算效率
多步采样、长预测轨迹和动作解码可能让反馈到达过晚。在动态或接触场景中,延迟直接影响控制效果,因此必须作为系统能力的一部分评测。 少步生成、一致性模型、平均流和相关流方法可减少采样成本;量化、剪枝、算子融合、蒸馏及缓存复用可降低部署开销。系统还需共同选择预测长度、候选轨迹数量、重规划频率和动作块长度。加速后的模型必须保留动作条件转移和时间一致性,不能仅以吞吐量衡量改进。
VII. Conclusion | 总结
世界—动作模型希望缩小“预测环境变化”与“生成可执行控制”之间的距离。其核心价值在于让预测参与动作选择、策略学习或逆动力学解码,并在反馈中接受验证。 这篇综述提供了一套理解相关工作的框架:先看预测空间和动作接口,再看转移范式与架构,随后考察训练数据、应用用途及评测协议。可靠的未来预测应当与动作落地对应,保持空间和时间一致性,表达不确定性,支持闭环改进,并满足实时约束。 对机器人研究而言,更有说服力的进展将来自多模态与三维表示、动作对齐、神经仿真、强化学习和真实反馈之间的协同,以及能够同时衡量任务成功、安全、鲁棒性和跨平台迁移的基准。 原文链接:https://arxiv.org/abs/2609.16074 PDF 下载:https://arxiv.org/pdf/2609.16074
导读
**
**
综述 | Towards AI That Improves Itself: A Survey of Recursive Self-Improvement
仓库链接:https://github.com/Lee1003-lee/Awesome-RSI-Research 论文链接:openreview.net/pdf?id=I3fKQbRUGy
随着大模型与智能体开始写代码、运行实验、读取反馈,甚至修改 Prompt、Memory、Workflow、模型和训练数据,AI 正逐渐从“被优化的对象”变成“参与优化过程的主体”。Recursive Self-Improvement(RSI)也因此从早期关于“智能爆炸”的理论设想,走向一个可以被构建、测试和评估的工程问题。
但一个核心问题始终没有被回答清楚:反复修改自己,是否就等于 RSI? 综述《Towards AI That Improves Itself: A Survey of Recursive Self-Improvement》围绕这一问题展开,区分 Evolution、Self-Evolution、Meta-Evolution 与 RSI 四个阶段,并提出统一的 Proposal → Feedback → Optimization 框架,用于理解现代 AI 系统如何提出改进、验证改进,并决定哪些变化值得被保留到下一轮
**
**
Introduction
传统 AI 系统的改进流程通常由人类设计和执行,包括训练数据构建、偏好优化、模型架构设计、训练策略选择以及最终评测。模型本身更多是被优化的对象,而不是优化过程的主动参与者。随着 LLM Agent 的发展,这条边界正在逐渐模糊:现代智能体已经能够修改代码、调用工具、分析失败、优化 Prompt 和 Workflow,甚至参与训练数据生成、模型训练与自动化实验。AI 开始不仅完成任务,也开始参与“如何把系统本身变得更好”这一过程。
这也使 Recursive Self-Improvement(RSI)重新成为一个现实而具体的问题。但相比“AI 能否修改自己”,更值得关注的是:一个修改是否真的构成 improvement?这个 improvement 是否会被可靠验证、保留,并成为后续 improvement cycle 的起点? 如果系统只是不断反思、重写或重复搜索,却每一轮都从相同状态重新开始,那么它更接近 iterative refinement,而不一定构成真正意义上的 RSI。
因此,本文关注的核心不只是“系统能不能产生新的修改”,而是这些修改能否经过可信的反馈与验证,被稳定地写入后续状态,并在新的任务、环境和优化周期中继续发挥作用。换句话说,现代 RSI 的关键瓶颈并不是缺少 proposal,而是缺少一套能够可靠接受、继承并迁移 improvement 的机制。也正是在这一基础上,文章进一步区分 Evolution、Self-Evolution、Meta-Evolution 与 RSI,并尝试为这一快速发展的研究方向建立统一的分析框架。
Background | 从智能爆炸到 Agentic Improvement
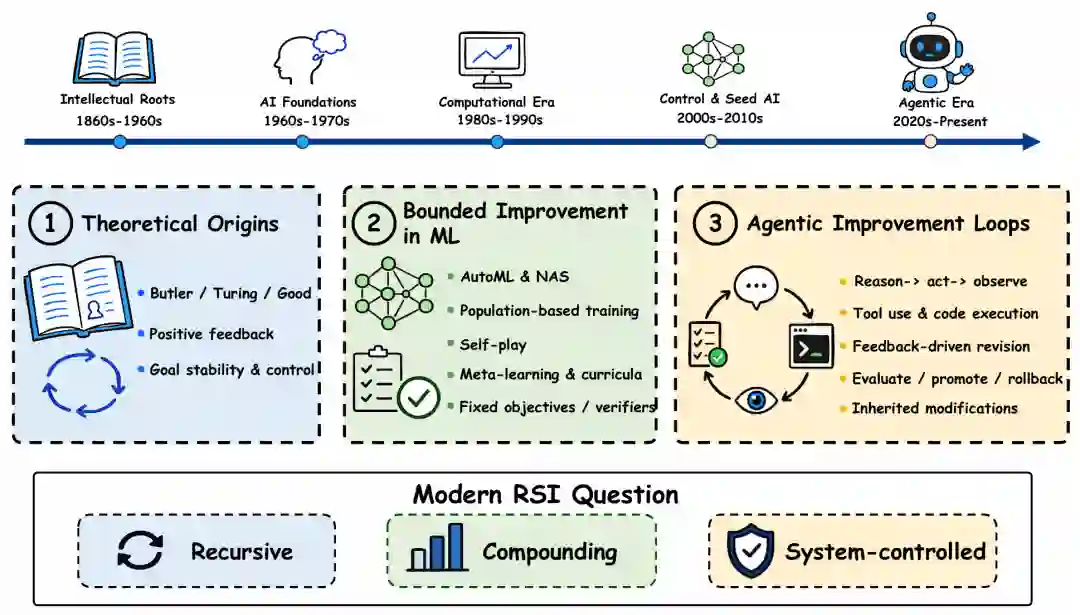
RSI 的思想可以追溯到 Butler、Turing 和 Good 关于机器自我改进与 intelligence explosion 的讨论:如果一个系统能够设计出更强的继任者,那么新的系统又可能进一步提升这种设计能力,由此形成正反馈。随后,AutoML、NAS、Self-Play、Meta-Learning 和 Curriculum Learning 等方法逐渐把这种思想转化为可执行的机器学习优化过程。
真正的变化出现在 Agentic Era。现代智能体不仅能够生成答案,还能够执行代码、调用工具、观察结果、根据反馈修改行为,并进一步调整 Memory、Workflow、Harness 甚至研究过程。因此,RSI 的研究重点也逐渐从“机器能否自己变得更聪明”,转向“一个系统能否持续产生、验证、保留并继承可信的改进”。
**
**
Definition | 什么才是真正的 RSI?
论文首先区分了四个容易混淆的阶段。Evolution 只改善当前输出或轨迹,变化不会被持续保留;Self-Evolution 会将被接受的 improvement 保留下来,并在后续任务、运行或新的交互中复用;Meta-Evolution 则进一步修改负责产生、评估或选择 improvement 的机制本身,例如 proposer、verifier、search rule 或 updater;而 Recursive Self-Improvement 要求某一轮接受的改进真正成为下一轮 improvement cycle 的起始状态,使后续优化建立在已经改进过的状态之上。
因此,论文强调:Iteration alone is not RSI。反复进行 reflection、revision、search 或 optimization,并不意味着系统已经具备 RSI。真正构成 recursion 的关键是 state inheritance:后续 cycle 必须明确继承此前已经验证并保留的 improved state,并继续从这个状态向前优化,而不是每一轮都重新从相同的 base state 开始。
进一步地,论文区分了 minimal RSI 与更强的 recursive progress。前者只要求改进能够跨 cycle 被继承;后者则要求这种继承进一步提升后续的 improvement procedure,例如让系统更有效地产生、筛选或验证下一轮改进。也就是说,系统不仅要“变得更好”,还要逐渐“变得更擅长让自己继续变好”。
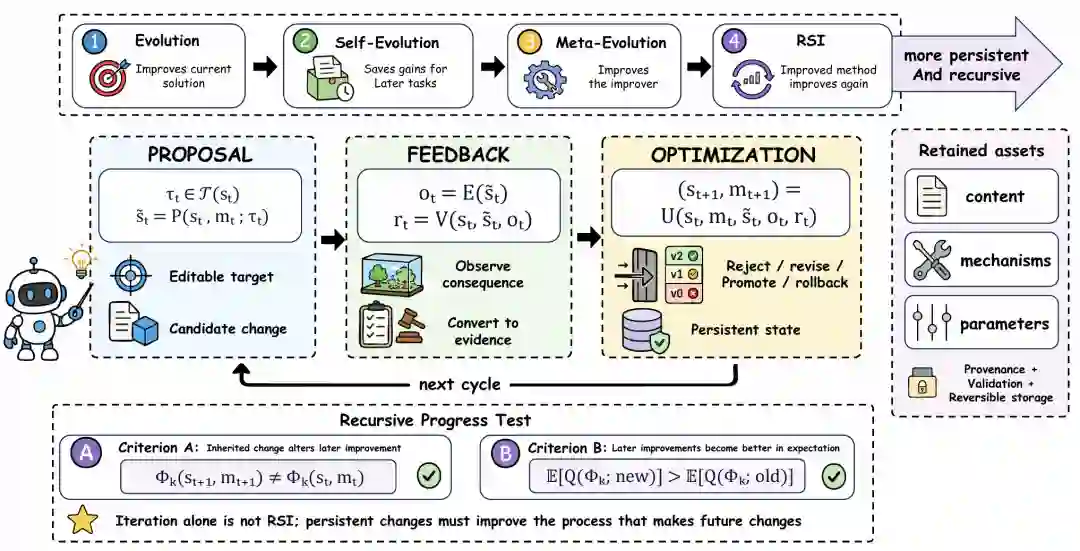
**
**
Framework | Proposal → Feedback → Optimization
为了统一不同类型的 RSI 系统,论文提出了一个三阶段闭环:Proposal → Feedback → Optimization。Proposal 决定“改什么”以及“如何产生候选改进”;Feedback 将候选方案放入环境中执行,并通过测试、Benchmark、Judge、Simulator 或人工审查将执行结果转换为 evidence;Optimization 再根据这些 evidence 决定保留、修改、拒绝、推广还是回滚该候选。
这里一个重要区别是:执行结果并不等于改进证据,验证通过也不等于可以直接更新系统。 Environment 负责暴露候选修改的后果,Verifier 负责判断这些后果是否满足目标,而 Update Policy 最终决定一个 change 是否拥有进入 persistent state 的权限。
当一个被验证的改进真正写入 Memory、Skill、Workflow、Code 或 Model,并在下一轮 Proposal–Feedback–Optimization 中再次被加载时,一个普通的 iterative improvement loop 才开始具有递归意义。
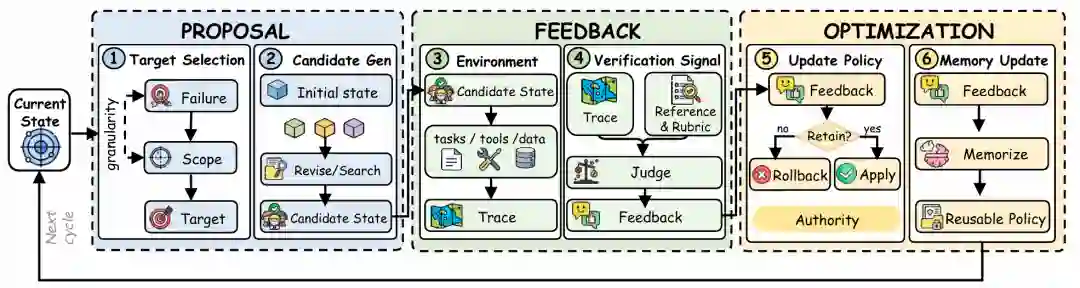
**
**
System Structure
在这一框架下,论文进一步将现代 RSI 系统拆解为六个关键组件:Target Selection、Candidate Generation、Execution Environment、Verification Signal、Update Policy 和 Memory Update。其中,Target Selection 与 Candidate Generation 构成 Proposal,分别决定“改什么”以及“如何生成候选改进”;Execution Environment 与 Verification Signal 构成 Feedback,负责让候选修改真正运行起来,并将执行结果转化为可比较的 evidence;Update Policy 与 Memory Update 则属于 Optimization,决定哪些变化被保留、修订、拒绝、推广或回滚,并将验证后的状态带入下一轮 cycle。
这种拆解的意义在于,它把“被修改的对象”和“负责产生、验证与保留修改的机制”区分开来。一个系统可以选择修改 Prompt、Memory、Workflow、Harness、Model,甚至整个 Research Process;候选改进也可以通过 textual revision、search、evolution、program synthesis 或 autonomous experimentation 产生。真正重要的并不是采用了哪一种具体算法,而是每次修改是否具有清晰的边界,能否在环境中被执行,其效果是否能够被可靠验证和归因,以及最终是否能以可追踪、可回滚的形式进入下一轮 persistent state。
Taxonomy | RSI 到底在改什么?
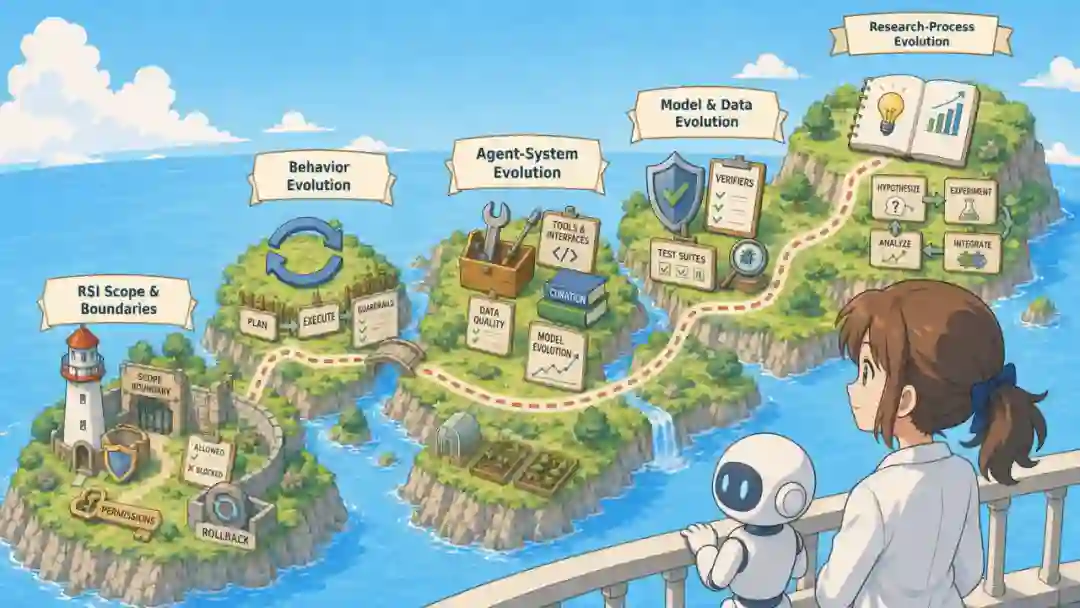
论文进一步从 Evolution Target 的角度,将当前 RSI-related research 分为四类:Behavior Evolution、Agent-System Evolution、**Model & Data Evolution **和 Research-Process Evolution。这四类方法对应着越来越大的 persistence 与 causal reach。
**Behavior Evolution **
主要作用在最局部、最直接的行为层面,修改对象包括模型输出、推理过程、搜索轨迹以及由自然语言维护的中间状态。典型方式包括 self-refinement、reflection、search-time reasoning 和 state optimization:系统先根据反馈修正当前答案或轨迹,再把有价值的 critique、search trace 或经验压缩成可复用状态。它的优点是修改成本低、反馈快,但很多改进仍然停留在当前任务或当前上下文中,只有当这些轨迹、反思或规则被进一步保留并在后续任务中复用时,才真正开始具备持久演化的意义。
**Agent-System Evolution **
进一步把修改对象从“当前行为”扩展到智能体本身的运行结构,包括 Prompt、Memory、Tool-use Policy、Workflow、Harness、多智能体协作机制以及 Runtime Components。相比一次性的输出修正,这类变化能够持续影响后续多个任务和执行周期,例如更新长期记忆、沉淀可复用技能、调整工具调用逻辑、重构工作流,或修改负责协调多个 Agent 的机制。论文特别强调,Harness 不只是一个 Prompt wrapper,而是控制工具、状态表示、执行顺序、反馈通道和发布条件的重要控制面,因此这一层的演化已经开始影响智能体“如何工作”,而不仅仅是“这一次输出什么”。
**Model & Data Evolution **
将自我改进进一步推进到训练过程内部,被修改的对象包括训练数据、Reward、模型参数以及 Curriculum。典型方向包括 synthetic data bootstrapping、self-rewarding 与 meta-rewarding、agentic post-training,以及 self-play 和 curriculum evolution。与外部 Prompt 或 Workflow 调整不同,这一层的变化会直接改变模型之后的学习和生成行为,因此具有更强的 persistence 和 transfer potential;但与此同时,credit assignment、回归检测和验证难度也显著增加,因为最终性能变化可能同时受到数据、Reward、训练过程和参数更新等多个因素影响。
**Research-Process Evolution **
则把 evolution 的范围扩展到完整的 AI R&D 或科学研究流程,不再只优化某个模型或 Agent 组件,而是将 hypothesis、experiment、evidence、research state 以及后续 research decision 都纳入可修改对象。典型系统包括 AI Scientist、Executable AI4AI / MLE、Experience Factories、End-to-End AutoResearch Loops 和 domain-specific scientific agents。这类系统可以自主提出假设、设计和执行实验、分析结果,并根据证据决定下一步研究方向,因此最接近“AI 改进 AI”的完整闭环;但它也带来了最强的验证要求,因为一个看似成功的实验并不一定意味着真实的科研进步,还需要关注可复现性、证据质量、跨任务迁移以及后续研究决策是否真的因此变得更好。
这条路径反映了 RSI 的一个重要趋势:改进对象正从局部、短暂的输出,逐渐扩展到持久、可继承、能够影响后续改进过程的系统状态。 因而,越往后走,潜在收益越大,但 verification、credit assignment、rollback 与安全控制也越困难。
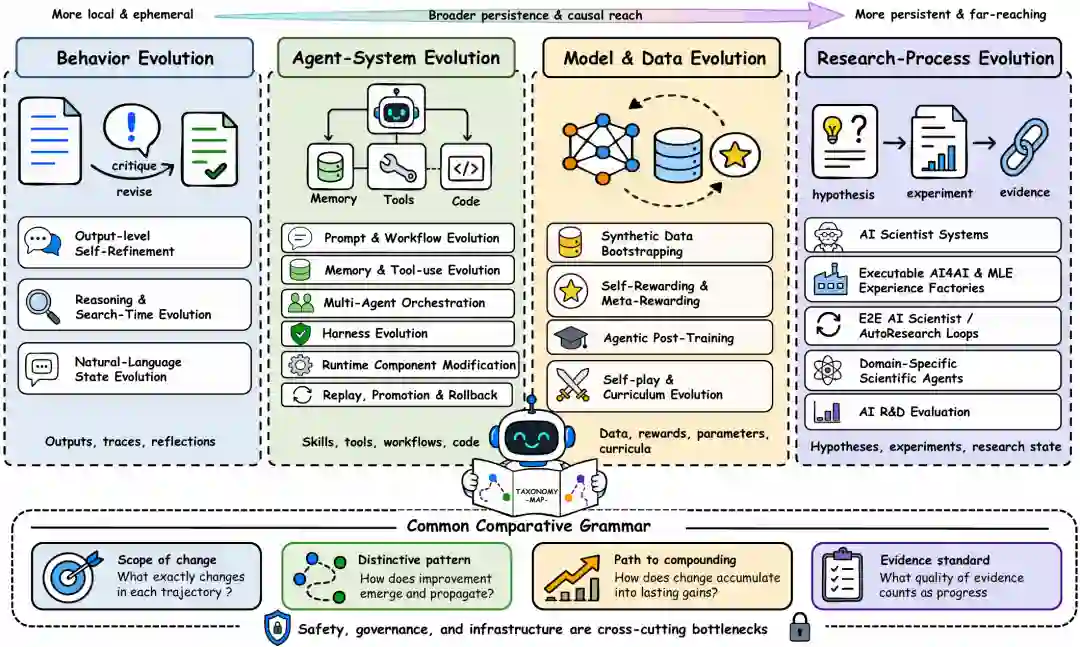
**
**
Future Directions | RSI 下一步往哪里走?
论文将未来 RSI 的关键挑战总结为七个方向:Reliability、Efficiency、Diversity、Persistence、Adaptability、Controllability 和 Generalization。它们并不是彼此独立的七项能力,而共同构成一套 evidence-oriented 的 RSI evaluation profile。
**Reliability **关注一个 change 是否真的值得被接受。RSI 的特殊风险在于,一次错误判断不会只影响当前结果,而可能被进一步写入 Memory、Skill、Training Data 或 Harness,并在后续 cycle 中持续传播。因此,未来系统需要更独立、更可验证的评估机制,包括 execution-based verification、held-out evaluation、rule/formal checks 以及必要的人类审查,避免 Reward Hacking、Verifier Exploitation 或 evaluator bias 被误当成真实进步。
Efficiency 关注 RSI 在有限资源下能否持续运转。现实中的 improvement loop 不可能无限生成和验证 candidate,因此需要在 compute、wall-clock time、human review 和 deployment cost 之间进行权衡。未来更重要的问题不是单纯追求更高 capability,而是衡量每单位资源究竟带来了多少有效 improvement,例如通过 budgeted search、selective evaluation、early stopping 和 staged release 提高整体效率。
Diversity 关注系统是否能够维持足够多样的改进路径。如果不同 candidate 都来自相同的 proposer、memory 或 verifier,它们很可能共享同样的 blind spot,最终出现 mode collapse、correlated error 或 evaluator overfitting。未来 RSI 因此需要更丰富的 hypothesis、population、archive 和 independent branches,让系统不仅“搜索更多”,而是真正探索不同的改进方向。
Persistence 关注一次 improvement 能否真正跨 cycle 留下来并持续发挥作用。对于 RSI 来说,短期得分提升并不足够,系统还需要保证被接受的 change 能够被记录、加载、追踪和复用。这意味着未来系统需要更完善的 Memory、Skill、Versioning、Lineage、Replay 和 Rollback 机制,使 improvement 从一次局部成功转化为后续 cycle 可以继续利用的 persistent state。
Adaptability 关注系统在环境变化后还能不能继续改进。真实世界中的任务、工具、数据分布和 verifier 都可能不断变化,因此静态 benchmark 下有效的 improvement 未必能够长期成立。未来 RSI 需要更强的 dynamic evaluation、verifier–environment co-evolution 以及 replayable and versioned contexts,使系统能够在 task shift、tool shift 和 environment change 下持续调整,而不是只适应固定分布。
Controllability 关注 self-improvement 是否始终处在可管理、可审计的范围内。当系统开始修改 Model、Code、Harness 或 Research Process 时,真正重要的问题不仅是“能不能改”,还包括“谁有权限批准”“修改能影响多大范围”“出现问题能否回滚”。因此,未来 RSI 需要更清晰的 authority、scope control、approval、audit 和 rollback 机制,让系统具备 improvement capability 的同时,也保留对 improvement process 的治理能力。
**Generalization **最终检验一个 improvement 是否真的具有价值,而不是只对当前 benchmark、judge 或 harness 有效。一个系统可能在固定 evaluator 下取得更高分,却并没有真正提升底层能力。因此,未来评估需要更重视 held-out task、new environment、cross-domain transfer、product deployment 和 scientific deployment,甚至进一步考察 improvement procedure 本身能否迁移到新的任务和后续 generation
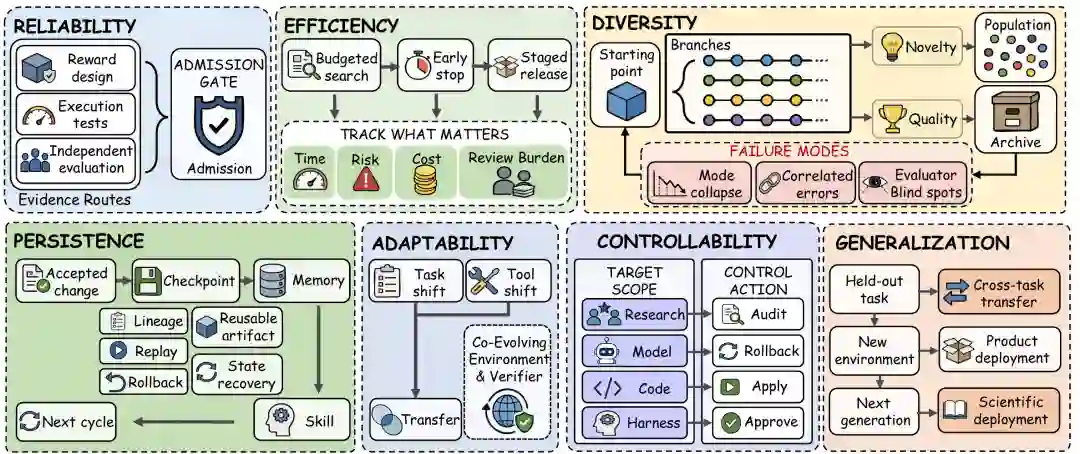
**
**
** 启示 | 从“会修改自己”到“会可靠地改进自己”**
从这篇综述的视角来看,RSI 真正困难的地方并不是让 AI 不断提出修改。今天的 Agent 已经能够生成代码、修改 Prompt、调整 Workflow、调用工具、进行搜索,甚至执行较完整的实验流程。真正困难的是:我们如何判断一个变化是否真的构成 improvement,又如何保证这个 improvement 值得被保留、能够在后续 cycle 中被可靠复用,并且不会因为错误验证、错误归因或局部过拟合而在递归过程中不断放大?
因此,真正可信的 RSI 需要的不只是更强的 proposer,而是一套完整的 improvement infrastructure:可靠的 verification、明确的 state inheritance、可追踪的 lineage、可复现的 evaluation,以及必要时能够 rollback 的 control mechanism。换句话说,系统不仅要会“提出改变”,还要知道为什么接受这个改变、这个改变影响了什么,以及它在后续任务、环境和改进周期中是否仍然有效。论文最终也将 verification 与 reliable cross-cycle transfer 视为当前 RSI 从简单递归状态继承走向真正 recursive progress 的核心挑战。
从这个意义上说,Recursive Self-Improvement 的终极问题或许并不是“AI 能不能改变自己”,而是:AI 能否持续判断什么值得改变,把真正有效的改变稳定地继承下来,并让这些改变成为下一次改进的可靠起点。 只有当 improvement 能够被验证、保留、迁移,并进一步支持后续更好的 improvement,RSI 才真正从“反复修改自己”走向“持续改进自己的能力”。




 微信扫码咨询专知VIP会员