
综述 | 生成式物理人工智能:五类模型、系统架构与落地挑战
导读
生成式人工智能正在从生成文本和图像,走向生成机器人动作、连续轨迹和环境未来。但这一步并非简单地给大模型接上机械臂:物理系统需要同时处理感知误差、接触动力学、执行延迟、硬件约束和安全反馈。模型“理解了指令”,与机器人“可靠完成任务”,之间仍有完整的系统链条。 《A Comprehensive Review of Generative Physical Artificial Intelligence》围绕生成式物理人工智能(GPAI)整理这一链条。作者提出五类模型:机器人基础模型、视觉—语言—动作模型、大行为模型、扩散策略模型和世界基础模型,并从系统组件、跨领域应用、挑战与未来方向分析它们如何协同。 这篇综述的阅读价值在于将不同研究放进感知—认知—执行闭环:世界模型可以提供预测和合成数据,扩散策略负责动作生成,行为模型提供运动先验,通用机器人与视觉—语言—动作模型连接任务理解和控制。五类并非五套互不相关的机器人,而是可在同一系统中组合的功能路线。
本文沿用原文七个主体章节及小节顺序,配图截取自论文,图内保留原文,图注使用中文。对原文产业示例,区分应用背景、机器人辅助与生成式自主控制,不将企业产品或演示本身视为通用自主能力已被验证;不同来源的性能数字也不作横向排名。 论文信息
英文题名:A Comprehensive Review of Generative Physical Artificial Intelligence 作者:Satyam Gaba、Krutiksinh Rana、Siva Sai、Vinay Chamola、Dusit Niyato。 作者单位涉及 Qualcomm Research、University of the Cumberlands、BITS Pilani、新加坡国立大学和南洋理工大学;论文注明 Satyam Gaba 的工作在其 Qualcomm 职务之外完成。PDF 共 25 页,包含 8 幅图。arXiv 首次提交于 2026 年 9 月 16 日。 论文主页:https://arxiv.org/abs/2609.18111 原文 PDF:https://arxiv.org/pdf/2609.18111 期刊来源链接(arXiv 页面所列):https://doi.org/10.1109/JIOT.2026.3671268
I. Introduction | 引言
1. 从传统系统演进
原文将 GPAI 描述为利用大规模生成模型,为自主物理系统合成动作、轨迹与环境预测。研究目标是以多模态预训练和交互学习减少任务专属工程,扩大跨对象、跨任务和跨机器人适应能力。 传统机器人架构可分为层级式、反应式与混合式。层级式按感知—规划—执行顺序处理任务;反应式强化感知与动作的快速耦合;混合式让任务规划与即时执行并行。现代生成式系统延续这种分层思想,以语言或多模态模型承担任务理解,用动作模型及反馈控制负责物理执行。 这不意味着传统控制被替代。关节限制、逆运动学、执行器动态和高速反馈仍是落地基础,生成式模型需要通过这些接口才能作用于真实环境。
2. 市场采用与产业影响
论文引用市场预测和仓储自动化案例,说明劳动力、效率和柔性生产需求推动了物理 AI 的产业兴趣。此类市场预测具有条件性,机器人部署规模也不等于 GPAI 技术覆盖规模。 更具体的落地问题包括系统集成成本、操作流程改造、安全验证和人员适应。商业价值应从目标场景的可靠性、生产效率和维护成本判断,而不能仅凭模型参数量或行业预测推断。
3. 相关综述
既有研究分别关注生成式操作、物理感知、机器人基础模型、世界模型或具身学习。本文尝试将架构、数据、应用及部署风险放在同一视角下,补充只讨论单个模型领域的综述。 这种综合组织有助于了解功能关系,但分类中的模型范围存在交叉,部分案例来自不同发展阶段。需要把作者提出的组织框架与领域已有统一定义区分开。
4. 贡献与范围
原文的主要工作包括:整理端到端系统组件;提出五类 GPAI 模型;介绍代表架构与基准;覆盖驾驶、制造、医疗、人形、物流、智慧基础设施和消费/研究应用;分析数据、硬件、迁移、推理和安全风险;提出数据高效、模块化、边缘计算与治理方向。 论文属于综合文献综述,不提供一套覆盖所有领域的新统一实验。因此,其案例用于说明研究和部署问题,不应解释为所有路线已具备同等成熟度。
II. Components of GPAI | 系统组成
1. 具身载体
系统由认知、感知、执行与反馈共同组成,机器人形态可以是机械臂、移动平台、无人机或人形机器人。载体决定可访问的传感信息和可执行的动作,也决定模型需要满足的动态与机械约束。 真实与仿真数据参与训练,执行结果被记录并用于评价,反馈重新进入感知或数据处理。这里的“闭环”既包括控制中的在线修正,也包括部署数据驱动的后续模型更新,二者的时间尺度不同。
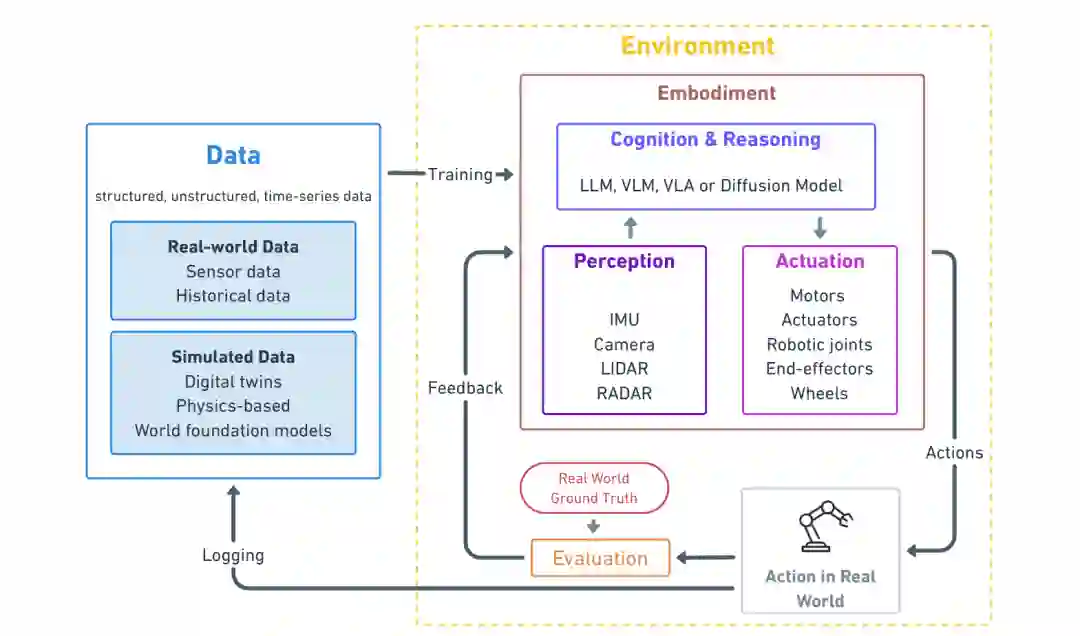
图1|系统闭环。真实与仿真数据支持训练;感知、认知推理和执行构成具身系统;执行结果与参考信息比较后形成反馈,并通过日志回流到数据层。来源:原文图1。
2. 认知与推理
语言模型负责解析任务、拆分步骤和表达高层意图,视觉—语言模型将对象和空间关系与图像对齐。以“拿起桌子左侧的红杯子”为例,系统需识别动作、目标描述与位置,再联系现场感知和执行约束。 视觉—语言—动作模型尝试在统一策略中生成动作,扩散模型则可以用于计划或动作候选的迭代生成。但语义理解不自动保证正确轨迹,还需通过可执行接口和反馈检验。
3. 执行
高层意图经过轨迹处理、逆运动学和底层控制,转换成位置、速度或力矩指令。工作空间、碰撞、关节限位、奇异点、运动平滑性和能耗都可能影响可执行性。 对于直接输出末端或关节动作的学习策略,底层控制同样需要处理扰动、机械柔顺性和执行器误差。模型输出与真实运动之间的接口是系统可靠性的重要边界。
4. 感知
相机、深度、激光雷达、惯性和雷达等提供环境观测,本体编码器描述机器人状态,触觉与力信号补充接触、表面和抓取稳定性。 视觉可支持避障和跟踪,本体信息支持姿态与协调,触觉使系统在抓持易碎物体时调整力度。多模态价值来自互补信息,也要求时间同步和一致的状态解释。
5. 数据基础
数据包括传感流、人类或遥操作示范、状态—动作轨迹、仿真与数字孪生数据,以及连接文字、视觉和动作的多模态记录。真实数据保留噪声、失败和物理复杂性,但采集依赖硬件与人工;合成数据可扩展场景,却受仿真和模型误差影响。 结构化记录便于监督精确技能,视频和语言等非结构化资料拓展表示,实时流支持上下文反馈。数据规模应与任务、平台、对象和动态多样性共同考虑;合成标签也需验证与实际动作后果一致。
6. 学习范式与反馈机制
强化学习通过交互奖励优化策略,层级强化学习将长任务分解为不同时间尺度的子任务。人类或 AI 反馈可以补充偏好信号,但评价者本身也可能存在偏差。 监督与示范学习更直接地获取技能,却受训练覆盖限制;无监督学习发现表示结构;自监督学习从未来状态和跨模态预测构造训练信号。物理仿真、数字孪生与域随机化支持训练和扰动测试,但最终仍需真实反馈确认迁移效果。
7. 基础设施与评测框架
LIBERO、RLBench 等提供操作任务协议,Open X-Embodiment 等提供跨机器人数据,二者用途不同。基准成功率有助于比较,但不能完整代表现实鲁棒性。 除任务完成,还需要评估扰动、失败预测、接触限制、恢复和实时性。对于联网传感器、执行器和边缘设备组成的系统,计算与通信基础设施也是性能条件的一部分。
III. Taxonomy of Generative Physical AI | 生成式物理人工智能分类
原文按功能将五类模型归入生成式控制、动作策略生成和数据生成三组。分类强调互补:策略可以包含扩散动作头,也可以用世界模型提供训练数据或规划上下文。
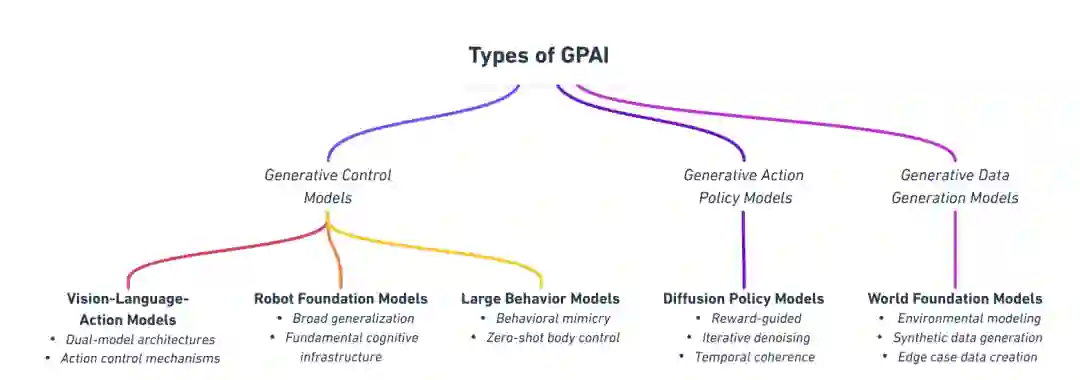
图2|五类模型与功能分组。机器人基础模型、视觉—语言—动作模型和大行为模型连接控制功能;扩散策略关注动作生成;世界基础模型关注环境建模与数据合成。来源:原文图2。
1. 机器人基础模型
# 多模态架构框架
机器人基础模型(RFM)从跨任务和跨平台数据中学习通用能力。原文架构由视觉、语言、传感和动作相关编码器提取特征,经时间对齐、投影与注意力融合为统一表示,再由动作接口服务不同载体。
# 模型类别与方法
作者对比专用模型与通用模型:前者在固定场景和技能上优化,计算与数据要求相对可控;后者扩大共享表示和能力范围,但需要更多数据及适配。跨平台迁移始终受动作空间、形态和传感配置差异限制。
# 代表性通用模型
PaLM-E 将具身观测引入语言模型表示,用于多模态理解和高层规划,其文本计划仍需外部执行接口。Gato 将不同任务转为序列建模,在同一网络中处理多种输入输出。语言模型也可以作为任务分解和代码生成模块,但高层规划模型不应直接等同于底层机器人控制器。
2. 视觉—语言—动作模型
# 架构定义
视觉—语言—动作模型(VLA)将视觉、指令与机器人状态连接到动作策略。原文突出视觉—语言模块加动作生成模块的结构;实际架构可采用统一标记生成或独立动作专家,不宜将“双模型”视为所有 VLA 的必要条件。
# 多模态处理流程
图像、语言和本体状态分别编码并投影到可交互的表示空间,融合后由动作解码器产生离散动作标记或连续控制。输出可以对应末端运动、夹爪状态、关节动作或技能接口,训练和部署需与真实控制语义对齐。
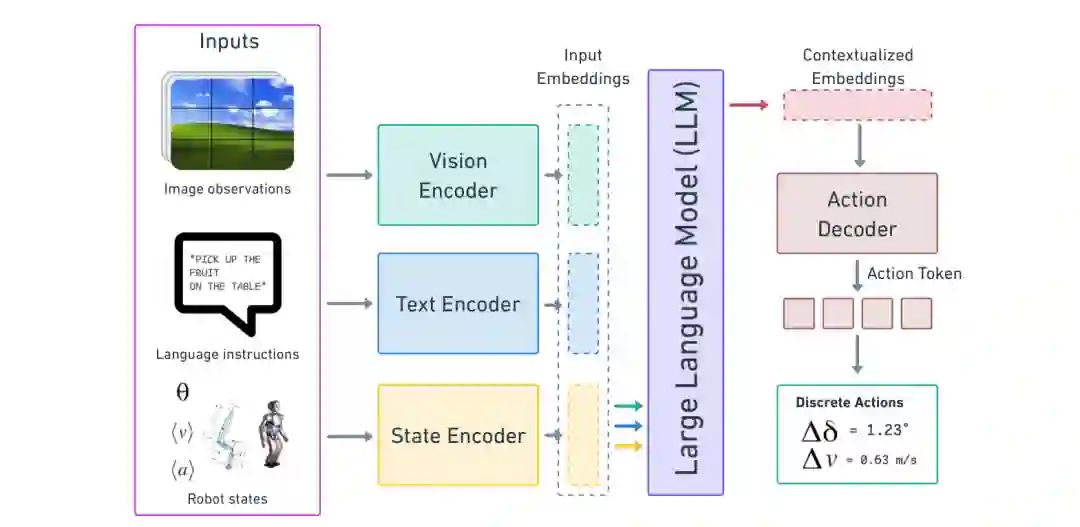
图3|原文展示的视觉—语言—动作流程。图像、指令和机器人状态先编码为输入嵌入,再生成上下文化表示,并由动作解码器转换为控制标记。该图是离散动作接口示意,并不覆盖所有连续动作实现。来源:原文图4。
# 机器人变换器一型:大规模机器人序列学习
RT-1 将语言条件视觉特征压缩后交给 Transformer,通过离散化动作产生机器人命令。其重要性在于将多任务示范、大规模训练和统一动作接口连接起来,而不是依赖每个任务独立设计策略。
# 机器人变换器二型:将动作表示为语言
RT-2 用类似文本标记的表示连接机器人动作与预训练视觉—语言知识,并结合机器人数据进行适配。这样可以把对象语义和语言先验用于动作选择,但语义迁移并不消除运动精度、硬件执行和新场景可靠性问题。
# 其他视觉语言动作实现
OpenVLA 强调开放模型、视觉特征融合和平台适配;Gemini Robotics 等研究进一步面向复杂双臂交互。它们展示不同的数据、参数和接口选择,评估时必须注明测试平台、任务与微调条件。
3. 大行为模型
# 定义与学习机制
大行为模型(LBM)关注复杂身体动作和行为序列,借助示范、运动数据和交互反馈学习行为先验。目标不仅是到达位置,还包括运动自然性、协调和行为可适配性。
# 架构与学习框架
原文示意包括行为嵌入、演员网络、经验缓存和反馈网络,分别评价运动真实性和状态转移合理性。推理阶段根据状态及潜在行为变量产生动作。运动“像人”与物理可行、任务正确是不同属性,需要分别检查。
# 代表性零样本全身控制
Meta Motivo 采用前向—后向表示和条件策略正则化等机制,从状态和潜在变量生成全身动作,并结合价值及判别反馈。此类研究展示仿真中的行为适配潜力,不应直接推断任意真实人形平台都能免适配部署。
4. 扩散策略模型
# 迭代动作细化框架
扩散策略模型(DPM)以观测为条件,将噪声动作逐步去噪为动作序列。视觉、本体状态和历史提供上下文,去噪网络学习示范动作分布,而不是对多个可能动作简单求平均。
# 架构与优势
模型常采用去噪网络生成动作块,再执行其前段并重新规划,即滚动时域控制。这有助于利用时间关联、表达多种有效策略,并在新观测到来后修正动作。但采样成本和动作块的反馈间隔需要共同设计。
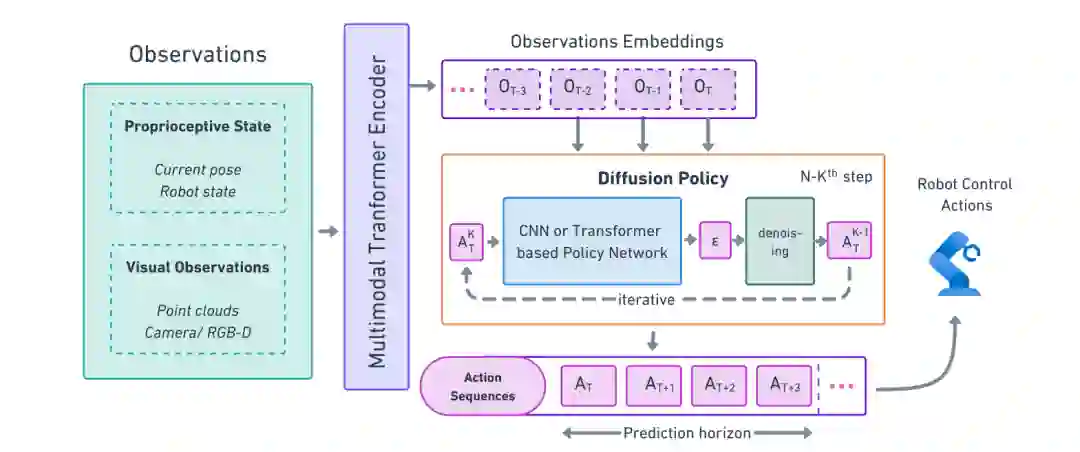
图4|扩散策略结构。历史观测嵌入作为条件,网络迭代预测噪声并细化动作候选,最终得到预测时域内的动作序列。来源:原文图6。
# 训练与评估
示范轨迹构成主要训练来源,RoboMimic、CALVIN、LIBERO 和 Push-T 等覆盖不同操作与时间结构。除成功率,应检验多种有效动作模式、序列平滑性、扰动鲁棒性、跨平台适配和推理延迟。 多步动作生成不自动证明长任务推理或安全稳定,模型也不会仅因使用扩散就避免所有分布偏差。评测需要把生成优势落实到指定任务和条件。
# 近期进展与集成
三维扩散策略将点云用于空间条件,扩散策略强化学习探索在奖励下进一步微调,通用机器人策略也可使用扩散动作头。与 VLA 的结合说明模型家族并非互斥:同一个系统可以同时具备语义条件和扩散动作生成。
5. 世界基础模型
世界基础模型(WFM)根据观测表示和可选动作预测未来图像、视频、潜在状态或传感变量。预测表示通常不是完整物理状态,因而要考虑部分可观测和误差累积。 训练流程包括时间同步、分段、过滤、编码与条件预测。自回归和扩散是两类生成机制,各自在序列组织、采样质量和成本之间取舍;不能仅凭机制名称判断效率。 控制中,规划器提出候选动作,模型预测结果,成本、奖励及约束帮助选择执行动作。随后重新感知和规划;也可把规划结果蒸馏成策略,或利用想象经验优化策略。
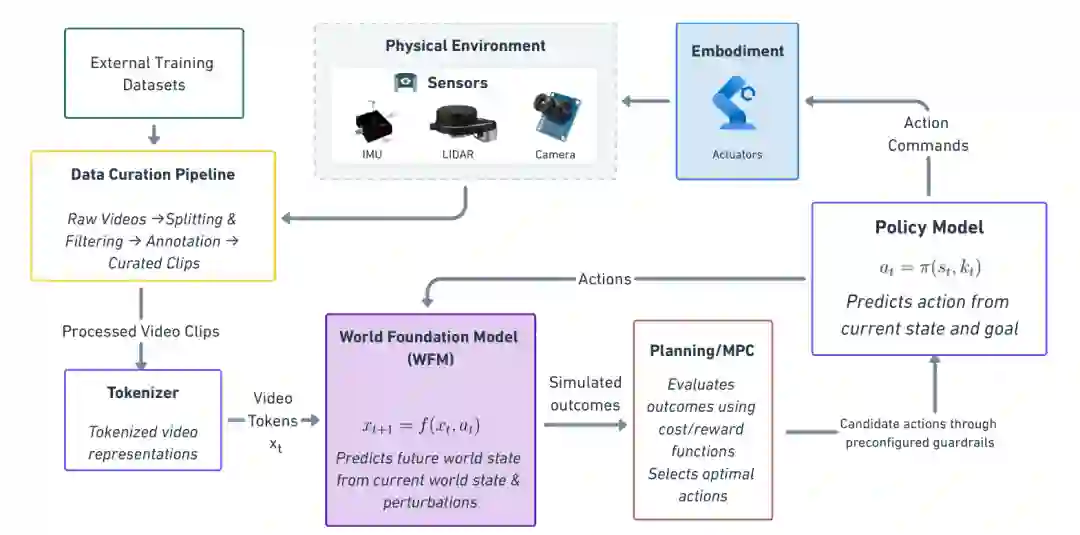
图5|世界基础模型的训练与控制。传感数据经整理和标记化用于预测学习;规划器比较候选动作的想象后果,策略与执行器实施选中动作,真实反馈回流到数据层。来源:原文图7。
# 环境仿真与数据生成
数字孪生提供结构化、可解释的虚拟系统及物理约束,世界模型补充学习式观测或残差动力学。二者可以结合,但视觉真实感不等于接触、摩擦和执行延迟已经准确建模。 物理相关损失和约束可以减少不合理预测,仍需通过任务与真实系统验证。合成数据可扩展稀有场景,但应检查动作后果、事件有效性与分布覆盖,防止模型偏差进入下游策略。 原文以 NVIDIA Cosmos 为平台案例:Predict 面向未来预测,Transfer 将结构化条件转换为可控场景,Reason 支持分析、整理和标注。不同组件在数据与控制流程中承担不同角色。
# 评估与基准
评测需同时考虑生成质量、时间稳定、条件遵循、物理合理性和下游效用。WorldScore 组织可控性、质量与动态评价,WorldModelBench 强调指令与物理遵循,WorldSimBench 结合感知评价和视频到动作的功能测试。 这些维度不能被单一画质分数替代。对规划或数据生成用途,还应检验模型是否改善实际决策和策略,而不是只给出令人信服的样例视频。
6. 分类综合与讨论
机器人基础模型与 VLA 追求更广泛的任务连接,大行为模型、扩散策略和世界模型提供行为、动作或环境方面的专门能力。综合趋势是通用理解与专业控制协同,而不是所有功能交给同一种网络。 数据组成、动作接口、机器人形态、学习目标和算力共同决定系统范围。模型家族名称可以帮助定位功能,却不足以说明泛化强度和部署可靠性。
IV. Applications of GPAI | 应用
1. 自动驾驶与辅助驾驶
应用涉及多模态交通理解、轨迹生成、风险预测及稀有场景合成。论文讨论 Wayve 等世界模型与驾驶案例。辅助驾驶、预测研究和完整自主驾驶具有不同操作边界,评估需结合真实交通闭环、延迟和风险,不能仅靠离线预测。
2. 工业机器人与制造
柔性装配、分拣、协作和质量检查需要在变化工件与环境下维持精确控制。语言条件和基础表示可降低任务配置负担,世界模型与数字孪生支持预先测试。 原文的 KUKA、ABB 等案例说明工业机器人应用背景,并不自动证明具体产品采用了某种生成式基础模型。生产评估应同时关注节拍、良率、停机与人机协作条件。
3. 医疗与医疗机器人
多模态与示范学习研究有望支持手术辅助、康复和个性化交互。原文列举 da Vinci、Hugo 和外骨骼等作为医疗机器人背景。 机器人辅助手术不能等同于生成式自主手术;平台临床使用也不能直接证明大模型控制可靠。医疗场景要求把专业监督、操作权限、组织接触精度与系统验证条件讲清楚。
4. 人形机器人与人机交互
人形系统连接语言理解、身体状态、全身协调和动作生成。GR00T 等模型探索语义与动作模块配合,运动控制研究则关注动态稳定和仿真迁移。 人与机器人交互还涉及语言、手势和用户偏好。演示、遥操作、仿真结果和现场自主运行应分开判断,不能由少数展示推断开放环境的持续自主能力。
5. 物流、仓储与供应链
拣选、搬运、包装和动态调度要求处理多种对象及变化需求。基础模型可能改善操作适应,系统规划则优化任务和路径分配。 论文引用 Amazon 等自动化案例作为规模化需求背景。仓储效率来自流程、设备和软件共同作用,不宜将综合效率数字全部归因于 GPAI 模型。
6. 数字基础设施与智慧系统
数字孪生支持工厂、仓库和城市场景的规划、维护及测试,生成模型可以扩展视觉条件和罕见事件。BMW 虚拟工厂等示例说明虚拟—物理流程的潜力。 这类系统的作用可能是规划和检验,而不直接控制执行器。应明确仿真、建议、操作决策和物理执行之间的边界及数据回流机制。
7. 消费服务与研究应用
家务、生活辅助、零售服务和实验室自动化需要自然交互与多步骤执行。原文讨论 RoboRXN 等 AI 与机器人实验平台,体现任务规划、实验执行和结果反馈的连接。 从实验流程自动化走向开放式自主发现,还需要验证计划的可执行性、异常恢复和结果可追溯性。服务场景也必须处理对象和用户行为的不确定性。
V. Challenges | 挑战
1. 数据稀缺与需求
物理数据不仅要量大,还要涵盖动作后果、多步交互、精细动力学和失败事件。采集依赖昂贵硬件、专业操作与标定,罕见危险事件尤其难覆盖。自监督、迁移和合成数据可减少负担,但不能替代所有真实验证。
2. 偏差与伦理问题
训练分布偏斜会影响对不同环境、对象和使用者的响应,偏差可能从识别进入物理行动。论文主张结合数据多样性、可解释、人类信任和包容性评测,而非只追求成功率。人类或 AI 反馈也需检查一致性与偏差。
3. 硬件与实时约束
大视觉—语言骨干和多步去噪与边缘设备的存储、功耗及延迟预算存在冲突。量化、剪枝、蒸馏和边缘—云协同提供优化方向,但压缩后要重新检查精度、泛化和动作稳定性。通信开销与最坏延迟也是系统成本。
4. 仿真到真实迁移与不确定性
质量、摩擦、接触、柔顺性、传感噪声和执行器误差难被完全建模。仿真中的优秀策略可能在真实条件下失败。域随机化、物理约束和校准能够缩小差距,仍需真实执行与持续监测,尤其不能将模拟人形动作直接视作硬件能力。
5. 泛化、提示敏感性与推理
新机器人存在关节限制、传感与动力学差异,新任务则要求理解对象关系和长期后果。指令表达变化可能引起动作不一致,持续微调还可能遗忘旧技能。多任务、元学习与持续学习需要配合保留任务和分布外测试。
6. 扩展性与系统复杂度
规模扩展不是只训练更大网络,还需协调感知、推理、规划和控制的表示、时间尺度及接口。局部错误可能跨模块传播。模块化和层级化帮助隔离问题,但需要清晰的数据与执行契约,并验证整体闭环。
7. 鲁棒性、安全与失败模式
动作离散化可能降低精细控制分辨率,随机动作生成的经验成功也不等于形式化稳定保证。原文讨论控制屏障函数等运行时过滤方向,其保证依赖模型、可行性和控制假设,不能自动覆盖基础模型所有行为。 评测需包含接触力、约束违反、恢复时间和失效保护。规划与监控失败可能叠加,安全措施应能及时限制或停止执行,并记录失败原因。
8. 透明性与可解释性
复杂模型不易诊断,既要知道输出了什么,还要定位失败来自感知、语义、计划、动作接口还是硬件。可追溯日志和模块级评价可以支持审计,但自然语言解释不自动构成真实决策依据。
9. 能源效率与环境影响
训练和推理消耗计算资源,移动系统还受电池与散热限制。效率评估需要兼顾计算、执行能耗与可靠任务完成,避免仅优化生成吞吐量。更小模型、复用表示和有针对性的采样有助于降低成本。
VI. Future Directions | 未来方向
1. 数据效率与学习方法
自监督、迁移和少样本方法有望降低标注与示范需求,数字孪生和仿真提供可控覆盖。研究应衡量在减少真实交互后是否仍保持能力,并检查合成数据在新动态条件下是否有效。
2. 基础模型与模块化架构
未来系统需要在共享表示基础上适配不同机器人,而不是假设所有形态拥有相同控制空间。可替换传感、任务和动作模块有助于复用通用知识,同时保留专用约束。跨模块因果与时间对齐将影响真正的泛化能力。
3. 计算效率与硬件进展
边缘模型优化、专用硬件和分层计算支持实时推理,触觉及执行器技术补充模型无法仅靠视觉推断的精细状态。应联合设计感知频率、规划周期和底层控制,而不是分别优化网络延迟与机械性能。
4. 安全协议
原文强调持续监控、外部验证与明确治理。安全测试应针对语义错误、接触精度和失败恢复,在模型或数据更新后检查回归。长期交互学习可以支持适应,但更新后的策略仍需保持可审计的执行边界。
VII. Conclusion | 总结
生成式物理人工智能将多模态理解、动作生成和世界预测连接到真实载体。五类模型提供一张功能地图:通用表示支持任务与平台适应,视觉—语言—动作策略连接语义与控制,行为先验与扩散动作改善运动生成,世界模型扩展预测和数据能力。 真正的落地取决于这些功能能否形成可靠闭环。物理约束、数据覆盖、仿真迁移、时间预算和失败恢复共同决定系统边界。未来进展应以真实任务中的可靠性和资源成本证明,而不只依赖生成样例、参数规模或行业热度。 论文主页:https://arxiv.org/abs/2609.18111 原文 PDF:https://arxiv.org/pdf/2609.18111
 A Comprehensive Review of Generative Physical Artificial Intelligence


相关内容

 微信扫码咨询专知VIP会员