
导读
**
**
综述 | Towards AI That Improves Itself: A Survey of Recursive Self-Improvement
仓库链接:https://github.com/Lee1003-lee/Awesome-RSI-Research 论文链接:openreview.net/pdf?id=I3fKQbRUGy
随着大模型与智能体开始写代码、运行实验、读取反馈,甚至修改 Prompt、Memory、Workflow、模型和训练数据,AI 正逐渐从“被优化的对象”变成“参与优化过程的主体”。Recursive Self-Improvement(RSI)也因此从早期关于“智能爆炸”的理论设想,走向一个可以被构建、测试和评估的工程问题。
但一个核心问题始终没有被回答清楚:反复修改自己,是否就等于 RSI? 综述《Towards AI That Improves Itself: A Survey of Recursive Self-Improvement》围绕这一问题展开,区分 Evolution、Self-Evolution、Meta-Evolution 与 RSI 四个阶段,并提出统一的 Proposal → Feedback → Optimization 框架,用于理解现代 AI 系统如何提出改进、验证改进,并决定哪些变化值得被保留到下一轮
**
**
Introduction
传统 AI 系统的改进流程通常由人类设计和执行,包括训练数据构建、偏好优化、模型架构设计、训练策略选择以及最终评测。模型本身更多是被优化的对象,而不是优化过程的主动参与者。随着 LLM Agent 的发展,这条边界正在逐渐模糊:现代智能体已经能够修改代码、调用工具、分析失败、优化 Prompt 和 Workflow,甚至参与训练数据生成、模型训练与自动化实验。AI 开始不仅完成任务,也开始参与“如何把系统本身变得更好”这一过程。
这也使 Recursive Self-Improvement(RSI)重新成为一个现实而具体的问题。但相比“AI 能否修改自己”,更值得关注的是:一个修改是否真的构成 improvement?这个 improvement 是否会被可靠验证、保留,并成为后续 improvement cycle 的起点? 如果系统只是不断反思、重写或重复搜索,却每一轮都从相同状态重新开始,那么它更接近 iterative refinement,而不一定构成真正意义上的 RSI。
因此,本文关注的核心不只是“系统能不能产生新的修改”,而是这些修改能否经过可信的反馈与验证,被稳定地写入后续状态,并在新的任务、环境和优化周期中继续发挥作用。换句话说,现代 RSI 的关键瓶颈并不是缺少 proposal,而是缺少一套能够可靠接受、继承并迁移 improvement 的机制。也正是在这一基础上,文章进一步区分 Evolution、Self-Evolution、Meta-Evolution 与 RSI,并尝试为这一快速发展的研究方向建立统一的分析框架。
Background | 从智能爆炸到 Agentic Improvement
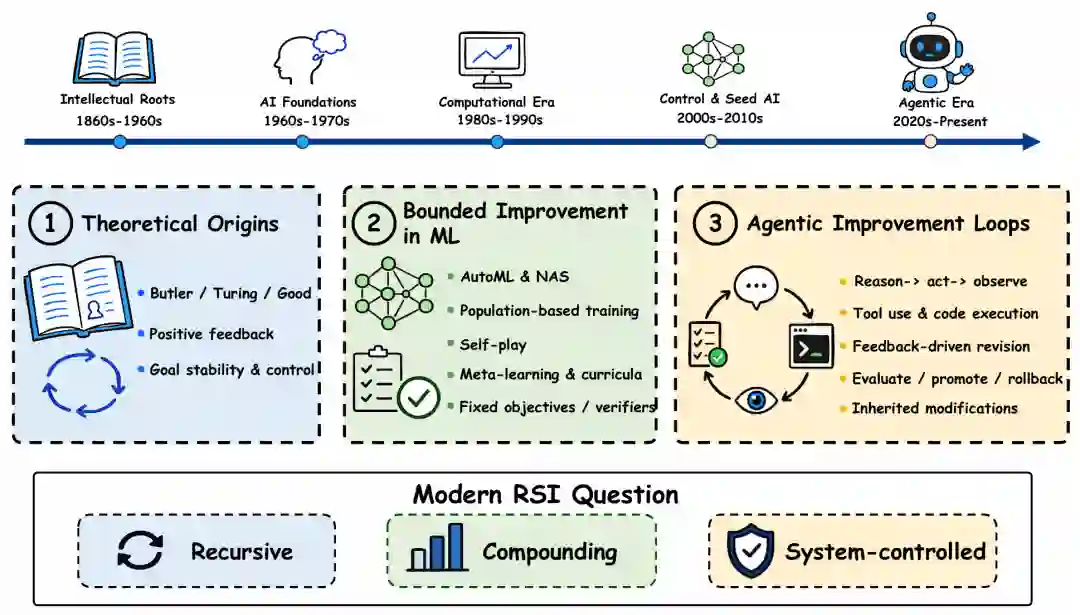
RSI 的思想可以追溯到 Butler、Turing 和 Good 关于机器自我改进与 intelligence explosion 的讨论:如果一个系统能够设计出更强的继任者,那么新的系统又可能进一步提升这种设计能力,由此形成正反馈。随后,AutoML、NAS、Self-Play、Meta-Learning 和 Curriculum Learning 等方法逐渐把这种思想转化为可执行的机器学习优化过程。
真正的变化出现在 Agentic Era。现代智能体不仅能够生成答案,还能够执行代码、调用工具、观察结果、根据反馈修改行为,并进一步调整 Memory、Workflow、Harness 甚至研究过程。因此,RSI 的研究重点也逐渐从“机器能否自己变得更聪明”,转向“一个系统能否持续产生、验证、保留并继承可信的改进”。
**
**
Definition | 什么才是真正的 RSI?
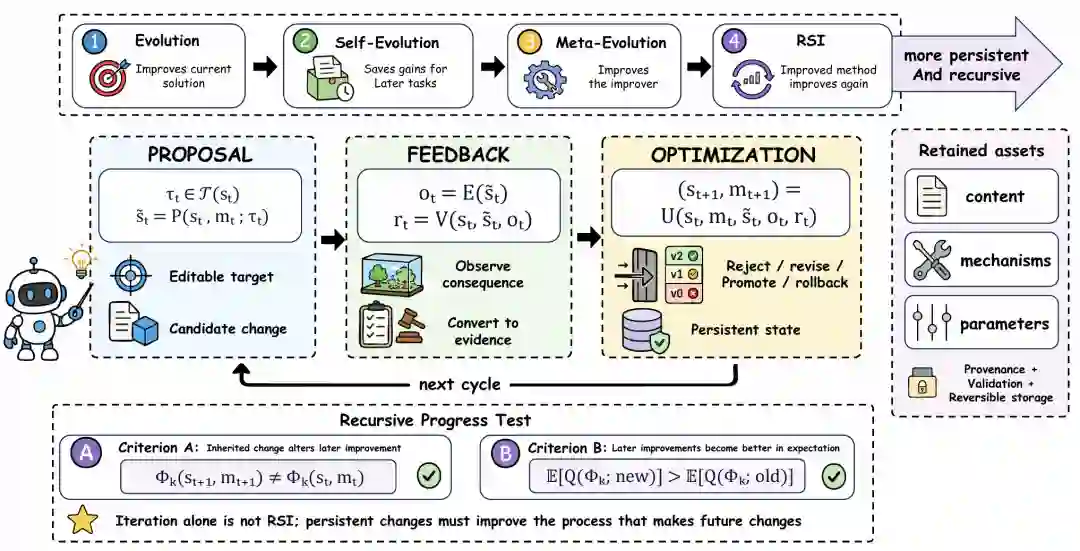
论文首先区分了四个容易混淆的阶段。Evolution 只改善当前输出或轨迹,变化不会被持续保留;Self-Evolution 会将被接受的 improvement 保留下来,并在后续任务、运行或新的交互中复用;Meta-Evolution 则进一步修改负责产生、评估或选择 improvement 的机制本身,例如 proposer、verifier、search rule 或 updater;而 Recursive Self-Improvement 要求某一轮接受的改进真正成为下一轮 improvement cycle 的起始状态,使后续优化建立在已经改进过的状态之上。
因此,论文强调:Iteration alone is not RSI。反复进行 reflection、revision、search 或 optimization,并不意味着系统已经具备 RSI。真正构成 recursion 的关键是 state inheritance:后续 cycle 必须明确继承此前已经验证并保留的 improved state,并继续从这个状态向前优化,而不是每一轮都重新从相同的 base state 开始。
进一步地,论文区分了 minimal RSI 与更强的 recursive progress。前者只要求改进能够跨 cycle 被继承;后者则要求这种继承进一步提升后续的 improvement procedure,例如让系统更有效地产生、筛选或验证下一轮改进。也就是说,系统不仅要“变得更好”,还要逐渐“变得更擅长让自己继续变好”。
**
**
Framework | Proposal → Feedback → Optimization
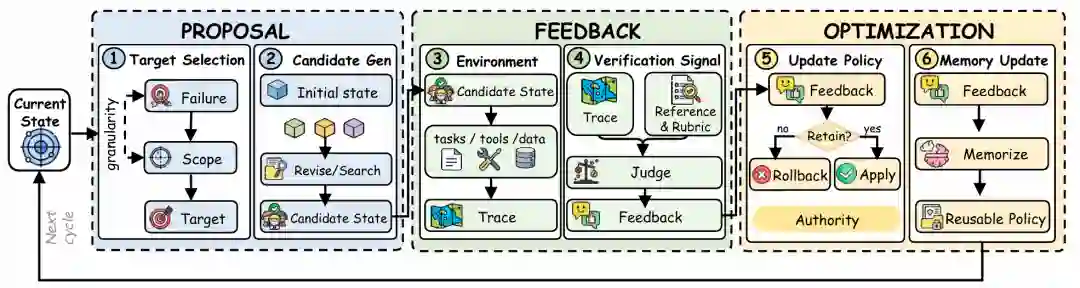
为了统一不同类型的 RSI 系统,论文提出了一个三阶段闭环:Proposal → Feedback → Optimization。Proposal 决定“改什么”以及“如何产生候选改进”;Feedback 将候选方案放入环境中执行,并通过测试、Benchmark、Judge、Simulator 或人工审查将执行结果转换为 evidence;Optimization 再根据这些 evidence 决定保留、修改、拒绝、推广还是回滚该候选。
这里一个重要区别是:执行结果并不等于改进证据,验证通过也不等于可以直接更新系统。 Environment 负责暴露候选修改的后果,Verifier 负责判断这些后果是否满足目标,而 Update Policy 最终决定一个 change 是否拥有进入 persistent state 的权限。
当一个被验证的改进真正写入 Memory、Skill、Workflow、Code 或 Model,并在下一轮 Proposal–Feedback–Optimization 中再次被加载时,一个普通的 iterative improvement loop 才开始具有递归意义。
**
**
System Structure
在这一框架下,论文进一步将现代 RSI 系统拆解为六个关键组件:Target Selection、Candidate Generation、Execution Environment、Verification Signal、Update Policy 和 Memory Update。其中,Target Selection 与 Candidate Generation 构成 Proposal,分别决定“改什么”以及“如何生成候选改进”;Execution Environment 与 Verification Signal 构成 Feedback,负责让候选修改真正运行起来,并将执行结果转化为可比较的 evidence;Update Policy 与 Memory Update 则属于 Optimization,决定哪些变化被保留、修订、拒绝、推广或回滚,并将验证后的状态带入下一轮 cycle。
这种拆解的意义在于,它把“被修改的对象”和“负责产生、验证与保留修改的机制”区分开来。一个系统可以选择修改 Prompt、Memory、Workflow、Harness、Model,甚至整个 Research Process;候选改进也可以通过 textual revision、search、evolution、program synthesis 或 autonomous experimentation 产生。真正重要的并不是采用了哪一种具体算法,而是每次修改是否具有清晰的边界,能否在环境中被执行,其效果是否能够被可靠验证和归因,以及最终是否能以可追踪、可回滚的形式进入下一轮 persistent state。
Taxonomy | RSI 到底在改什么?
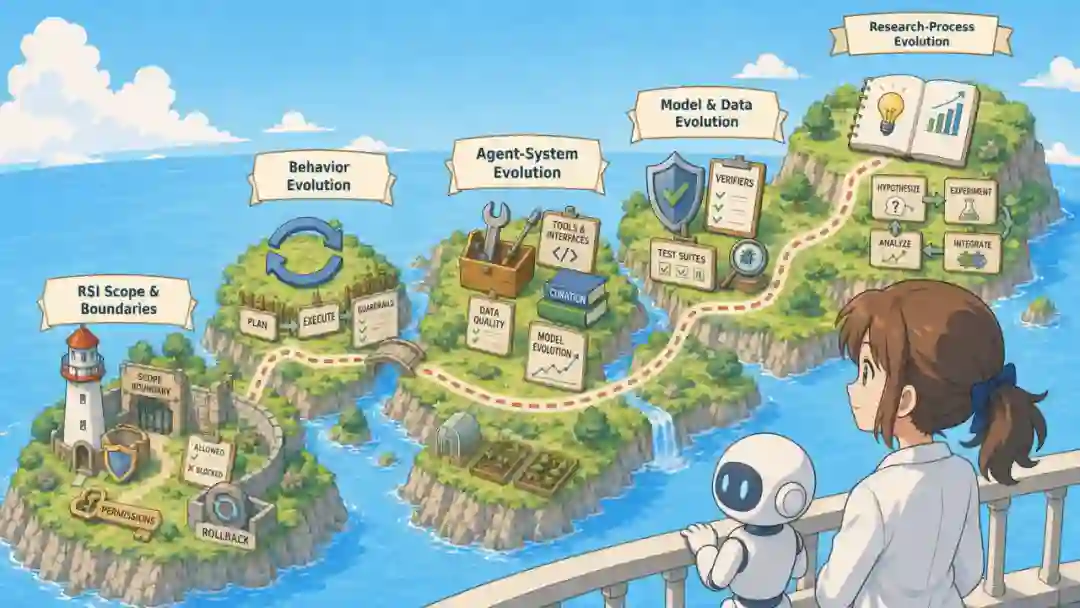
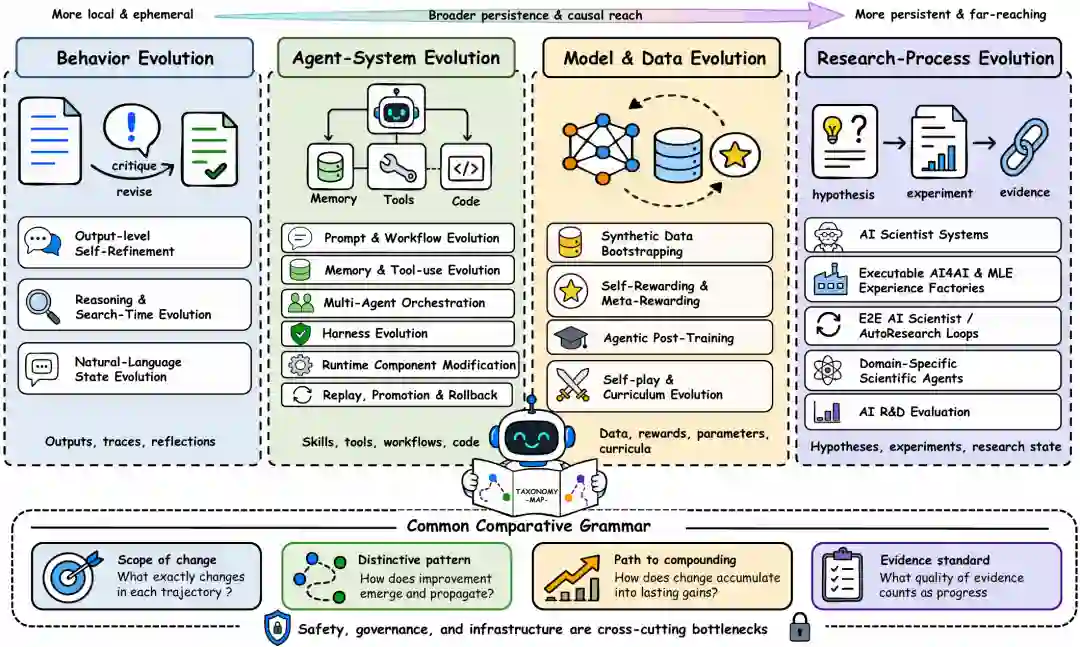
论文进一步从 Evolution Target 的角度,将当前 RSI-related research 分为四类:Behavior Evolution、Agent-System Evolution、**Model & Data Evolution **和 Research-Process Evolution。这四类方法对应着越来越大的 persistence 与 causal reach。
**Behavior Evolution **
主要作用在最局部、最直接的行为层面,修改对象包括模型输出、推理过程、搜索轨迹以及由自然语言维护的中间状态。典型方式包括 self-refinement、reflection、search-time reasoning 和 state optimization:系统先根据反馈修正当前答案或轨迹,再把有价值的 critique、search trace 或经验压缩成可复用状态。它的优点是修改成本低、反馈快,但很多改进仍然停留在当前任务或当前上下文中,只有当这些轨迹、反思或规则被进一步保留并在后续任务中复用时,才真正开始具备持久演化的意义。
**Agent-System Evolution **
进一步把修改对象从“当前行为”扩展到智能体本身的运行结构,包括 Prompt、Memory、Tool-use Policy、Workflow、Harness、多智能体协作机制以及 Runtime Components。相比一次性的输出修正,这类变化能够持续影响后续多个任务和执行周期,例如更新长期记忆、沉淀可复用技能、调整工具调用逻辑、重构工作流,或修改负责协调多个 Agent 的机制。论文特别强调,Harness 不只是一个 Prompt wrapper,而是控制工具、状态表示、执行顺序、反馈通道和发布条件的重要控制面,因此这一层的演化已经开始影响智能体“如何工作”,而不仅仅是“这一次输出什么”。
**Model & Data Evolution **
将自我改进进一步推进到训练过程内部,被修改的对象包括训练数据、Reward、模型参数以及 Curriculum。典型方向包括 synthetic data bootstrapping、self-rewarding 与 meta-rewarding、agentic post-training,以及 self-play 和 curriculum evolution。与外部 Prompt 或 Workflow 调整不同,这一层的变化会直接改变模型之后的学习和生成行为,因此具有更强的 persistence 和 transfer potential;但与此同时,credit assignment、回归检测和验证难度也显著增加,因为最终性能变化可能同时受到数据、Reward、训练过程和参数更新等多个因素影响。
**Research-Process Evolution **
则把 evolution 的范围扩展到完整的 AI R&D 或科学研究流程,不再只优化某个模型或 Agent 组件,而是将 hypothesis、experiment、evidence、research state 以及后续 research decision 都纳入可修改对象。典型系统包括 AI Scientist、Executable AI4AI / MLE、Experience Factories、End-to-End AutoResearch Loops 和 domain-specific scientific agents。这类系统可以自主提出假设、设计和执行实验、分析结果,并根据证据决定下一步研究方向,因此最接近“AI 改进 AI”的完整闭环;但它也带来了最强的验证要求,因为一个看似成功的实验并不一定意味着真实的科研进步,还需要关注可复现性、证据质量、跨任务迁移以及后续研究决策是否真的因此变得更好。
这条路径反映了 RSI 的一个重要趋势:改进对象正从局部、短暂的输出,逐渐扩展到持久、可继承、能够影响后续改进过程的系统状态。 因而,越往后走,潜在收益越大,但 verification、credit assignment、rollback 与安全控制也越困难。
**
**
Future Directions | RSI 下一步往哪里走?
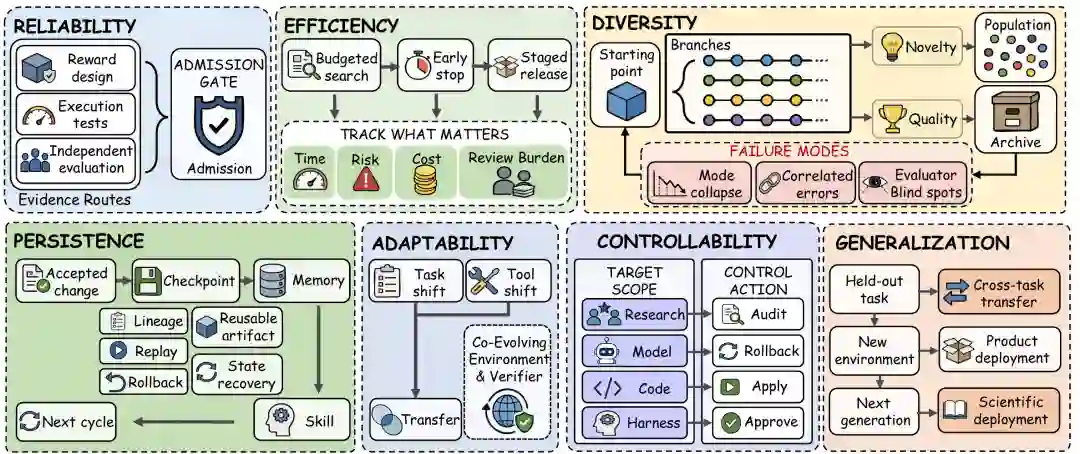
论文将未来 RSI 的关键挑战总结为七个方向:Reliability、Efficiency、Diversity、Persistence、Adaptability、Controllability 和 Generalization。它们并不是彼此独立的七项能力,而共同构成一套 evidence-oriented 的 RSI evaluation profile。
**Reliability **关注一个 change 是否真的值得被接受。RSI 的特殊风险在于,一次错误判断不会只影响当前结果,而可能被进一步写入 Memory、Skill、Training Data 或 Harness,并在后续 cycle 中持续传播。因此,未来系统需要更独立、更可验证的评估机制,包括 execution-based verification、held-out evaluation、rule/formal checks 以及必要的人类审查,避免 Reward Hacking、Verifier Exploitation 或 evaluator bias 被误当成真实进步。
Efficiency 关注 RSI 在有限资源下能否持续运转。现实中的 improvement loop 不可能无限生成和验证 candidate,因此需要在 compute、wall-clock time、human review 和 deployment cost 之间进行权衡。未来更重要的问题不是单纯追求更高 capability,而是衡量每单位资源究竟带来了多少有效 improvement,例如通过 budgeted search、selective evaluation、early stopping 和 staged release 提高整体效率。
Diversity 关注系统是否能够维持足够多样的改进路径。如果不同 candidate 都来自相同的 proposer、memory 或 verifier,它们很可能共享同样的 blind spot,最终出现 mode collapse、correlated error 或 evaluator overfitting。未来 RSI 因此需要更丰富的 hypothesis、population、archive 和 independent branches,让系统不仅“搜索更多”,而是真正探索不同的改进方向。
Persistence 关注一次 improvement 能否真正跨 cycle 留下来并持续发挥作用。对于 RSI 来说,短期得分提升并不足够,系统还需要保证被接受的 change 能够被记录、加载、追踪和复用。这意味着未来系统需要更完善的 Memory、Skill、Versioning、Lineage、Replay 和 Rollback 机制,使 improvement 从一次局部成功转化为后续 cycle 可以继续利用的 persistent state。
Adaptability 关注系统在环境变化后还能不能继续改进。真实世界中的任务、工具、数据分布和 verifier 都可能不断变化,因此静态 benchmark 下有效的 improvement 未必能够长期成立。未来 RSI 需要更强的 dynamic evaluation、verifier–environment co-evolution 以及 replayable and versioned contexts,使系统能够在 task shift、tool shift 和 environment change 下持续调整,而不是只适应固定分布。
Controllability 关注 self-improvement 是否始终处在可管理、可审计的范围内。当系统开始修改 Model、Code、Harness 或 Research Process 时,真正重要的问题不仅是“能不能改”,还包括“谁有权限批准”“修改能影响多大范围”“出现问题能否回滚”。因此,未来 RSI 需要更清晰的 authority、scope control、approval、audit 和 rollback 机制,让系统具备 improvement capability 的同时,也保留对 improvement process 的治理能力。
**Generalization **最终检验一个 improvement 是否真的具有价值,而不是只对当前 benchmark、judge 或 harness 有效。一个系统可能在固定 evaluator 下取得更高分,却并没有真正提升底层能力。因此,未来评估需要更重视 held-out task、new environment、cross-domain transfer、product deployment 和 scientific deployment,甚至进一步考察 improvement procedure 本身能否迁移到新的任务和后续 generation
**
**
** 启示 | 从“会修改自己”到“会可靠地改进自己”**
从这篇综述的视角来看,RSI 真正困难的地方并不是让 AI 不断提出修改。今天的 Agent 已经能够生成代码、修改 Prompt、调整 Workflow、调用工具、进行搜索,甚至执行较完整的实验流程。真正困难的是:我们如何判断一个变化是否真的构成 improvement,又如何保证这个 improvement 值得被保留、能够在后续 cycle 中被可靠复用,并且不会因为错误验证、错误归因或局部过拟合而在递归过程中不断放大?
因此,真正可信的 RSI 需要的不只是更强的 proposer,而是一套完整的 improvement infrastructure:可靠的 verification、明确的 state inheritance、可追踪的 lineage、可复现的 evaluation,以及必要时能够 rollback 的 control mechanism。换句话说,系统不仅要会“提出改变”,还要知道为什么接受这个改变、这个改变影响了什么,以及它在后续任务、环境和改进周期中是否仍然有效。论文最终也将 verification 与 reliable cross-cycle transfer 视为当前 RSI 从简单递归状态继承走向真正 recursive progress 的核心挑战。
从这个意义上说,Recursive Self-Improvement 的终极问题或许并不是“AI 能不能改变自己”,而是:AI 能否持续判断什么值得改变,把真正有效的改变稳定地继承下来,并让这些改变成为下一次改进的可靠起点。 只有当 improvement 能够被验证、保留、迁移,并进一步支持后续更好的 improvement,RSI 才真正从“反复修改自己”走向“持续改进自己的能力”。
 https://github.com/Lee1003-lee/Awesome-RSI-Res...


相关内容

 微信扫码咨询专知VIP会员