
综述 | 具身智能世界模型:从可信预测、可控干预到行动效用
导读
当人伸手拿起杯子时,通常不会在脑海中生成一段高清操作视频,而是预估重量、抓取阻力和接触结果,据此调整动作。这个例子提示我们:世界模型的价值,在于预测能帮助智能体做什么,而不只在于画面看起来有多真实。
《World Models for Embodied Intelligence: From Plausible to Controllable to Actionable》提出一条面向决策的能力阶梯:模型首先要保持任务相关状态的一致性,其次要正确预测不同干预的影响,最终要把预测转化为可测量的行为或学习收益。本文将三层分别表述为“可信预测”“可控干预”和“行动效用”。这里的“可信”限定于被测试的状态、时域与条件,并非对模型整体可靠性的保证。 综述进一步用几何、物理、动作三个落地维度,与数据、奖励、策略、模型自身四种改进闭环组成一个三乘四矩阵,分析预测内容如何进入机器人系统。它覆盖操作、自动驾驶、导航、运动控制及跨机器人迁移,并提出与能力声明相匹配的评测要求。 下面沿用原文 11 个主体章节和小节顺序展开。配图截取自原文,保留图内文字,图注采用中文。本文介绍的是作者提出的综述框架;文献在分类中的位置不代表所有能力均已验证,也不构成统一条件下的性能排名。 论文信息
英文题名:World Models for Embodied Intelligence: From Plausible to Controllable to Actionable 作者:Nanjie Yao、Hao Wang、Chong Cheng、Zhikang Chen、Wenzhe Li、Jiafei Lyu、Li Shen、Peilin Zhao、Zongqing Lu、Gao Huang、Steven Hoi、Dacheng Tao、Deheng Ye。 作者单位包括香港科技大学(广州)、牛津大学、普林斯顿大学、腾讯、中山大学、上海交通大学、北京大学、清华大学、阿里巴巴、新加坡管理大学和南洋理工大学。论文为 arXiv 预印本,首次提交于 2026 年 9 月 15 日,PDF 共 51 页,含参考文献。 论文主页:https://arxiv.org/abs/2609.16697 原文 PDF:https://arxiv.org/pdf/2609.16697 项目页面:https://3dagentworld.github.io/EmbodiedWM/
1. Introduction | 引言
视觉—语言—动作模型让机器人能够从多模态观测和指令直接产生动作。但直接映射没有自动提供维护隐藏状态、预见延迟后果和比较候选干预的机制。这些能力在部分可观测、接触丰富和长时序环境中尤其重要。 世界模型连接感知与决策:保持任务相关信息,预判行动后果,并在执行偏离预期时支持修正。既有综述常按架构、输出模态或应用领域整理研究;本文则追问,各种预测能力是否足以支持更好的具身行为。 作者提出三个逐步增强的要求:保存正确的状态;对干预作出正确响应;使预测产生下游收益。这个视角允许潜在动力学、视频生成、三维预测、物理建模和世界—动作模型在同一框架下比较,同时把几何、物理、动作接口与实际改进路径联系起来。
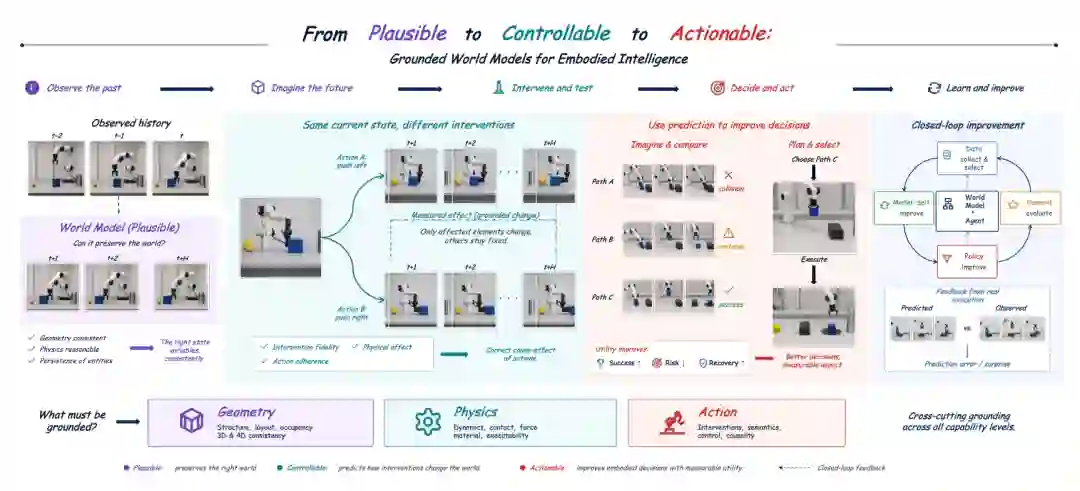
图1|综述总览。从历史观测出发,模型保持任务相关状态,比较同一初始状态下的不同干预,再通过预测改善决策;真实执行反馈进入数据、奖励、策略和模型自身闭环。几何、物理与动作落地贯穿三层能力。来源:原文图1。
2. Foundations, Definitions, and Boundaries | 基础、定义与边界
2.1 从学习动力学到世界模型
早期视觉前瞻研究将机器人动作与未来像素预测连接,并在模型预测控制中反复规划。PETS 引入概率集成与轨迹采样处理不确定性,PlaNet 将规划转向紧凑潜在状态,Dreamer 系列进一步在想象轨迹中训练策略。 另一条路线强调决策等价性。MuZero 等模型无需重建观测,而是保留搜索和价值估计所需的内部结构。由此,世界模型不必复现完整外部世界,只需保持与预测和决策相关的信息。短想象时域、保守目标和真实数据校准则用于限制策略利用模型错误。
2.2 世界模型的定义与范围
本文将世界模型定义为学习式或混合式的智能体—环境动力学预测模型:给定交互历史及可选候选动作,预测任务相关环境变量如何变化。预测状态可以是像素、特征、对象、几何、物理量、符号状态,或奖励与价值等决策相关量;解码回图像并非必要步骤。 学习仿真器是通过可重复轨迹接口暴露的世界模型;世界—动作模型则通过级联、共享表示或联合生成紧密连接预测和动作。纯反应式 VLA 不在本文操作性定义范围内,只有当可识别的未来预测机制影响动作、学习或执行时,才进入分类。奖励与评论家模型也仅在评价预测转移、想象轨迹或模型不确定性时纳入讨论。
2.3 预测表示
表示选择有三组独立维度:预测空间是观测、潜在状态还是结构化对象;预测内容是外观、几何、物理还是任务量;时间与动作接口是单步、动作块、子目标或长轨迹,以及显式动作、潜在动作或高层技能。 这些选择决定模型如何被查询,却不决定能力强弱。三维输出不自动可靠,高清像素预测也可能服务规划。应分别验证状态一致性、干预准确性与决策收益。
3. Unified Taxonomy | 统一分类框架
3.1 以落地对应关系为条件的能力阶梯
“落地”指预测与可测量具身属性之间明确、可检验的对应。几何维度关注对象身份、位置、遮挡和跨视角一致性;物理维度关注接触、碰撞、摩擦、力和材料响应;动作维度关注命令身份、时序、幅度、组合、坐标系和机器人平台。 可信预测层要求未来与历史和相关环境结构一致。最低证据是,在离线或开环测试中,至少一种任务相关状态属性随时间保持一致。应报告误差随预测时域的曲线,让漂移可见。 可控干预层要求改变动作时,模型预测的变化与实际执行变化一致。需要同一初始状态下的配对或分支干预,而不是仅改变提示词后得到不同画面。记录动作上的条件预测仍可能存在混杂,不能直接证明因果响应。 行动效用层要求预测改变决策或学习更新,并在匹配控制器及计算预算下改善结果,如成功率、安全、恢复、策略排序或真实数据效率。定性想象视频不足以支持这一层。 三层在要求上累积,但实际论文可能展示高层用途、却未检验某项低层能力。下游成功不能反推对象恒存或动作因果效应已被完整验证,应明确列出未测试部分。
3.2 落地维度与改进路径矩阵
矩阵行表示预测的内容,列表示预测改变的系统环节。它描述可能的接口,不是互斥类别,也不是能力等级。 | 落地维度 | 数据闭环 | 奖励闭环 | 策略闭环 | 模型自身闭环 | | --- | --- | --- | --- | --- | | 几何 | 采集新视角、遮挡与拓扑变化 | 评价碰撞、可见性与可达性 | 选择可行路径与对象关系 | 修正地图、身份和持久场景状态 | | 物理 | 采集接触、滑移、形变和罕见失败 | 评价稳定性、能耗与力限制 | 避免物理不可行或危险行为 | 修正局部动力学并检查退化 | | 动作 | 采集时序、幅度或平台不同的干预 | 评价命令遵循、进展与风险 | 从有支持的反事实结果选择动作 | 修正动作语义、延迟与转移偏差 | 一项方法可以跨多个单元格。进入某条改进路径只说明预测被使用;是否带来行动效用,仍需与匹配基线比较。
4. Plausible World Models | 可信预测世界模型
4.1 紧凑潜在状态与对象中心状态
C-SWM 用对象表示和关系网络描述状态,SlotFormer 在对象特征上预测动力学。联合嵌入预测路线则保留特征预测原则,不必显式拆分对象或重建像素,代表性研究包括 V-JEPA 等。 这一阶段减少预测目标的规模,并保留实体、关系或任务特征。但对象槽位不是场景中的度量位置,紧凑表示仍可能难以区分位置漂移与对象丢失。
4.2 度量场景状态:占用、点与渲染
OccWorld、MUVO 等将未来放入三维占用空间;鸟瞰、点云和高斯表示进一步使深度、占用或位移成为可量化目标。几何约束还能通过中间特征对齐和跨视角监督进入视频模型。 PointWorld 等把状态和动作关联到三维点流,便于检验空间变化。代价是表示随空间范围和预测长度增长;邻近视图一致也不代表离开场景后重访仍保持同一世界。
4.3 物理落地动力学与交互保真度
几何一致的场景仍可能出现穿透、失去支撑或不合理材料响应。IntPhys、PHYRE、CLEVRER 和 Physion 等提供将物理事件与画质分开检验的资源。 方法可以通过方程约束、对象局部动力学、粒子表示或物理相关辅助任务限制状态演化。PhyDNet、ParticleFormer 等体现不同归纳偏置。关键是把接触、摩擦、力和材料响应变成可评价变量,而非仅把物理合理性留给观看者判断。
4.4 持久记忆与长时序稳定性
持久场景或空间记忆存储并检索过去内容;长上下文状态空间模型和蒸馏则延长可承载时域。两类机制可以互补,但生成更长视频与保持状态一致是不同结论。 真正的检验是:对象离开视野后再出现,是否仍为同一身份、同一位置,并保留无法确定部分的不确定性。仅出现一幅类似旧画面的新图像,不等于记忆恢复。
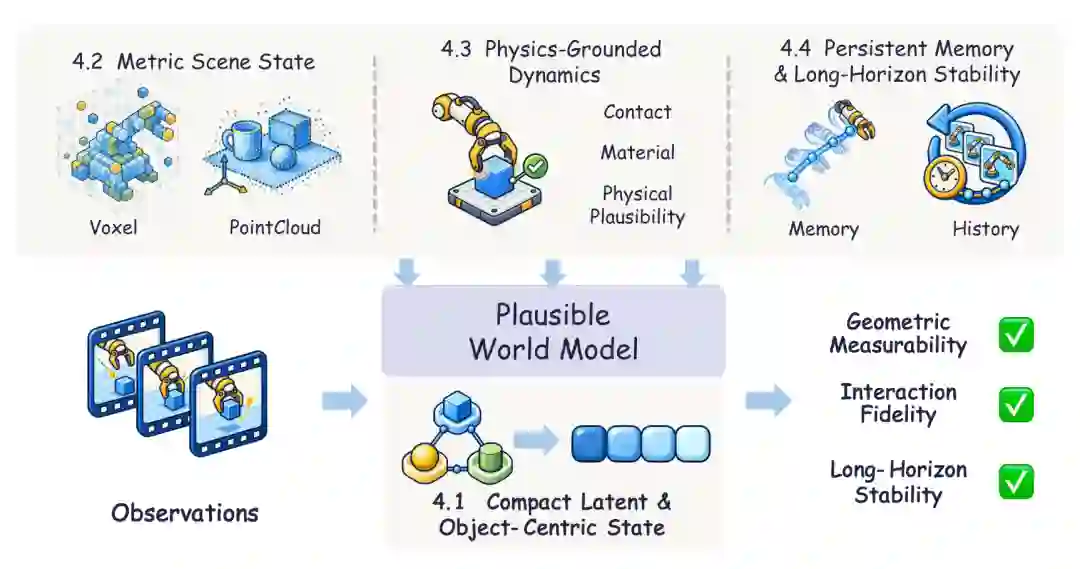
图2|可信预测层。从紧凑潜在/对象状态,到度量几何、物理交互约束和持久记忆,逐步扩展可测试的状态内容。该图是概念组织方式,不是所有模型必须具备的组件清单。来源:原文图3。
5. Controllable World Models | 可控干预世界模型
5.1 动作条件预测
模型接收电机命令、末端轨迹或驾驶动作,再预测后续状态。SAVP、FitVid、IRASim,以及驾驶领域的 GAIA-1、DriveDreamer 等展示不同接口。ACT-Bench 则将动作遵循单独作为测量目标。 接受动作输入不代表使用动作,更不代表正确执行其语义。模型可能忽略命令,仍输出自然流畅的视频,因此必须把场景真实感与命令响应分开评测。
5.2 开放、潜在与语言指定干预
Genie、LAPA、AdaWorld 等从无动作标签视频恢复潜在控制变量;其他方法用键盘、语言或目标图像指定干预,降低对平台专属标签的依赖。 语言组合和潜在动作扩大了控制集合,但命令进入模型内部单位后,实际效果更难直接测量。仍需建立潜在变量或语义意图与真实状态变化、机器人动作之间的对应。
5.3 结构落地控制:几何、轨迹与接触
相机位姿、对象路径、三维流、关节构型和接触力等变量可由外部传感器或标注测量,让请求变化与实现变化处于相同单位。MagicDrive、3DFlowAction、PIN-WM 和视觉—触觉方法体现这些方向。 对象运动接口还可以将命令与特定硬件分离,但获取几何、力或重建监督需要成本。一个可迁移的接口也仍需验证其在目标平台上的执行可达性。
5.4 交互式展开与联合世界—动作模型
交互式展开让策略根据模型生成的观测继续选择动作。Ctrl-World、iVideoGPT 等提供这样的预测环境;GR-1、PAD、UWM、WorldVLA 等进一步连接未来与动作输出。 新要求是,模型必须在策略自行访问的状态分布上保持忠实,而不只是预测数据集中记录的命令。联合训练也不必意味着推理时生成完整视频,部分设计可以直接解码动作。
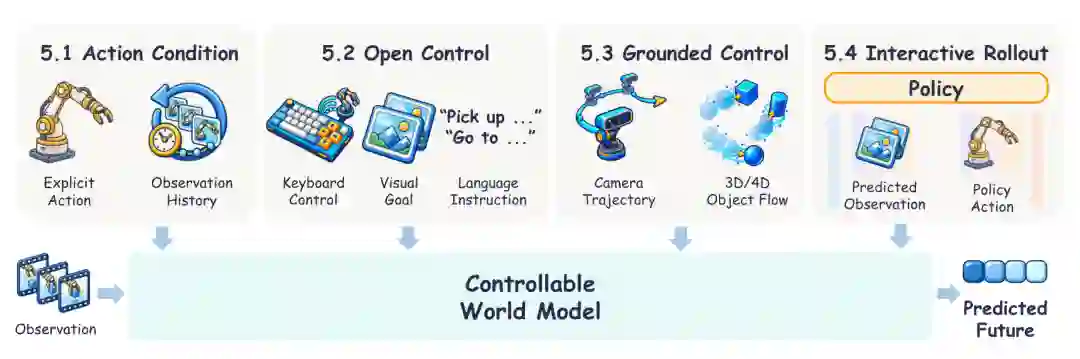
图3|可控干预层。控制从显式动作扩展到潜在、语言和目标接口,再落到可测量几何/物理变量,最终支持策略交互与动作生成。可控性要求实现变化匹配干预,同时未受影响的状态保持一致。来源:原文图4。
6. Actionable World Models | 具有行动效用的世界模型
6.1 规划、搜索与基于价值的选择
外部策略或提议器生成候选行为,世界模型预测后果,评分机制决定选择。搜索对象可以是动作、子目标、位姿或符号状态。WorldPlanner、STORM、DINO-WM 等分别探索搜索、候选策略和特征空间规划。 效用不只取决于平均预测误差,还取决于是否保留了决定候选排序的关键差异。每个候选都会消耗模型调用,因此必须在固定预算下报告成功、规划遗憾和延迟。
6.2 从想象中学习策略与解码动作
预测可以作为预训练目标提升样本效率,也可以把生成未来转换为动作,或通过未来嵌入约束策略内部表示。FLARE、JEPA-VLA 等体现无需显示未来的预测策略;DreamZero 等世界—动作模型连接两种输出。 ForeWAM、Fast-WAM 等研究进一步追问,收益来自训练时的预测结构,还是运行时显式想象。能否省去渲染未来,应由行为收益与延迟共同决定。
6.3 用于策略训练与评估的学习仿真器
在训练用途下,策略进入想象环境并依据奖励更新,要求模型对策略实际访问的状态保持可靠。在评估用途下,模型需要给出与真实执行一致的策略排序和结果估计。 WorldEval、WorldGym、WorldArena 等探索生成式评估与功能测试。重要边界是:训练策略的同一个模型不能单独为该策略提供独立认证,因为策略可能已经优化到模型误差上。需要真实结果、固定审计或独立验证信号。
6.4 运行时验证、纠正与恢复
论文区分四种逐渐增强的声明:诊断失败原因;在执行中检测失败;修改尚未发出的动作;回到可以继续任务的状态。只有报警不等于成功纠正,更不等于恢复。 CheckVLA 等比较预测与观察转移,FAWAM 等以末端力/力矩捕捉图像难以显现的接触错误。VLA-Corrector 等截断过时动作并生成后缀,CycleVLA 等则回退到早期子任务。预测残差因此成为控制信号,但必须及时到达,并统计误报、额外动作和恢复代价。
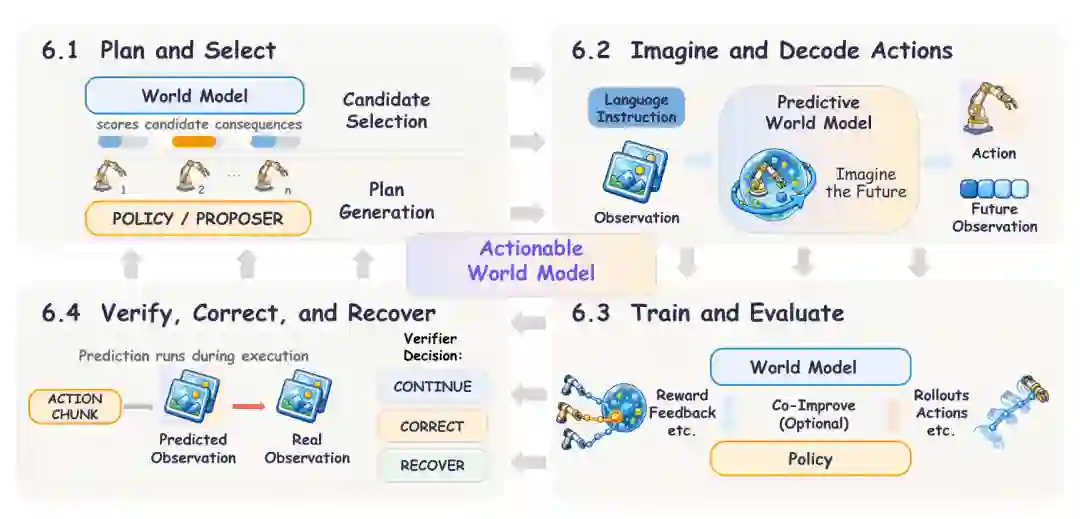
图4|行动效用层。预测可支持候选选择、动作解码、策略训练/评估,以及运行时验证、纠正和恢复。四个区域代表替代性的功能位置,不是必须串联执行的固定流程;箭头表示阅读顺序。来源:原文图5。
7. Four Improvement Loops | 四种改进闭环
7.1 数据闭环
世界模型通过获取、生成和筛选轨迹改变训练经验。DreamGen、GigaWorld-0 扩展合成覆盖,Dream2Fix 等生成配对失败与纠正轨迹,帮助补充成功示范缺少的监督。 一次生成数据不等于持续误差驱动采集。闭环应证明后续样本针对预测盲区,并用独立检查验证覆盖。典型失败是数据逐渐收缩到当前模型擅长生成的场景;有效性应按单位真实交互带来的留出能力提升衡量。
7.2 奖励与评论家闭环
预测被压缩为进展、可行性、回报或风险分数,用于提供密集反馈。RISE 将动力学和进展价值联系起来,世界模型式评论家则利用未来结构支撑价值估计。 危险在于策略学会满足评分器,而非完成真实任务。平均评分准确也可能颠倒最重要的两个候选,因此要在策略生成动作上检验预测评分与真实结果的排序和校准。
7.3 策略闭环
想象轨迹用于标注、练习、筛选或规划行为。World4RL、WoVR 和 WorldSample 等讨论如何使用不完美动力学,并选择哪些合成经验进入训练。 模型支持范围的门槛过严会丢弃有用经验,过松会接受不可信状态。应报告被接受的想象数据比例,并在匹配采样和计算预算下测量目标环境回报,避免只在模型内部改善。
7.4 模型自身闭环
预测误差或验证结果触发参数、状态、记忆或不确定性的修正。更强架构本身不是闭环,更新必须针对诊断出的弱点。RLVR-World、World Action Verifier 和 World-VLA-Loop 展示不同反馈路径。 模型与策略交替更新会让归因困难:模型看似更准,可能只是策略避开难预测状态;策略看似更好,也可能利用了新偏差。应同时检查诊断失败上的增益和固定审计集上的退化,持续改进需要多个更新周期的证据。
8. Embodiments and Domain Transfer | 具身平台与领域迁移
8.1 机器人操作
接触、摩擦、抓取位姿和力轨迹决定操作成败。触觉、点云和末端力预测使视觉难以表达的错误显现。长任务还要求诊断失败并找到可恢复状态。 测试应覆盖刚体与可形变物体、单臂与双臂、正常与扰动执行,并记录子任务进展,以区分规划失败、执行失败和恢复失败。
8.2 自动驾驶
道路几何、多智能体意图、交通规则和自车控制必须共同保持。多个安全未来都可能成立,因此单条记录轨迹的偏差不宜成为唯一标准,概率应覆盖可行未来并保留关键风险。 闭环报告应包括路线完成、碰撞、舒适度、违规、人工干预和延迟,罕见事件单独统计。生成式仿真器与真实道路行为的一致性,也是评测可信度的一部分。
8.3 导航与探索
导航要求地点和对象离开视野后,空间信念仍然稳定,并能处理回环和视觉混淆。未来可见性、可通行性和目标进展比地图画得多完整更直接影响行为。 基准应将地图准确度与导航效用分开:完整地图不一定带来更好选择,紧凑信念也可能足够支持目标到达和探索。
8.4 运动与控制
运动控制受控制时钟约束,关注短时域身体动力学、地形接触和稳定性。紧凑状态常比视频解码更合适,效用由回报、跌倒率、约束违反和地形适应衡量。 慢速视觉预测可服务高层规划,快速动力学模型负责底层反馈。分层系统需对齐状态时间戳和不确定性,并分别报告感知、预测、规划与控制频率。
8.5 哪些能力能够跨平台迁移
表示、动力学、动作语义和决策逻辑是不同迁移对象。对象恒存和自由空间可能较易共享,接触动力学需要考虑材料、工具和执行器差异;同一语言目标也不代表相同动作实现。 可采用三个协议:固定任务换机器人;固定机器人换对象、场景或动力学;同时改变二者。每项都应说明冻结和适配模块,以及消耗的真实转移数量。共享接口与测得迁移效果是两个声明。
9. Data, Benchmarks, and Evaluation | 数据、基准与评测
9.1 数据要求
轨迹应连接初始状态、观测、动作、时间及结果,还可包含目标、相机标定、深度、本体状态、力、声音、奖励、失败起点与恢复结果。RoboNet、Open X-Embodiment、BridgeData V2 和 DROID 提供不同动作对齐资源。 跨平台使用必须保留控制频率、坐标系和原始动作定义,归一化向量不自动构成共享干预。成功示范不足以训练恢复,应补充失败原因、可恢复状态、纠正动作和最终结果。可重置仿真器支持同状态不同动作的分支数据。
9.2 与能力对齐的评测协议
可信预测测试固定上下文下的未见轨迹,结合画质与对象、位置、深度、占用、接触等状态指标,报告漂移曲线、遮挡后记忆和不确定性校准。 可控干预测试从同一状态改变动作、时序、力或路径,并比较预测与执行。应保留未受影响区域的一致性,加入无动作、掩蔽、打乱和错误动作对照,以检验模型是否真正使用命令。 行动效用需要匹配基线。规划报告成功、遗憾、调用次数和延迟;强化学习报告真实回报、交互量和约束成本;策略评估报告真实结果排序相关性;验证报告精确率、召回率、误报与检测延迟;恢复报告条件成功、保留进展、耗时和安全违反。
9.3 基准设计原则
预测状态应尽可能在可执行环境中验证;同起点开放动作分支;画质与功能分开报告;扰动可重复;记录墙钟时间与模型调用。额外相机、特权状态和额外计算都应计入资源条件。 不确定性需按时域和动作检验,并报告固定覆盖率下风险。生成样本的多样性不等于可信不确定性:样本必须覆盖可行结果,并保留其风险关系。
10. Open Problems | 开放问题
10.1 持久状态与漂移
挑战是构建可修正的持久状态,在加入新观测时不重写已经一致的历史,并在隐藏信息无法确定时保持不确定性。遮挡—重现测试应同时追踪对象身份、位姿及质量、摩擦等物理属性,记录错误何时出现和能否修复。
10.2 动作的因果效应
专家会根据环境选择合适动作,使动作与结果存在混杂。模型可能复现常见结果却忽略命令。需要固定初始状态、单变量动作扰动和失败分支,并在跨机器人时同时检验高层意图与平台特定实现。
10.3 预算约束下的决策效用
动作响应正确的模型仍可能太慢,或错过改变候选排序的小差别。未来应研究保留价值、可行性和安全信息的决策压缩,并在固定计算预算下测试规划遗憾,比较视频、潜在、对象和三维接口何时有效。
10.4 联合落地
几何、物理和动作模块需要在状态、时间与不确定性上保持一致,而非仅拼接特征。应测试轴间冲突:空间可达但抓取不稳,物理可行但违反指令,或坐标系改变后动作失效。这比单独验证每个模态更能揭示接口问题。
10.5 不确定性与稳定闭环
策略更新会改变访问状态,让旧校准失效。低置信度时,系统需要明确采取缩短预测、保守评分、采集数据、切换策略或停止等行为。 四种闭环也可能让错误循环传播:合成数据带入伪影,评分器奖励伪影,策略进一步寻找伪影。应经过多个更新周期测量收益、退化、多样性和真实交互成本,并保留生成器不能查看的动力学与失败审计集。
10.6 评测、可获取性与可复现性
共同评测层可测状态稳定、干预一致、决策遗憾、校准与闭环效用,领域层再加入接触力、跌倒、地图或驾驶指标。真实实验应报告足够试验和不确定性,覆盖变异与罕见失败。 异步系统还需明确时间戳、已提交动作前缀、取消规则和延迟契约,测试可变推理时间与传感器延迟。复现材料应包含动作接口、数据过滤、计算预算、种子和失败案例;仅发布权重不足以复现能力声明。
11. Conclusion | 总结
世界模型对具身智能的价值,取决于预测如何改善行为。本文提出的三层能力,将状态一致性、干预保真度与下游效用分开;三乘四矩阵进一步说明预测内容如何进入持续学习与执行。 这套框架支持能力声明的定性比较,但不同文献的异质评测限制了直接性能比较。未来进展需要在明确的数据、计算与延迟预算下,证明落地预测能够改善闭环行为,并通过独立测试维持改进闭环的稳定性。 论文主页:https://arxiv.org/abs/2609.16697 原文 PDF:https://arxiv.org/pdf/2609.16697 项目页面:https://3dagentworld.github.io/EmbodiedWM/
 World Models for Embodied Intelligence: From Plausible to Controllable to Actionable


相关内容

 微信扫码咨询专知VIP会员