
综述|从模型到系统:高效多模态学习的全栈路线图
论文:From Models to Systems: A Comprehensive Survey of Efficient Multimodal Learning 作者:Pan Wang、Siwei Song、Hui Ji 等 15 位作者 来源:Transactions on Machine Learning Research(TMLR),2026;arXiv:2609.19445 原文链接:论文页面|PDF|网页版|持续更新的资料库
导读:多模态模型同时处理图像、文本、语音、视频和传感器数据,瓶颈不只在参数量。即使模型 FLOPs 下降,视觉编码等待、显存中的 KV 缓存、不同模态的内存带宽与设备调度,仍可能让实际延迟居高不下。本文整理 Pan Wang 等人的综述,依原文 1—9 节展开:先建立模型—算法—系统(MAS)三级框架,再讨论多模态大模型、应用基准、跨层协同与开放挑战。论文汇集 300 余项研究;本文的图均截取自论文,图内保留原英文,中文图题为阅读说明。研究综述中的复杂度和方法效果须结合具体任务、硬件与测量条件理解。
1 Introduction|引言
多模态效率问题
多模态学习不只是把几条单模态流水线拼起来。图像是高密度空间信号,视频与语音带有不同时间尺度,文本则是离散且语义密集的序列。理解任务可能输出一个类别或答案,生成任务还要持续解码;数据又可能成对、弱配对乃至彼此分离。因此,单纯缩小某个编码器,不能保证整套系统高效。 论文将高效多模态学习(EML)的目标归纳为:在能力与泛化不被不合理牺牲的前提下,压低计算、显存、延迟、能耗及部署成本。作者没有把来自不同硬件和任务的加速数字排成统一榜单,而是追问“效率注入在计算栈的哪里,层间如何相互作用”。
模型—算法—系统分类
MAS 框架给出三个相互关联的答案:模型层决定算什么,例如采用双塔还是统一编码器、是否使用专家稀疏路由;算法层决定怎么算,例如压缩 token、剪枝、量化、蒸馏、缓存与自适应退出;系统层决定何时何地算,例如显存管理、边云协作、流水线调度及软硬件协同。一个多模态应用通常同时跨越三层,效率收益也不能只归功于某个孤立模块。
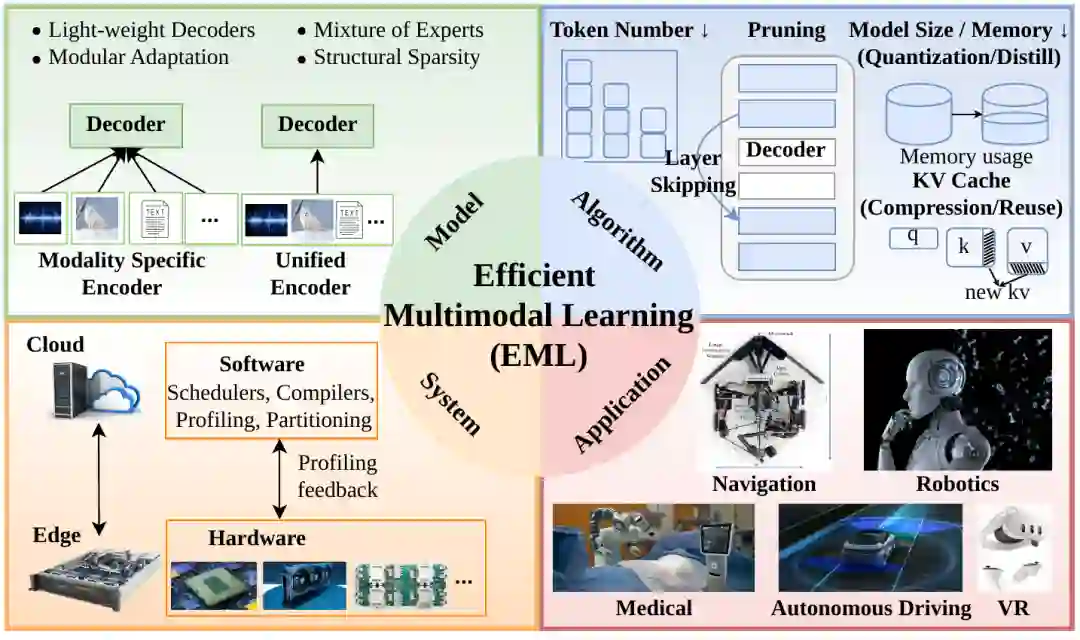
图1|高效多模态学习的总体图景。模型结构、算法压缩与系统执行三层共同支撑自动驾驶、机器人、医疗、虚拟现实等应用。图内英文保留自原文;图片来源:原论文图1。
综述范围与贡献
作者梳理 2020—2026 年间 300 余项工作,优先收录能说明 FLOPs、推理延迟、内存或能耗变化的研究;纯粹追求准确率提升的工作不作为本综述主线。论文的贡献是统一分类、分析纵向协同,以多模态大模型(MLLM)为案例观察演进,并为应用与未来研究提供路线图。它是一篇方法和系统视角的文献综述,不是在统一实验平台上重测所有方法的比较论文。
2 Model|模型层
模型层改变架构拓扑,核心是减少不必要的处理,同时保留模态对齐、交互和表达能力。
2.1 模态专用编码器
视觉、文本、语音等先各自抽取特征,再做跨模态交互,是传统且有效的设计。视觉侧从轻量 CNN、层次化视觉 Transformer 到状态空间模型,分别压低局部计算、全局注意力或长序列成本;视频需要处理大量相似帧,采用掩码建模、时序分层或轻量时空模块。音频从卷积声谱图编码器走向自监督预训练与离散语音 token,重点是把高采样率连续信号变成语言模型可消费的紧凑表示。 这类架构能利用各模态成熟的归纳偏置,但专业编码器越多,跨模态接口、存储和调度也越复杂。对低照度图像、稀疏深度数据或不规则时间序列,保留特定前端仍可能比强行统一更稳妥。
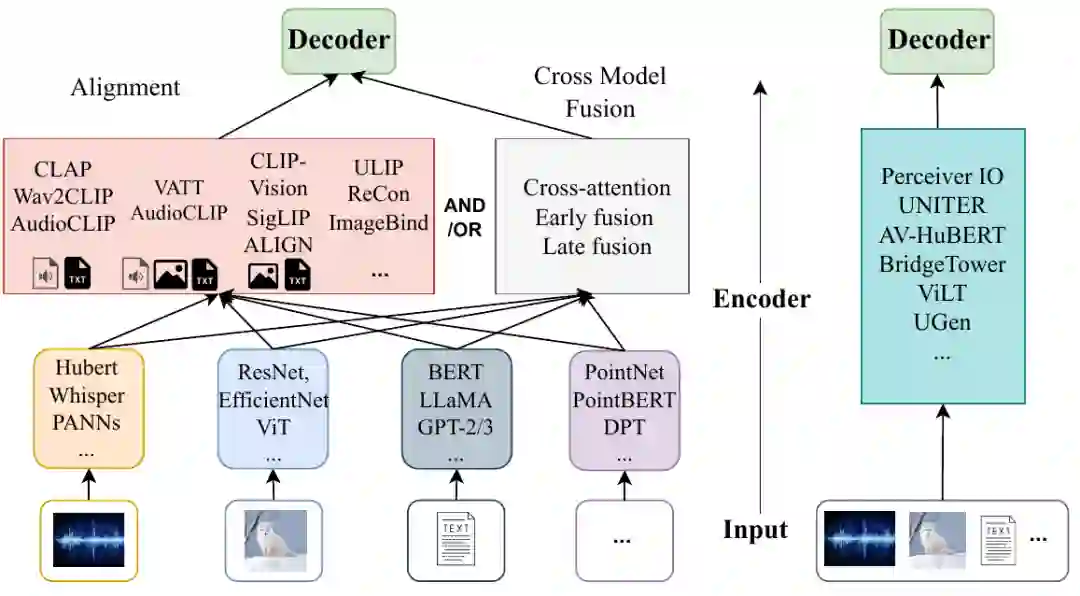
图2|模态专用流水线与统一编码器的结构对照。左侧通过独立编码与后期对齐/融合处理异构信号;右侧让多模态输入进入共享参数核心。图片来源:原论文图3。
2.2 统一多模态编码器
统一编码器试图让异构输入共享一个主干或潜在空间,减少并行分支的重复参数与基础设施。Perceiver 类方法用固定大小的潜变量承接不同长度输入;统一自回归方案则把图像、音频、视频转换为可混排的表征或 token,在共享序列目标下学习。这样有利于通用推理与跨模态生成,但前端编码、离散化误差、极长序列成本仍需单独处理。 论文强调两类结构不是“新旧优劣”的简单替换:模态专用编码器适合需要高保真局部细节的场景;统一核心更适合通用任务与跨模态交互。关键是把昂贵的感知流压缩到足够的信息密度,而不是仅仅减少模块数量。
2.3 结构稀疏
混合专家(MoE)通过路由只激活部分参数,使总容量与每次前向的活跃计算脱钩。多模态模型可按模态分派专家,也可按 token 内容、难度和预算动态分派。它适合视觉 patch 大量冗余、文本 token 相对密集的非对称输入。不过,路由偏斜可能造成专家失衡和表示碎片化,迁移到新模态时也未必保持零样本泛化。结构稀疏内嵌在模型设计中,区别于训练后直接剪去权重。
2.4 结构化解码
高分辨率感知特征若全部交给自回归语言模型,跨模态注意力与生成成本会快速上升。Flamingo 的重采样器和 BLIP-2 的 Q-Former 代表了“有限查询接口”思路:先用少量潜在查询从密集视觉特征提炼信息,再接入语言解码器。它能把计算规模与原始输入长度部分解耦,却也可能像信息瓶颈一样滤掉细粒度定位、文字识别等任务所需的高频细节。
2.5 模块化适配
投影层、Adapter 与 LoRA 把跨模态连接或新任务适配放到小模块中,使大骨干保持冻结。LLaVA 式投影器负责把视觉特征映射到语言空间,低秩更新则降低微调与存储成本。好处是快速扩展能力、部署多个任务版本;局限是过窄的适配空间可能无法吸收与原有表征正交的新知识。论文因此把模块化适配视为能力扩展与骨干维护解耦的手段,而非无损替代全量训练。
2.6 本层要点
模型层的演进主线是:从独立感知分支走向共享潜在核心,并以结构稀疏、受限接口和轻量模块管理不同模态的信息密度。最终评判仍应包括语义保真与泛化,不能只报参数量或理论复杂度。
3 Algorithm|算法层
算法层通常不彻底重画架构,而是调整信息流的长度、精度、稀疏性和复用方式。论文按原文分为七类。
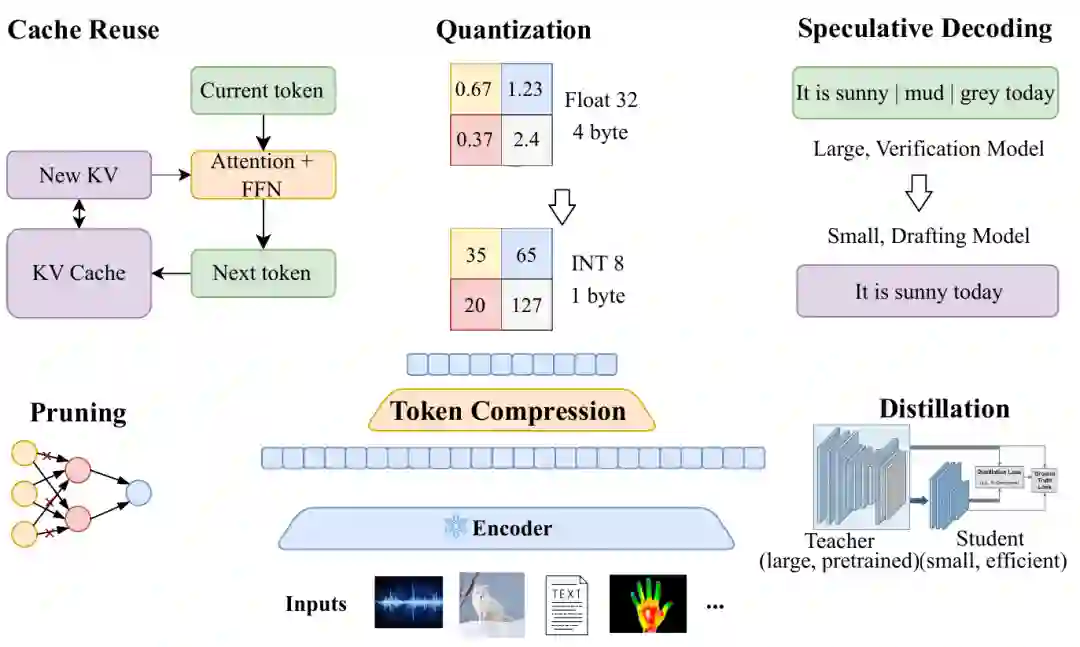
图3|算法层效率方法示意。原文列出的七条主线包括 token 压缩、剪枝、量化、蒸馏、提示与推测解码、缓存复用、运行时稀疏;图中用若干代表机制辅助理解。图片来源:原论文图4。
3.1 令牌压缩与选择性计算
视觉、视频和音频流常含大量相邻冗余,压缩目标应是保留任务相关的证据,而非机械地删去固定比例。免训练方法依据注意力、特征相似度或层间变化筛选和合并 token;训练式方法用可学习评分器、池化或聚类,在任务损失下学习保留哪些区域或片段。对于图表识别、细粒度目标或语音短瞬态,错删的代价远高于一般背景 patch。综述所引部分系统可大量删除视觉 token 并保持其设定下精度,但这一比例不能迁移为所有任务的默认阈值。
3.2 剪枝
参数剪枝删除权重、神经元、注意力头或层。非结构化稀疏可在理论上压低乘加次数,却常因不规则访存而没有对应的真实加速;结构化剪枝更容易映射到 CPU/GPU 的连续数据布局。多模态的难点是不同分支与对齐层敏感度不同,因此应按模态与组件分配剪枝率,并用跨模态任务检查是否破坏语义对应。
3.3 量化
量化把权重或激活映射到较低位宽,降低模型存储与内存带宽压力。多模态场景中,视觉、语音、文本特征的数值范围和离群点不同,统一位宽可能让某一模态失真,进而发生对齐漂移。后训练量化(PTQ)部署便捷;量化感知训练(QAT)在更激进低比特时通过训练适应量化噪声。方法如 Q-VLM、MBQ 采用模态敏感或混合精度策略。位宽变低不必然带来速度提升:还要看设备是否原生支持该格式,以及反量化和混合精度重排的成本。
3.4 知识蒸馏
大教师向小学生转移知识,论文进一步区分预测、表示和行为三类信号:对齐输出概率;匹配中间特征、注意力和关系结构;或迁移推理轨迹、偏好与决策过程。多模态蒸馏尤其需要保住视觉定位与语言推理之间的联系。只压缩最后答案,可能得到会模仿结论却不会可靠辨认图像证据的学生;加入空间或过程监督可缓解这一问题,但训练与教师查询也会增加成本。
3.5 提示与推测解码
连续提示或前缀微调只更新少量任务参数,降低适配存储和训练开销。推测解码则针对自回归生成的串行瓶颈:小模型先提出候选,大模型批量验证。在多模态情境中,共享视觉编码结果或缓存,可避免草稿模型与验证模型重复计算昂贵感知前缀。实际收益取决于候选接受率、验证批量与缓存共享,不能只看生成 token 数。
3.6 缓存与复用
KV 缓存随序列和并发量增长,长视频或连续语音尤其容易触及显存上限。算法层可根据重要度淘汰/合并 token,对静态背景跨帧复用,对重复前缀或相似请求复用历史状态。删除冗余视觉 patch 时,必须保护承载指令和关键语义的锚点;跨会话复用还要考虑位置编码、隔离与隐私边界。
3.7 运行时稀疏
与永久剪枝不同,运行时稀疏按输入难度决定执行深度和连接密度:容易样本提前退出,稳定的视频帧跳过部分层,复杂目标再动用完整路径。它能让计算资源跟随样本而非固定最坏情况分配,但需校准退出置信度,防止“看似容易”的高风险输入被过早终止。
3.8 本层要点
算法层的共同逻辑是尊重各模态的冗余不对称性:稀释冗余视觉/音频信息,同时保护稠密文本语义和跨模态锚点。理论 FLOPs、模型体积和真实服务延迟是不同指标,最终必须回到硬件和任务上测量。
4 System|系统层
当模型进入持续对话、实时视频或边缘设备,主要瓶颈会从算术运算转为显存、I/O、调度和数据移动。系统层把“可计算”变成“可交付”。
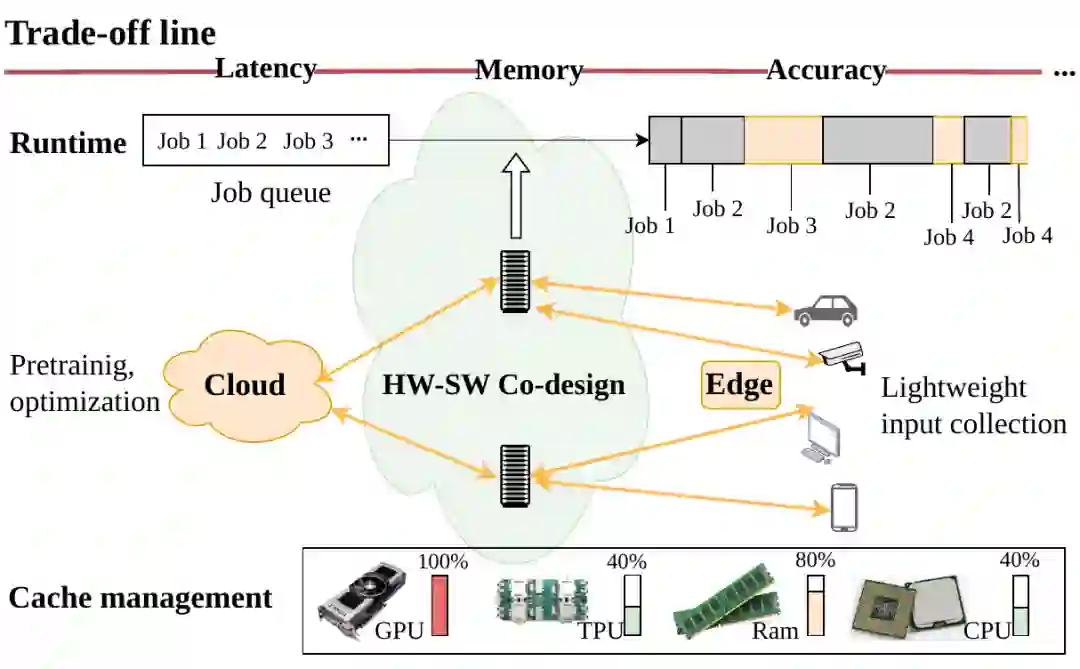
图4|系统层弹性资源编排。围绕 KV 缓存与服务、边云协作、延迟敏感调度、软硬件协同四条主线,将模型与算法层的理论收益转为实际吞吐和响应速度。图片来源:原论文图5。
4.1 缓存管理与服务
多请求并发时,KV 块的物理布局、碎片与冷热迁移直接影响最大批量和响应时间。动态缓存池按请求生命周期管理显存,跨会话共享前缀则避免重复预填充。论文提及面向长上下文的分层缓存与持续状态方案,重点不只是“把 KV 压小”,而是让它成为可调度、可复用的资源。评估时应同时报告峰值显存、吞吐、首 token 延迟及长尾延迟。
4.2 边云协作
边缘设备贴近传感器、响应快,却受功率和计算限制;云端推理强,但上行带宽与隐私约束更严。典型做法是边端先筛帧、提特征、处理简单样本,再把不确定或复杂请求上送;云端更新能力后回传轻量适配。这里的效率包含通信量、断网可用性和数据暴露,不只是两台设备上的 FLOPs 相加。
4.3 延迟感知调度与流水线
视觉编码和语言预填充往往耗时不同,串行执行会让某一计算单元等待另一模态。异步流水线可交错不同请求的编码、预填充和解码;按任务复杂度分层路由可满足服务等级约束。综述引用 RServe 的同设置实验说明并行编排可提升吞吐,但加速倍率不能脱离硬件、负载和批量条件复用。
4.4 软硬件协同设计
算子需求不同:某些大矩阵乘法受计算单元限制,高分辨率特征与注意力则可能受带宽限制。软硬件协同把不同模态的算子映射到合适处理器,尽量减少数据搬运;也可把实际延迟、能耗和峰值内存纳入架构搜索。若某个 3-bit 格式或非规则稀疏在目标设备上没有原生支持,论文里的理论压缩就未必是部署收益。
4.5 本层要点
系统层不是前两层做完后的“工程收尾”。它反过来约束模型拓扑和算法形式:能被融合的核、规则的数据布局、可共享的缓存,往往比纸面上更低的运算量更重要。
5 Efficient MLLMs|高效多模态大模型
5.1 从模型到系统的演进
论文以高效 MLLM 为 MAS 的综合案例。早期 BLIP-2、LLaVA 等聚焦冻结骨干与轻量接口,解决跨模态对齐训练成本;随后关注视觉 token、KV 与生成延迟,通过压缩和动态执行控制运行成本;近年更强调端云分工、缓存共享、服务调度与硬件适配。这个时间线反映研究焦点的迁移,不是说早期模型已过时,也不等于每个新方法仅属于一个层级。
图5|代表性高效 MLLM 的时间线。原图按主要优化层级标色:绿色为模型层、蓝色为算法层、橙色为系统层。它用于观察研究主题变化,不代表完整模型清单或统一性能排名。图片来源:原论文图6。
5.2 纵向协同
稀疏专家使总容量与活跃计算分离;紧凑视觉编码需要能接住它的算子与调度;缓存复用必须与 token 筛选、位置处理相容。作者把这类架构—执行—系统联合设计视作下一阶段重点。所谓自调节计算,是根据输入难度、实时预算与设备状态动态决定“算什么、怎么算、在哪里算”的研究方向,而非已经普遍实现的产品能力。
6 Applications and Benchmarks|应用与基准
6.1 情感计算
语音、表情与文本共同提供情绪线索,响应必须及时,还涉及敏感个人数据。轻量适配、动态片段筛选、端侧推理应一起评估;常用基准包括 CMU-MOSI、CMU-MOSEI、IEMOCAP。对短促情绪变化不能过度压缩。
6.2 具身智能与机器人
视觉—语言—动作闭环受感知到执行延迟约束。应优先保持动作相关的视觉细节,并把高成本编码与动作解码流水化;R2R、ALFRED、Ego4D 等分别覆盖导航、指令执行或视频活动理解。真实机器人还需关注功率和安全失误,不应只看离线准确率。
6.3 媒体理解与生成
长视频和连续音视频的瓶颈是时空冗余与上下文显存。关键帧/片段选择、缓存复用和冷热状态分层尤其重要。Video-MME、MVBench 等能测理解能力,但完整服务评测仍应补上输入时长、峰值显存和流式延迟。
6.4 医疗健康
医学影像、报告、语音和传感器数据要求细节保真、可解释与隐私保护。过激量化或 token 筛选可能漏掉微小病灶;本地部署与联邦协作降低原始数据集中风险,但不能替代诊断校验。MIMIC-CXR、IU-Xray 等只覆盖部分任务情境。
6.5 空间理解
自动驾驶和三维场景处理相机、雷达、点云及定位信号。把稀疏 3D 点云组织成鸟瞰图等紧凑结构,可改善计算布局,但同步和几何精度必须保留。nuScenes、Waymo Open Dataset 等基准应与车载硬件的端到端延迟、能耗共同看。
6.6 多模态推理
图表、视觉问答、数学和科学问题不仅要“看见”,还要逐步验证。模块化感知与程序化工具调用可把昂贵推理留给真正困难的子问题;VQAv2、ScienceQA、MathVista、ChartQA 关注能力侧,部署侧还要核算每题延迟及错误路径代价。
6.7 联邦学习
多医院或多设备合作训练时,可只同步提示、适配器等小参数,而非上传原始数据或完整模型。缺失模态与设备异构会影响对齐;本地保存数据也不自动等于隐私安全,仍需差分隐私、安全聚合和攻击测试。论文以 FedMultimodal、Med-MMFL 等作为相关评测资源。
7 Holistic Discussion|整体讨论与应用策略
7.1 纵向协同机制
跨层收益并非三项单独加速的简单相加。统一编码器改变了量化、剪枝面对的特征分布;结构化稀疏便于硬件核利用;算法压缩只有与内存布局、缓存生命周期匹配,才可能变成真实壁钟时间优势。这也是论文最有实践价值的判断:把 FLOPs 优化置于完整执行链中验证。
7.2 面向应用的策略
对机器人、自动驾驶等延迟优先任务,重点是边端感知过滤、流水线重叠和稳定的最坏情况时延;对医学影像等保真与隐私优先任务,应保护关键通道精度、审核压缩引起的细节损失,并用受控协作降低敏感数据流动;对云服务等吞吐优先任务,稀疏专家、共享状态与显存池有更大价值。最优方案是具体约束下的效率—效用—隐私折中,而非一套固定技巧。
7.3 走向自调节智能
论文展望系统把成本和设备状态纳入自身决策,按不确定性动态调节输入粒度、计算深度和执行位置。要从愿景走向可靠部署,还需要成本可观测、策略可校准,并对高风险样本设置不随意退出的约束。
8 Open Challenges and Future Directions|开放挑战与未来方向
8.1 跨模态统一表征
图片、声音、视频和文本不必全部强行转成同一种离散词元,但它们需要可共享的语义接口和可控的序列长度。未来方向包括连续潜空间、共享码本、可变速率压缩,以及让分词/切片策略与缓存调度共同设计。
8.2 多任务泛化与稳健性
在视觉—语言任务上省算,不代表缺失音频、换传感器或跨领域时仍有效。需要检查模态缺失、分布偏移和任务切换条件下的能力与资源曲线,避免优化只适配某个数据集。
8.3 软硬件协同与部署
交叉注意力、动态模态切换和稀疏路由,对编译器和加速器提出不同于纯文本模型的要求。亟须硬件友好的稀疏模式、融合算子及端云弹性编排,让算法节省真正落到设备上。
8.4 以人为中心的效率
用户感知的首响应时间、交互流畅性和延迟尖峰,与平均吞吐同样重要。对某些任务,轻微且不可察觉的精度退让可能换来更好的实时体验;但公平性和可解释性不能被纯资源指标掩盖。
8.5 隐私与安全
端侧部署减少数据上云,不代表免于模型提取、侧信道或物理篡改。压缩也可能改变攻击面。效率、效用与隐私应共同建模;医疗影像和声纹等敏感模态尤其不能把“本地运行”直接等同于“合规安全”。
8.6 标准化评测
FLOPs、参数量只能描述局部成本,还应报告真实端到端延迟、首 token 时间、尾延迟、峰值显存、带宽、每次推理能耗、跨模态同步开销和任务质量。不同应用要在共享任务协议下给出硬件、批量与流式条件,避免把不可比数字当成统一榜单。论文希望形成类似多模态效率版 MLPerf 的部署感知评测。
9 Conclusion|结论
这篇综述把高效多模态学习从“压缩某个模型”的问题扩展为完整计算栈设计:模型层规定结构,算法层管理信息流,系统层兑现性能。MLLM 演进、应用差异及挑战都指向同一个结论:只有跨层协同,才能在实际设备和隐私约束下取得可靠效率。它提供的是分类与设计路线图;具体方法是否优于另一方法,仍需在同一任务、硬件和预算下实测。
Broader Impact and Appendices|影响与附录
原文的社会影响讨论同时指出两面性:效率研究可降低高能力模型的使用门槛与能耗,但也会降低滥用成本;边缘智能减少传输,却增加本地攻击暴露。附录 A 给出边缘系统案例,附录 B 汇总近期高效多模态模型,附录 C 比较已有综述。本文为控制篇幅不逐表转录,完整文献与附录请查阅文首 PDF 和项目资料库。
 From Models to Systems: A Comprehensive Survey of Efficient Multimodal Learning


相关内容

 微信扫码咨询专知VIP会员