
**
**
ACL 2026 杰出论文奖 | PALU:在关键前缀上最大化局部熵,让大模型精准“失忆”
导读
大语言模型在海量语料上进行训练,也不可避免地记住了其中的隐私信息、版权内容和其他敏感知识。当数据所有者要求删除相关信息时,重新收集数据并从头训练模型通常成本高昂。因此,如何在不重新训练模型的情况下,消除指定数据对模型行为的影响,成为大模型安全与隐私研究中的重要问题。 这类技术通常被称为大语言模型遗忘学习(LLM Unlearning)。理想的遗忘方法需要同时满足两个目标:一方面,模型不再生成与目标数据相关的内容;另一方面,模型原有的语言理解和生成能力应当尽可能保持不变。 然而,现有方法往往通过对完整回答进行负向优化,或者在整个词表上提高预测不确定性。这种“全序列、全词表”的干预方式虽然能够削弱目标知识,却也会更新大量与敏感信息无关的内容,容易造成模型能力下降和训练资源浪费。 针对这一问题,中国科学技术大学与新加坡国立大学的研究团队提出了 PALU(Prefix-Aware Localized Unlearning,前缀感知局部遗忘)。该工作从生成过程的时序维度和词表维度同时引入局部化约束,只对真正决定敏感内容生成的少量位置进行干预。
论文信息
**论文题目:**Maximizing Local Entropy Where It Matters: Prefix-Aware Localized LLM Unlearning **论文链接:**https://arxiv.org/abs/2601.03190 **会议:**ACL 2026 **作者:**Naixin Zhai, Pengyang Shao, Binbin Zheng, Yonghui Yang, Fei Shen, Long Bai, Xun Yang **代码:**https://github.com/nxZhai/PALU **关键词:**LLM Unlearning, Machine Unlearning, Sensitive Knowledge Removal, Localized Optimization
1. 大模型遗忘,真的需要修改整个回答吗?
**
**
目前许多梯度式大模型遗忘方法都建立在负交叉熵目标之上。模型正常训练时,会最小化交叉熵损失,提高正确目标词元的生成概率;而在执行遗忘时,Gradient Ascent、NPO等方法反向操作,通过降低目标回答的生成概率,使模型逐渐“不再相信”原来的答案。这一思路直观,但存在两个问题。 **第一个问题是,降低目标词元的概率,并不等价于让模型真正变得不确定。**假设模型原本会以很高概率生成一个敏感实体。负交叉熵目标只负责压低该实体对应词元的概率,却无法控制被压低的概率质量流向哪里。模型可能只是将概率转移到另一个同义词、相关实体或者语义相近的表达上。换言之,模型忘掉的可能只是某一种表述,而没有忘掉背后的语义概念。 **第二个问题是,现有方法的干预范围通常过大。一个包含敏感知识的回答中,并不是所有词元都属于敏感信息。**大量介词、冠词、连接词以及句式成分只承担一般性的语言组织功能。如果在完整回答上执行负向优化,这些通用词元也会被一并更新,从而损害模型的语言流畅性和通用能力。类似地,在词表维度上,下一词元生成通常只由少数高概率候选主导。对数万甚至十余万个长尾词元同时进行优化,对最终解码行为的影响很小,却会引入额外计算和参数扰动。 PALU由此提出一个核心问题: 为了切断敏感内容的生成路径,我们究竟需要干预多少词元、多少词表维度?
**
**
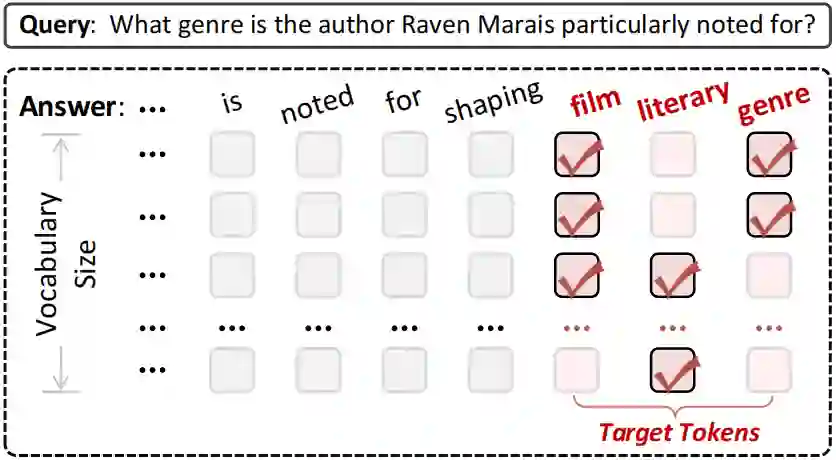
图1 局部优化示意图 图1直观展示了PALU的基本思想:在序列维度上只选择敏感词元,在每个敏感位置上又只优化Top-K高概率候选,而跳过无关词元和长尾词表维度。
2. PALU的核心发现:敏感生成具有“双重稀疏性”
**
**
PALU 重新从干预效率的角度理解大模型遗忘。对于一个输入问题 x 和敏感回答 y,遗忘的本质并不一定是破坏回答中的所有词元,而是打断模型从问题到敏感回答的生成轨迹。研究团队发现,这一生成轨迹同时具有时序稀疏性和词表稀疏性。
时序稀疏性:切断敏感前缀即可改变后续生成
**
**
大语言模型采用自回归方式逐词生成文本。每个新词元都会以前面已经生成的内容作为条件。 因此,在敏感实体或敏感事实开始出现时,前几个词元往往承担着“启动语义”的作用。一旦这些起始词元发生变化,后续生成过程也会随之偏离原来的轨迹。 例如,在生成一个人物姓名时,模型一旦在姓氏或名称前缀处选择了不同词元,后续名字、身份和背景描述通常都会发生改变。 PALU 将敏感片段中的词元进一步划分为三类: 1. 起始目标词元(Initiating Targets):敏感片段最前面的若干词元,是主要遗忘对象; 1. 通用词元(Common Tokens):与敏感知识无关,通过KL散度约束维持原有分布; 1. 冗余敏感词元(Redundant Sensitive Tokens):位于敏感片段后部,但不再参与遗忘优化。
这意味着,PALU 并不需要优化整个敏感实体,更不需要优化完整回答,只需干预每个敏感片段最前面的 N 个词元。
词表稀疏性:真正影响解码的只是Top-K候选
**
**
在词表维度上,模型虽然会为整个词表计算概率,但实际生成决策主要由概率最高的一小部分候选决定。长尾词元的概率本身已经很低。即使继续对它们进行熵最大化,也很难改变最终生成结果。因此,PALU 只在冻结参考模型选出的 Top-K logit 上执行局部熵最大化,而不要求整个词表分布趋于均匀。时序维度上的敏感前缀,与词表维度上的 Top-K 候选,共同构成了 PALU 的“双重局部化”设计。
3. 方法设计:在真正重要的位置最大化局部熵
**
**
PALU的整体流程可以概括为三个步骤:首先识别回答中的敏感内容;随后定位敏感片段的起始词元,并在这些关键位置上执行局部熵最大化;最后在非敏感词元上约束模型保持原有预测分布,从而减少遗忘过程对通用能力的影响。
识别回答中的敏感片段
**
**
首先,PALU 需要判断回答中的哪些部分真正包含待遗忘的信息。在一段包含敏感知识的回答中,并不是所有词元都与目标知识直接相关。例如,一个回答可能同时包含人物姓名、身份描述以及大量连接词、介词和通用句式。传统方法通常会对完整回答进行负向优化,从而将这些与敏感知识无关的语言成分一并修改。 PALU 则首先借助语言模型或人工标注识别回答中的敏感跨度,将每个词元划分为敏感词元和通用词元。具体实现中,论文使用 GPT-4o 模型辅助识别敏感片段,并沿用已有的目标词元标注协议进行人工复核。最终,两个实验数据集上的敏感跨度识别准确率均超过98%。 在获得完整的敏感片段后,PALU并不会对其中所有词元进行遗忘,而是进一步选取每个敏感片段最前面的少量词元,将其作为真正需要干预的“起始目标”。其余位于敏感片段后部的词元不参与遗忘优化。原因在于,自回归语言模型的后续输出依赖前面已经生成的内容。一旦敏感片段的生成入口被改变,后续内容通常也会随之偏离原始轨迹。
在Top-K候选上执行局部熵最大化
**
**
确定敏感片段的起始位置后,PALU进一步考虑应该干预词表中的哪些候选词元。大语言模型在每个生成位置上都会为整个词表计算预测分数,但真正影响下一词元选择的,通常只是概率最高的一小部分候选。大量长尾词元的概率本身已经非常低,即使继续调整这些词元,也很难改变最终生成结果。 因此,PALU首先使用冻结的参考模型,找出当前敏感位置上概率最高的Top-K候选词元。随后,方法只对这些高概率候选执行局部熵最大化,使它们之间的预测分数更加接近。这一过程可以理解为:模型原本可能对某个敏感词元表现出极高置信度,PALU则主动削弱这种过度集中的偏好,使模型无法明确决定应该生成哪一个候选。与仅压低目标词元概率的方法相比,Top-K局部熵最大化不仅能够抑制原始答案,还能够同时覆盖同义词、相关实体和语义相近的替代表达,避免模型将概率简单转移到另一个敏感候选上。 与此同时,PALU不会要求整个词表都达到均匀分布,而只处理真正影响解码结果的关键候选。这既保留了原有词表结构,也减少了无效优化带来的计算开销和参数扰动。
保护模型的通用语言能力
**
**
仅在敏感位置执行遗忘仍然可能使模型的整体预测分布发生偏移。为了避免模型在遗忘目标知识的同时损害正常语言能力,PALU还引入了保留约束。对于回答中的非敏感词元,PALU要求遗忘后的模型尽量保持与原始参考模型一致的预测分布。 换言之,敏感位置负责“忘记”,通用位置负责“保持”。这种设计将遗忘目标和能力保护目标明确分离:在敏感片段的起始词元上,模型通过局部熵最大化降低对敏感内容的确定性;在普通词元位置上,模型则通过分布约束维持原有语言知识和生成能力。从优化范围来看,传统方法通常需要处理完整回答中的全部词元,并在每个位置上干预整个词表。PALU 则只在少量敏感前缀位置上处理Top-K高概率候选,大幅缩小了实际需要更新的范围。 因此,PALU 的核心并不是简单地降低遗忘强度,而是将有限的优化集中到真正决定敏感内容生成的位置上,实现更加精准和高效的模型遗忘。
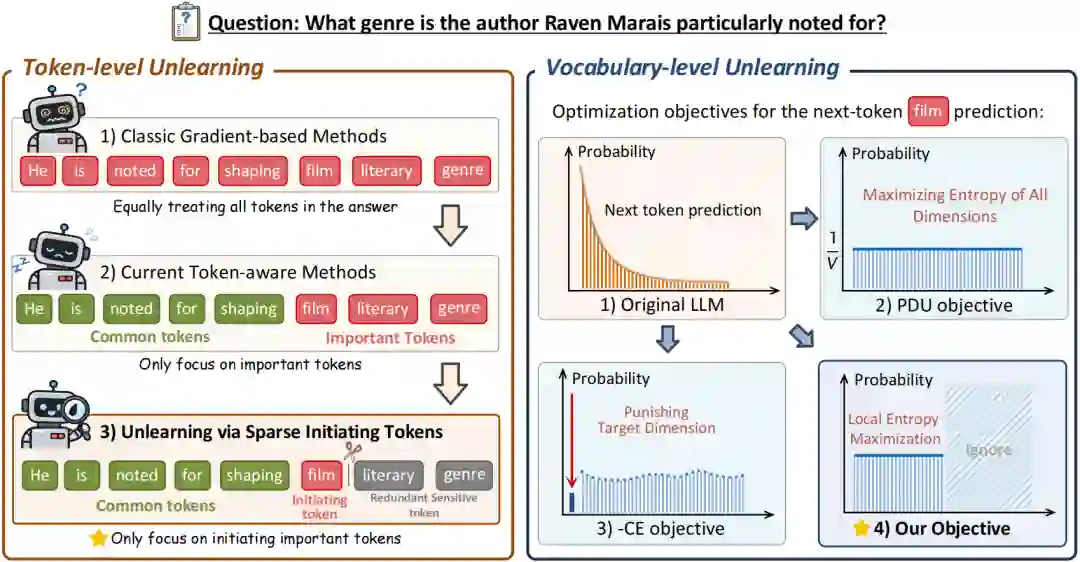
图2 PALU双重局部化对比图 该图可以直观展示PALU在两个维度上的局部化设计:在序列维度上,只选择敏感片段的起始词元;在词表维度上,只优化概率最高的Top-K候选。同时,非敏感词元通过分布约束维持模型原有能力。
4. 实验设置
**
**
研究团队在两个互补的大模型遗忘基准上开展实验。第一个是 TOFU。该数据集包含200名虚构作者及其问答信息,并设置了1%、5%和10%三种遗忘比例,适合细粒度分析模型对指定事实的遗忘程度。第二个是 MUSE。该数据集包含News和Books两个真实文本场景,重点考察模型的逐字记忆、知识记忆和隐私泄露风险。实验使用 Llama-2-7B 和 Llama-3.1-8B 作为主要骨干模型,并与 GA、GD、DPO、NPO、SimNPO、PDU 和 TPO 等方法进行比较。
5. 实验结果:遗忘效果和模型效用能否兼得?
**
**
PALU取得更好的遗忘—效用平衡
**
**
在 TOFU 的 5% 遗忘设置上,PALU 在 Llama-2-7B 和 Llama-3.1-8B 上均取得了最高的 Forget Quality。在 Llama-2-7B 上, PALU 的 FQ 达到 0.7126,相比 TPO 的 0.6284 提升约 13.4%;其 MU 达到 0.6238,接近仅使用保留数据训练得到的理想 Retain模型 0.6266。在 Llama-3.1-8B 上,PALU 的 FQ 达到 0.9238,而 TPO 为 0.7216,相对提升约 28.0%。与此同时,PALU 仍然保持了 0.6162 的 MU。这一结果说明,PALU 并不是通过大幅破坏模型能力来实现遗忘,而是在尽量保留通用能力的同时,使模型行为接近“从未学习过目标数据”的理想状态。
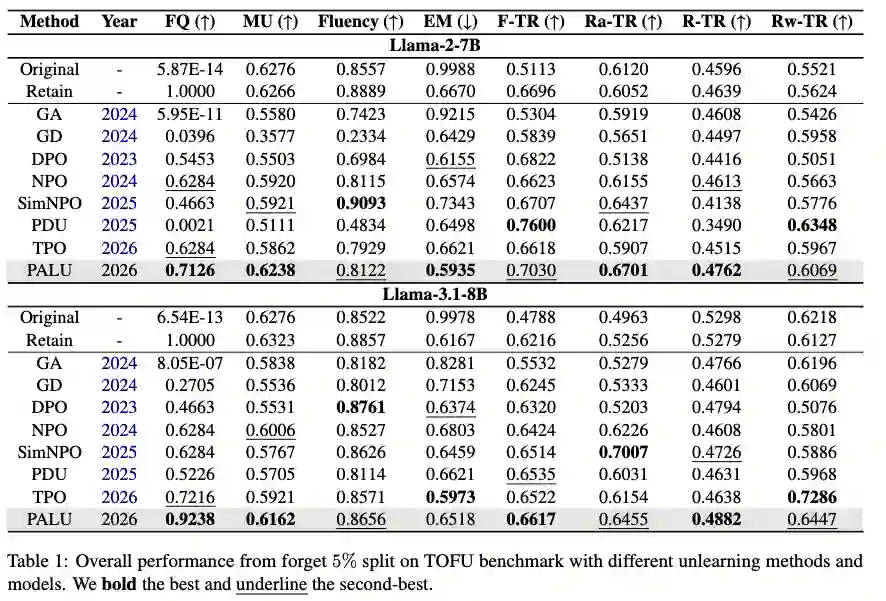
表1 TOFU 5%设置总体实验结果
在不同遗忘比例下保持稳定
**
**
论文进一步在 TOFU 的 1% 和 10% 遗忘设置上比较不同方法。从 FQ 与 MU 的二维分布来看,PALU在不同模型和遗忘比例下都更接近Retain模型。特别是在更具挑战性的 10% 遗忘设置中,NPO、DPO等方法的模型效用或遗忘质量出现明显下降,而PALU仍能维持较稳定的平衡。
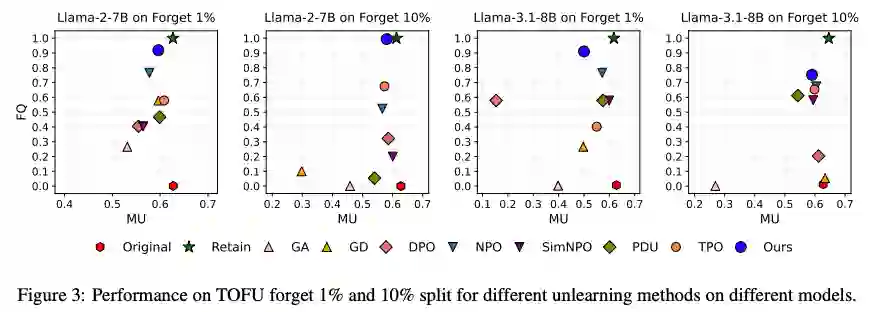
图3 不同遗忘比例下 FQ 与 MU 关系图 6. 为什么“少改一点”反而效果更好?
**
**
Top-1并不足以实现稳定遗忘
**
**
当PALU只优化概率最高的一个候选,即 K=1 时,模型效用出现严重下降。 其原因在于,大语言模型的语义表达具有明显冗余性。压低一个词元后,概率可以迅速转移到同义词或相关候选,迫使优化过程不断进行更激烈的参数更新。随着 K 增大,模型表现快速恢复,并在 K=5000 左右趋于饱和。继续扩大到完整词表并没有带来明显的遗忘收益。这一现象说明,稳定遗忘既不能只压制Top-1,也没有必要处理完整词表。覆盖主要语义候选的关键子空间已经足够。
前缀敏感词元基本足以切断生成路径
**
**
在时序维度上,仅处理一个词元仍然过于激进,难以稳定改变敏感生成轨迹。当起始预算增加到 N=3 时,FQ 和 MU 基本达到稳定。继续扩大到四个词元乃至整个敏感片段,没有获得明显额外收益,反而增加了计算和能力损伤风险。
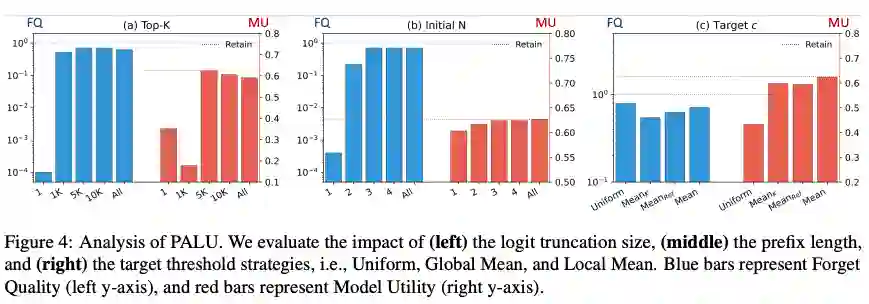
图4 Top-K、Initial-N及目标值c的消融实验
全局均值是更稳定的logit目标
**
**
PALU还比较了均匀分布、Top-K均值、参考模型全局均值和当前模型全局均值等不同目标值。实验发现,直接强制整个局部概率分布达到严格均匀状态约束过强,会破坏logit原有的结构。相比之下,将Top-K敏感峰值拉向稳定的全局均值,可以将敏感信号“埋入”模型的背景分布,同时避免显著扭曲整体概率流形。因此,论文最终采用全局均值作为标准目标值。
7. PALU不仅遗忘得更好,收敛也更快
**
**
在训练效率方面,PALU 与 NPO 呈现出明显不同的收敛行为。PALU的模型效用在约两个 epoch 内快速恢复,Forget Quality 在第五个 epoch 左右趋于稳定。相比之下,NPO 存在较明显的预热阶段,需要接近两倍的迭代次数才能达到较高的遗忘质量。这意味着,除了减少词元和词表维度上的梯度范围外,PALU 还能够通过更明确的优化目标缩短训练周期。
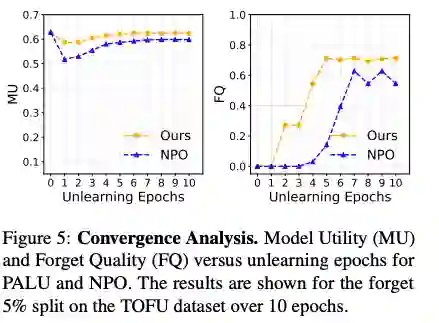
图5 PALU 与 NPO 的收敛曲线 8. 总结与展望
**
**
PALU给出了一个简洁但重要的结论:
有效的大模型遗忘,并不需要在所有位置制造混乱,而应当在真正决定敏感内容生成的位置制造不确定性。
**
**
在时序维度上,PALU只干预敏感片段最前面的少量词元,通过改变生成入口切断后续敏感轨迹。在词表维度上,PALU只平坦化Top-K高概率候选,防止目标概率简单转移到同义词或相关表达,同时保留长尾词元和通用语言结构。 这种“双重局部化”使PALU取得了更好的遗忘质量与模型效用平衡,并表现出更快的训练收敛速度和更强的成员推断攻击防御能力。从更广泛的角度看,该工作也提示我们:大模型行为控制不一定需要大范围参数破坏。通过分析自回归生成中的因果起点和解码关键子空间,可以用更小、更有针对性的干预改变模型行为。 目前,PALU主要针对纯文本大语言模型。对于多模态模型,视觉patch序列中是否存在类似的“敏感前缀”、跨模态词表中的关键候选应当如何定义,仍有待进一步研究。
 Maximizing Local Entropy Where It Matters: Prefix-Aware Localized LLM Unlearning


 微信扫码咨询专知VIP会员